


SGLang 源码完全拆解(六):Overlap Scheduler 如何重叠 CPU 调度与 GPU 执行
从 KV 所有权走向在途执行
前五篇已经把 SGLang 的请求主线推进到物理 KV 所有权:入口层把协议请求变成 token,Scheduler 维护 waiting/running 状态,PrefillAdder 决定哪些请求能进入本轮,ReqToTokenPool 与 RadixCache 再把逻辑序列映射到共享的物理 KV 槽。到这里仍暗含一个方便但昂贵的假设:CPU 只有等本轮 GPU 前向、采样和结果拷回全部结束,才开始准备下一轮。
这个假设保证时序直观,却会在每个 decode step 之间留下空隙。一次 Transformer decode 也许只需数毫秒,CPU 仍要完成请求过滤、停止条件判断、前缀树操作、KV 页分配、batch tensor 构造和 Kernel launch。若这些动作串在 GPU 前向之后,几百个输出 token 会把同一段固定开销重复几百次。模型越小、batch 越小或张量并行度越高,单轮 GPU 时间越短,CPU 气泡所占比例反而越大。
SGLang 团队在 2024 年 12 月发布 v0.4 时把这条路径称为 Zero-Overhead Batch Scheduler,并默认启用 overlap schedule。它的目标不是让 CPU 工作消失,而是让 CPU 在 batch 的 GPU 前向期间准备 batch ,把可并行的主机开销藏进设备计算窗口。官方基准在 Llama 3.2 3B、H100 的指定设置下报告相对 v0.3 约 1.1 倍吞吐提升;这个数字只说明该工作负载中气泡确实可见,不能当作所有模型的固定收益。
本文继续使用系列前文相同的固定提交 d88d5c325ad1cf28f2b804edcd8886e891a8f9b8。当前实现已比 v0.4 初版复杂得多:普通 decode、mixed chunk、结构化输出、投机解码、Mamba、分层缓存和多种并行模式都会经过同一条重叠基础设施。为了先抓住稳定不变量,主线限定为单 GPU、普通自回归生成、无投机解码;高级分支只在它改变同步边界时解释。
上一篇留下的核心问题由此变得具体:GPU 仍在读取上一轮页表时,CPU 能否回收 KV 页?上一轮 token 尚未回到 Python 时,下一轮的 input_ids 从哪里来?请求已经在设备上多算了一步,但 CPU 刚刚判定 EOS,又该如何结算?Overlap Scheduler 的难点不是“多开一条 stream”,而是把每个状态分成已计划、已发出、已物化和已提交四个时刻。
串行调度为什么会让 GPU 等 CPU
关闭 overlap 后,event_loop_normal() 的骨架十分直接:接收请求,形成 batch,同步执行,再立刻处理结果。
while True: ingest_requests() plan = get_next_batch_to_run(running_batch, last_batch) batch = plan.batch_to_run
if batch: result = run_batch(batch) process_batch_result(batch, result)
last_batch = batch这里的 run_batch() 不只是提交一个 CUDA Kernel。它会准备 ForwardBatch,运行模型与采样,并把下一 token、logprob 等结果转到 CPU 可读取的位置。process_batch_result() 再把结果写入 Req.output_ids,判断 EOS、长度与 stop token,发送流式输出,checkpoint 有效 KV,释放完成请求并更新指标。直到这些动作结束,循环才重新进入 get_next_batch_to_run()。
把第 轮 GPU 时间记为 ,CPU 结果处理与下一轮调度时间记为 ,忽略首尾启动开销,串行执行 轮的时间近似为:
GPU 利用率的理想化上界为:
如果 decode 前向是 3 ms,而 CPU 每轮暴露 1 ms,哪怕 Kernel 本身已经很快,设备利用率上界也只有 75%。这里的 1 ms 不是某个单一函数造成的:Python 队列遍历、Radix tree 匹配、页分配、小 tensor 构造、H2D/D2H 同步和采样后处理都可能贡献几十到几百微秒。优化一个函数之后,剩余动作仍会形成串行尾巴。
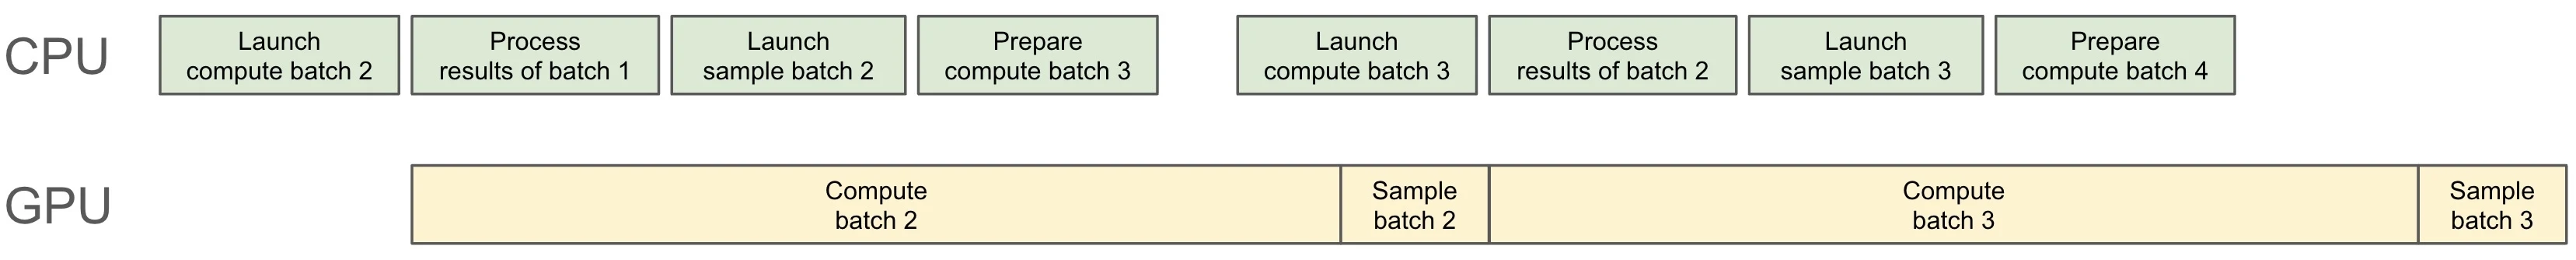
图源:SGLang v0.4 官方发布文章。绿色块是 CPU 的 launch、结果处理、采样发射与下一批准备,黄色块是 GPU 计算与采样。关键不在某两个方框恰好并排,而在依赖关系被重新切开:CPU 不必先得到 batch 的完整 Python 结果,才能描述 batch 的大部分设备工作。
理想的单步流水线把总时间改写为近似:
当每轮 时,中间 CPU 开销被全部隐藏;当 时,仍会暴露 的尾部。因此 “zero-overhead” 描述的是时间线上的可见开销接近零,不是 Scheduler 不再消耗 CPU。它也解释了收益边界:长 prefill 或大模型 decode 的 足够长,本来就能掩盖很多 CPU 工作;小模型、低 batch 和高 TP 下的 更短,重叠通常更重要。
这类优化首先由系统时间线驱动,而不是由注意力数学驱动。SGLang 官方文章指出思路与 NanoFlow 相通:把 CPU 调度放到 GPU 计算旁边形成软件流水。两者的具体对象和执行引擎不同,但共同原则都是把“必须等结果”的同步压到最小,把不依赖结果的元数据准备提前。
Overlap Scheduler 的执行时间线
当前 event_loop_overlap() 保留了普通循环的外形,却把结果处理延迟一轮。其主干可压缩为:
result_queue = deque()
while True: ingest_requests() plan = get_next_batch_to_run(running_batch, last_batch) batch = plan.batch_to_run
if must_sync(batch, last_batch): process(result_queue.popleft())
if batch: result = run_batch(batch) result_queue.append((batch.copy(), result))
if last_batch and not must_sync(batch, last_batch): process(result_queue.popleft())
launch_delayed_sample_if_needed(batch, result) last_batch = batch顺序里最容易看漏的一点是:run_batch(batch_n) 返回,不等于 batch 的全部 GPU 工作已经完成。PyTorch 在 CUDA stream 上异步排队,返回的 GenerationBatchResult 可以携带尚未物化到 host 的结果及完成事件。于是 CPU 能在 forward_stream 执行 batch 时,处理队首的 batch 。
一次稳定 decode 的时序可以写成:
迭代 n 的 CPU:准备 batch n -> launch batch n -> 提交 batch n-1迭代 n 的 GPU: 执行 batch n
迭代 n+1 CPU:准备 batch n+1 -> launch batch n+1 -> 提交 batch n迭代 n+1 GPU: 执行 batch n+1这里实际有三类执行上下文:
| 上下文 | 主要工作 | 不能擅自做什么 |
|---|---|---|
| Scheduler/plan stream | 队列、缓存匹配、KV 分配、构造下一批元数据 | 读取尚未物化的 token 值 |
forward_stream | 模型前向、采样与 future 值发布 | 使用已被 CPU 回收或复用的页表/请求行 |
copy_stream | 将采样、logprob 等结果异步拷回 host | 越过 forward 结果完成事件读取设备 tensor |
run_batch() 进入 forward_stream_ctx 前,先让 forward stream 等待 schedule stream,确保 CPU 已经提交的 H2D 元数据和分配结果对本轮可见。模型完成后,普通 CUDA 路径让 copy_stream 等待 forward stream,再做 D2H;下一轮前向不必反过来等待整段 D2H。结果对象上的 copy_done 事件最终保证 process_batch_result() 读取 host 数据时拷贝确实完成。
官方 Nsight 轨迹展示了这种组织想达到的效果:相邻 decode batch 的 GPU Kernel 几乎首尾相接,CPU 结果处理与准备工作落在设备忙碌区间内。
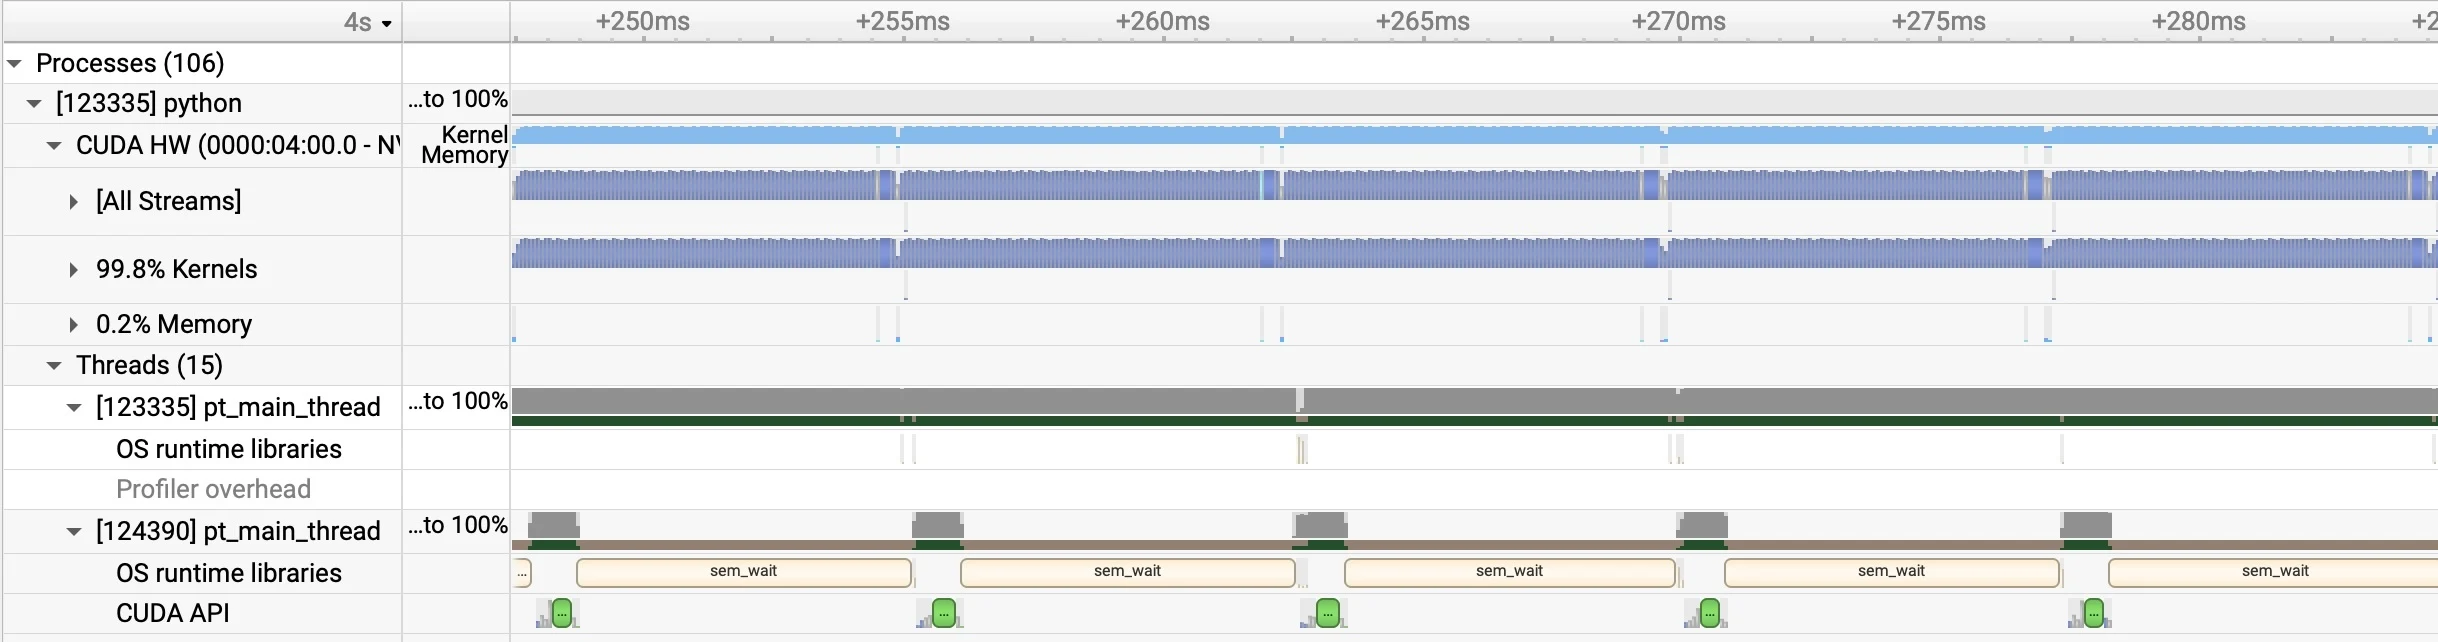
图源:SGLang v0.4 官方发布文章。图中的蓝色 Kernel 带接近连续,说明该设置下主机气泡已基本隐藏;这张图使用当时的 Triton attention backend,不能据此推断所有 backend、batch shape 和硬件都没有间隙。
流水线并不允许任意乱序。源代码中的 _apply_war_barrier() 处理一类 write-after-read 风险:下一轮 CPU 可能想改写或复用某个共享元数据,而上一轮 forward 仍在读。屏障不需要把所有 stream 全局同步,只需让真正存在读写冲突的资源等到 shared read 完成。同步粒度越粗,正确但重叠越少;粒度越细,吞吐更好但必须准确描述 tensor 生命周期。
在途批次:last_batch 与 result_queue
last_batch 与 result_queue 看似都表示上一批,职责并不相同。
last_batch 是调度视角的在途批次。get_next_batch_to_run() 需要知道上一轮是 extend 还是 decode,才能把刚完成 prefill 的请求合入 running_batch、排除仍在 chunking 的请求,并决定下一轮能否继续 decode。它回答的是“上一轮发出了什么计划”。
result_queue 是提交视角的在途结果。每个元素是 (batch_snapshot, result_handle):前者保存解释结果所需的批次快照,后者保存异步前向与 D2H 的结果句柄。它回答的是“哪一轮结果还没有写回长期请求状态”。在普通稳定路径中队列深度约为一;同步边界、空闲、投机和某些并行模式会让代码显式排空或特殊处理。
为什么入队时必须 batch.copy(),不能直接保存当前 batch?ScheduleBatch 会在下一次调度中被 filter_batch()、merge_batch()、prepare_for_decode() 修改;请求列表、序列长度、forward mode 和输出位置都可能改变。结果返回后仍需按 batch 的行顺序把 token 归还给 batch 的请求。如果 result queue 引用同一个可变列表,下一轮删掉一个 finished request 后,旧结果就可能错配到另一条请求。
当前 copy() 只快照结果处理真正使用的字段,而不是深拷贝整个 batch。它会复制 reqs 列表本身,使后续 rebind/filter 不改变旧批次的成员顺序;列表里的 Req 对象仍然共享。这个折中避免复制大量 tensor,也引入一条纪律:任何会被下一轮提前修改、而旧结果处理还依赖的标量,都必须额外快照。例如 Mamba 分支会保存本轮 decode_batch_idx,因为共享 Req 可能已被下一轮加一。
可以把正确性条件写成:对队列中的第 个结果,快照请求顺序 与设备结果行顺序 必须保持一一对应:
这也是在重叠路径中“浅拷贝是否足够”的判断标准:不是看对象有没有变,而是看旧结果解释所依赖的字段能否被后续迭代改坏。
队列还有一个资源生命周期作用。GenerationBatchResult 可能持有 device tensor、CUDA event、延迟采样闭包或需要跨 stream 保活的引用。当前实现用双槽 batch_record_buf 把部分 tensor 至少固定两个迭代,避免 Python 引用提前消失后 caching allocator 复用其存储,而 GPU 仍在异步读取。这里的“两轮”不是业务语义,而是流水深度对应的最短保活窗口。
future token:结果未返回时怎样准备下一轮
重叠 decode 面临一个因果依赖:batch 的输入正是 batch 采样出的 token。CPU 若还没执行 process_batch_result(),Req.output_ids 就没有这个 token;直接从 Python 请求对象构造下一批会读到旧值。简单解法是同步等待 D2H,再准备下一批,但这会重新制造需要消除的气泡。
SGLang 用 FutureMap 把“值未知”和“地址未知”分开。每条活动请求已经有稳定的 req_pool_idx,因此下一 token 虽然尚未产生,它未来要写入哪一行却已经知道。FutureMap.output_tokens_buf 是按 request pool row 索引的设备 tensor:batch 采样后把 token scatter 到对应行,batch 在 forward 入口按同一组行号 gather。数据依赖由 GPU stream 顺序和 event 保证,不必先绕到 Python list。
batch n req_pool_indices = [7, 19, 23] │ ├─ model forward -> sample [t7, t19, t23] │ └─ FutureMap.output_tokens_buf[[7,19,23]] = [t7,t19,t23] │batch n+1 │ input_ids = FutureMap.output_tokens_buf[[7,19,23]] ◀─┘ScheduleBatch.prepare_for_decode() 在 overlap 模式下可以把 batch.input_ids 留成占位状态,仍提前完成 KV 位置申请、sequence length 更新和大部分 metadata 构造。真正进入 forward_stream 时,resolve_forward_inputs() 才物化输入:纯 decode 从 output_tokens_buf[req_pool_indices] gather;prefill 从 pinned CPU staging 做异步 H2D;mixed batch 则把 prefill token 与 running request 的 future token 拼接。
核心路径可以压成以下伪代码:
# batch n 的设备结果发布future_map.output_tokens_buf[req_pool_indices] = next_token_ids
# batch n+1 真正进入 forward stream 时解析if batch.input_ids is None: batch.input_ids = future_map.output_tokens_buf[batch.req_pool_indices]这不是预测 token,也不是先用占位值计算。batch 仍严格依赖 batch 的采样结果,只是依赖边停留在设备侧,由 stream 中的 producer-consumer 顺序解析。CPU 可以提前搭好“从哪些行读”的图,而不能提前知道“每行是什么值”。
为什么索引必须使用 req_pool_idx,而不是 batch 内部的第 行?动态 batching 会不断过滤完成请求、插入新请求和合并 prefill;同一请求在相邻 batch 的局部行号可能不同。request pool row 在请求生命周期内稳定,既能作为 KV 页表行号,也能作为跨迭代 future 值邮箱。请求行释放后又可能被新请求复用,所以当前实现还维护 req_generation,让异步读者识别 ABA 式复用。
FutureMap 还保存 new_seq_lens_buf。普通单 token decode 的长度增长可提前推断,但投机解码的接受长度只有 verify 后才知道;后续 attention backend 又可能需要 CPU 侧 seq_lens 来构造 metadata。当前实现按 backend 需求决定是否把新长度经专用 D2H stream 拉到 pinned host buffer。若 backend 能走纯 GPU 长度路径,就跳过这次同步;若必须读取 CPU 镜像,resolve_seq_lens_cpu() 只等待发布事件,不让整个 schedule stream 粗暴同步。
对 mixed chunk,难点再多一层。prefill 请求的输入来自 CPU,running decode 请求的尾 token 来自 FutureMap,两者要在同一个 forward 中形成正确顺序;投机模式下 running request 的实际接受长度还会改变 out_cache_loc。resolve_mixed_spec_tails() 因而在发布栅栏之后,用已提交长度重新绑定尾部行。这里的原则与普通 decode 相同:调度阶段先固定引用,forward 入口再读取上一轮物化的值。
FutureMap 把跨迭代依赖改造成设备数据流,但没有消除同步,只把同步从“CPU 等整个结果”缩小为“消费者等特定发布事件”。如果 future row 没被上一轮写入就读取,得到的不是稍旧 token,而是未初始化数据。CI 路径会把 buffer 初始化为 -1,并在 gather 时断言非负、消费后重新 poison,用来捕获漏 publish 或重复 consume。
延迟提交:何时才能修改请求真值
FutureMap 让设备能够继续算,CPU 上的 Req 却不能假装结果已经发生。Req.output_ids、finished_reason、流式输出和可共享缓存都属于已提交事实,只能在 process_batch_result() 读到完成结果后修改。
一轮 token 的生命周期应区分为:
planned 已分配下一轮页和 metadata,尚未 launchin-flight 已进入 forward/copy stream,结果不可由 CPU 读取materialized token 已写入 FutureMap,下一轮设备可消费committed D2H 完成,CPU 已更新 Req、停止状态与资源账本materialized 与 committed 是 overlap 的关键分界。同一个 token 可以已经被下一轮 GPU 当输入,却尚未追加到 Req.output_ids。这听起来反直觉,实际上是典型流水线:设备数据通路向前推进,控制通路晚一拍确认。
当前 process_batch_result_decode() 首先等待 result.copy_done,然后规范化输出行,逐请求执行以下步骤:
for req, next_tokens in zip(batch.reqs, result.next_token_ids): if overlap and (req.finished() or req.is_retracted): continue
req.output_ids.extend(next_tokens) req.update_finish_state(len(next_tokens))
if req.finished(): release_kv_cache(req, tree_cache, checkpoint=True)省略的 logprob、grammar、beam 和多模态分支不会改变提交顺序:先确认 host 结果,再更新语义历史,再判断完成,最后结算资源。update_finish_state() 需要检查 max_new_tokens、EOS、stop token 等条件;字符串 stop 仍由后续 detokenizer 参与。完成原因一旦成立,Scheduler 才能向输出管线发送最终状态。
延迟提交也意味着调度阶段不能随便读取 len(req.output_ids) 推断设备精确进度。某些字段以 committed state 为准,另一些字段例如 kv_committed_len 或 batch 自身的 seq_lens 可能已经为在途轮次预推进。源码中的许多 “减一”“lookahead in (0,1)” 断言,本质上都在检查控制通路最多落后设备一拍。
缓存写回尤其不能提前。上一轮 forward 正在把 K/V 写入新分配槽时,CPU 若先把这些索引 checkpoint 到 RadixCache,另一请求可能命中尚未完成的数据;若先释放或驱逐,更会产生 use-after-free。只有结果提交点确认本轮设备工作完成,checkpoint_kv_cache() 才能把连续有效区间发布到树。上一篇讨论的 cache_protected_len 因此不仅是空间边界,也是时间边界。
同理,指标与 trace 也在结果处理处提交。当前 process_batch_result() 会在 overlap 模式下把 trace flush、负载快照、完成统计等 CPU 工作放进下一轮 GPU 前向窗口。这些动作不影响 token 数值,适合延后;但它们读取的请求状态必须对应已经提交的 batch 快照,不能混用正在准备的下一批。
Prefill、Decode 与 Chunked Prefill 的分支
“延迟一轮处理”在稳定 decode 中最整齐,但 extend/prefill 改变了请求集合和 KV 所有权,不能机械套用同一条时间线。
Prefill 到 Decode 的边界
一条新请求完成最后一个 prefill chunk 后,才有资格进入 running decode batch。get_next_batch_to_run() 会查看 last_batch.forward_mode.is_extend(),过滤仍在 chunking、已经完成或属于特殊模式的请求,再把其余请求合入 running_batch。注意此时 last_batch 的设备工作已经发出,CPU 结果可能仍在 result_queue 中;因此“合入 running”表达的是下一步设备计划,并不代表首 token 已经写入 Req.output_ids。
首 token 同样可通过 FutureMap 直接喂给第一次 decode。于是 extend 的采样结果无需先回到 CPU,GPU 数据通路就能越过 prefill-to-decode 边界。CPU 稍后处理 prefill 结果时,才把首 token追加到请求语义历史并检查它是否已触发终止。
连续 Prefill 为什么可能主动同步
当前 is_disable_overlap_for_batch() 可以在环境开关启用时,对连续两个 extend batch 暂停 overlap。动机不是正确性不足,而是 TTFT 权衡:如果 batch 的 prefill 先占据 forward stream,batch 的首 token 结果处理与采样发射可能被推迟。先提交前一批能更早暴露首 token,但会牺牲少量总体吞吐。
因此,同步不是 overlap 失败,而是调度目标变化。在线服务同时关心吞吐、TTFT 与 inter-token latency;让所有能并行的工作都尽量并行,未必能优化指定的尾延迟指标。
Chunked Prefill 的在途计数
长 prompt 被切成多个 chunk 后,同一 Req 可能连续出现在 extend batch 中。调度器用 inflight_middle_chunks 记录已经 launch、尚未提交的中间 chunk。中间 chunk 的 logits 不能作为用户首 token,它只推进 KV;即使此时收到 abort,已经发出的 GPU 工作也无法从 stream 中凭空撤销,只能等待结果到达后丢弃语义输出并结算物理资源。
下一 chunk 不能覆盖上一 chunk 仍在使用的请求行或 KV 映射。stash_chunked_request()、last_batch 排除集合与 checkpoint 延迟共同保证:调度可以提前为后续 chunk 做准备,但缓存只发布已经完成的连续前缀。若直接以 extend_end 的计划值写回树,而不是以结果提交后的有效边界写回,就可能让 RadixCache 指向仍在写入的页。
Mixed Chunk 的 late binding
第四篇已经解释 mixed chunk 把新请求 extend 与 running decode 放进同一次 forward。本篇需要补上时间依赖:prefill 行能在 CPU 阶段完整确定,decode 行的输入 token 来自在途结果。prefill_input_ids_cpu 和 mix_running_indices 因而作为 staging 保留到 forward 入口;resolve_forward_inputs() 先异步搬运 prefill token,再按请求行 gather future token,最后拼成设备输入。
这也是 ScheduleBatch 不能只保存一个最终 input_ids tensor 的原因。Overlap Scheduler 需要把“可提前计算的结构”和“必须延迟绑定的值”分别表示,否则要么过早同步,要么把未解析占位符送进模型。
Overshoot:多跑一步为什么不能直接忽略
Overlap Scheduler 永远有一轮控制延迟。batch 采样出 EOS 时,CPU 尚未提交这个结果,batch 可能已经为同一请求分配 KV 并发射。batch 以 EOS 作为输入又计算一次,这一拍就是 overshoot。
时间线可以写成:
GPU batch n: sample EOS -> publish EOS to FutureMapCPU prepare: 尚不知道 EOS,仍把请求放入 batch n+1GPU batch n+1: 读取 EOS,写入一个额外 KV 槽并采样 extra tokenCPU commit n: 追加 EOS,设置 finished_reason,释放请求CPU commit n+1: 发现 req 已 finished,丢弃 extra token额外 token 不能追加到 output_ids,不能发给用户,也不能推进 stop/grammar 状态。当前 decode 结果处理器开头检查:在 overlap 模式下,如果 req.finished() 或 req.is_retracted,直接跳过这条旧快照中的结果。注释明确把这种再次出现视为 overlap 的预期路径,而不是重复完成错误。
“丢弃结果”仍不够。batch 已经占用物理 KV 位置,甚至可能预分配了更长尾部。完成 batch 时的 release_kv_cache() 必须知道 kv_allocated_len 可能领先语义有效长度,把 overshoot 和其他 overallocated tail 一并归还。否则用户看不到错误 token,显存却会每个完成请求泄漏一页。
对按长度结束的请求,下一轮是否会结束可以提前判断。当前 _reqs_finishing_inflight() 查看 result queue 中即将提交的请求,并用 next_output_finishes_by_length() 把确定达到 max_new_tokens 的行从下一 decode batch 排除。这能避免已知终点的 overshoot。EOS 和随机采样结果无法由 CPU 提前知道,仍允许最多一拍的 lookahead。
这给出了 overlap 安全所需的三个条件:
- lookahead 深度有明确上界,当前普通路径按一轮设计;
- 迟到结果处理幂等,已完成请求不会再次追加输出或释放两次;
- 资源释放按已分配长度结算,而不是只按用户可见 token 长度结算。
若流水深度从一轮扩到多轮,这三处都必须重做。仅把 result queue 放深并不能获得免费的多步 overlap,因为请求可能连续多算多轮,KV 预留、stop 泄漏、grammar 状态和随机数消费都会改变。
投机解码让 overshoot 更复杂:一次 verify 可接受多个 token,实际长度直到设备结果产生才知道;FutureMap 还要转发 bonus token、top-k、hidden state 或草稿概率。当前 Spec V2 为这些字段建立同类 relay,并用发布 event 与 generation 保护每个请求行。它仍遵循相同原则,只是“一拍”不再等于一个 token。
缓存 checkpoint 与资源回收的安全点
上一轮 GPU 与下一轮 CPU 并行后,任何 free 都要先问:旧 stream 是否还在读这段内存?这包括 KV slot、request row、batch metadata tensor 和统一内存搬迁源地址。
对普通完成路径,安全顺序是:
等待 batch n 的 copy_done -> 将 token 提交到 Req -> update_finish_state -> checkpoint 已完成且有效的 KV -> 解锁旧缓存路径 -> 释放请求私有尾部与 overshoot -> 归还 req_pool rowcopy_done 只直接描述结果 D2H,但它位于 forward 之后,因此也间接证明本轮对 KV 的写入已经排在前面完成。若另有独立异步传输或 offload,则不能借用这条推论,必须等待对应事件;代码中的 P/D 分离与 decode offload 分支正是额外协议。
请求行的释放也比普通循环敏感。FutureMap 以 req_pool_idx 为 key,batch snapshot 和正在运行的 Kernel 都可能保留这一行。旧请求释放后,新请求若立即复用相同行号,而旧 D2H 或异步 relay 又迟到,就会把新请求状态误当旧请求状态。除了 stream 保活,req_generation 还提供逻辑世代校验;这类问题与无锁数据结构中的 ABA 问题相似。
滑动窗口注意力提供了一个直观反例。decode 逐步前进时可以回收窗口外 KV,但第一个 overlap decode 发出时,上一轮 extend 可能仍在读取完整前缀。当前代码在 decode_batch_idx==0 时禁止相应 SWA eviction;chunked prefill 也要等足够多轮后才驱逐旧窗口。回收条件不能只看“下一轮理论上不需要”,还要看“上一轮实际上是否已经停止读取”。
当前 _forward_isolation() 还把一次 forward 包装成事务式边界:保存会被 worker 临时改写的 ScheduleBatch 字段,执行设备提交,再恢复 schedule-side 视图;overlap 路径额外把快照与保活引用放进双缓冲。这个设计避免 ModelRunner 为运行需要就地改写 batch 后,Scheduler 下一轮看到半设备态、半调度态对象。
因此,缓存安全点可以用两个条件表达。设资源 的最后设备读写事件为 ,CPU 所有权提交为 ,只有同时满足
才能把 归还可复用池。前者防止物理 use-after-free,后者防止语义上的重复释放或错误 checkpoint。只满足其中一个都不够。
源码主循环与关键伪代码
从两个 event loop 做差分
阅读 overlap 最有效的入口不是先追 CUDA event,而是把 event_loop_normal() 与 event_loop_overlap() 并排比较。两者都执行 ingest、plan、run、process 四件事,区别只在 process 的位置和输入值的来源:
| 阶段 | 普通循环 | Overlap 循环 |
|---|---|---|
| 准备下一批 | 上一批已完整提交 | 上一批可能仍在 result queue |
| decode 输入 | Req.output_ids[-1] 可直接使用 | 从 FutureMap 延迟解析 |
run_batch 后 | 立即处理当前结果 | 当前结果入队,处理上一结果 |
| 请求完成 | 当前轮立即过滤 | 可能出现一轮 overshoot |
| KV 回收 | 没有下一轮在途读者 | 必须覆盖在途预分配与保活 |
可用一个不带高级分支的伪代码重建完整协议:
def overlap_loop(): pending = deque() last_batch = None
while True: ingest_requests()
# 依据 committed Req + last_batch 的在途结构准备新计划 plan = schedule(running_batch, last_batch) batch = plan.batch_to_run
# 某些边界必须先提交旧结果 if needs_sync(batch, last_batch): old_batch, old_result = pending.popleft() commit(old_batch, old_result)
if batch is not None: allocate_kv_and_build_metadata(batch)
# forward 入口才解析上一轮产生的 token resolve_forward_inputs(batch, future_map) result = launch_forward_and_sample(batch)
# 设备侧为下一轮发布 token/长度 future_map.publish(batch.req_pool_indices, result) enqueue_d2h_on_copy_stream(result)
pending.append((batch.copy(), result))
# batch n 在 GPU 跑时,CPU 提交 batch n-1 if last_batch is not None and not needs_sync(batch, last_batch): old_batch, old_result = pending.popleft() commit(old_batch, old_result)
last_batch = batch这段伪代码刻意把 allocate_kv_and_build_metadata() 放在 future token 解析之前。下一 token 的数值未知,并不妨碍 Scheduler 为每条仍活动请求申请一个输出 KV 槽、更新逻辑长度并构造请求行索引。只有真正嵌入 token 时才需要数值,因而可以推迟到 forward 入口。
run_batch() 中的三条关键边
固定提交中的普通生成 overlap 路径可以按三个依赖边理解:
- schedule stream 到 forward stream:
forward_stream.wait_stream(schedule_stream),保证分配和元数据准备先于设备消费; - forward 内部发布:
_relay_forward_payload()把 sampled token 或投机额外状态 scatter 到 FutureMap,publish()写入新长度并按需记录 event; - forward stream 到 copy stream:
copy_stream.wait_stream(forward_stream),保证 host copy 读取已经产生的结果。
代码随后把 batch.input_ids=None。这不是丢失输入,而是明确告诉下一次调度:当前 token 已由 relay 接管,后续不得依赖这个临时 tensor。若继续保留旧 input_ids,下一轮可能误把 batch 的 token 当作 batch 输入,形成不易察觉的重复生成。
采样并不总在 forward_batch_generation() 返回前完成。若结果带 delay_sample_func,事件循环先提交前一批结果,再调用 launch_batch_sample_if_needed();这样 grammar 或其他 CPU 状态先推进到正确位置,随后在 forward stream 上执行延迟采样并发布 future token。采样完成后必须清空闭包捕获的 logits tensor,否则 result_queue 与双缓冲会让大 tensor 多保活一轮,形成稳定增长的显存泄漏。
为什么存在同步逃生口
is_disable_overlap_for_batch() 是显式的同步逃生口。连续 prefill 可以为了 TTFT 先提交前一批;某些 grammar 与投机算法需要 CPU FSM 先看到上一批接受结果,才能生成下一批合法 token bitmask。若算法提供 grammar overlap barrier,则可在 worker 内部的恰当位置推进 FSM;否则必须先 pop result。
在数据并行注意力模式下,所有 rank 还要对“本轮是否禁用 overlap”做一致判断。一个 rank 进入同步分支、另一个 rank 继续发射 collective,会直接死锁。因此源码使用全局同步的 is_extend_in_batch,而不是只看某个 rank 的局部 batch 类型。性能分支一旦跨 collective,就同时是分布式正确性分支。
性能数字应该怎样读
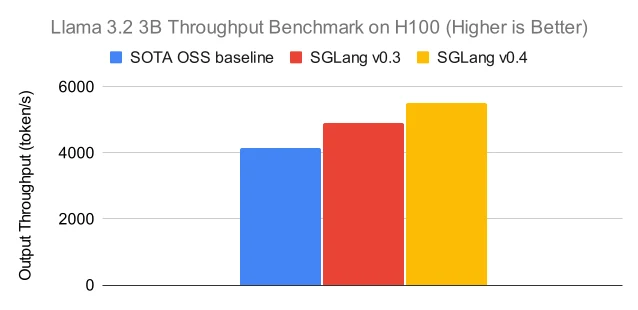
图源:SGLang v0.4 官方发布文章。图中比较 SOTA OSS baseline、SGLang v0.3 与开启重叠调度的 v0.4;原文给出的环境是 H100 上的 Llama 3.2 3B,并报告 v0.4 相对 v0.3 约 1.1 倍。这个结果验证了机制,但不能脱离模型、输入输出长度、并发和 attention backend 单独引用。
判断自己的服务是否受益,应测两种模式的同一套请求分布:默认 overlap 与 --disable-overlap。至少同时记录 output throughput、TTFT、TPOT/ITL、GPU kernel gap 和 Scheduler CPU 时间。若吞吐不变但 TTFT 恶化,可能是连续 prefill 排队策略;若 GPU gap 仍明显,可能有未被隐藏的 host sync;若 GPU 已连续而 CPU 满核,瓶颈可能转移到 tokenization、detokenization 或协议层。
不能只用平均 tokens/s 判断正确性。Overlap 改变了提交时序,测试还要比较固定随机性下的 token 序列、finish reason、流式/非流式结果、KV 空闲计数和请求结束后的 pool 恢复。速度变快但偶发多一个 token、重复 stop、页数缓慢下降,都说明流水线账本尚未闭合。
调试方法、边界条件与常见误读
建立最小可观察时间线
先用单 GPU、batch size 1、无投机、无 grammar、无 P/D 分离的短输出请求,对正常与 overlap 两条路径分别记录:
iterationbatch object idforward_moderid listreq_pool_indicesseq_lens_cpuout_cache_locresult_queue lengthlast_batch modelen(req.output_ids)req.finished_reasonkv_committed_len / kv_allocated_len对同一请求,应该看到设备长度最多领先 output_ids 一拍;result_queue 在稳定 decode 中不会无界增长;完成后 request row 和 overallocated KV 都归还。若队列持续增长,说明 CPU commit 已跟不上 GPU,重叠只能暂时隐藏开销,最终仍会形成背压或内存膨胀。
源码导航可从四个文件开始:
rg -n "event_loop_(normal|overlap)|run_batch|process_batch_result" \ python/sglang/srt/managers/scheduler.py
rg -n "class FutureMap|resolve_forward_inputs|def (publish|stash)" \ python/sglang/srt/managers/overlap_utils.py
rg -n "prepare_for_decode|def copy|enable_overlap" \ python/sglang/srt/managers/schedule_batch.py
rg -n "process_batch_result_decode|_handle_finish_state_updated_req" \ python/sglang/srt/managers/scheduler_components/batch_result_processor.py第一遍不要进入每个 attention backend。先证明控制层满足“发布一次、消费一次、提交一次、释放一次”,再追 Kernel 使用的具体 metadata。
用 Nsight 区分哪一种空隙
Nsight Systems 中相邻 Kernel batch 的白色空隙可能来自不同原因:
- Python/Scheduler 还没 launch 下一批:CPU 暴露开销;
- H2D 或 D2H 落在默认 stream 并形成隐式同步:stream 组织问题;
- CPU 读取 device tensor,例如
.item()或.cpu():host-device barrier; - CUDA Graph shape 不命中,回退 eager 并重新构造 metadata:执行路径变化;
- NCCL collective 等待其他 rank:分布式控制流或负载不一致;
- Kernel 本身很短但 launch 数量很多:CPU 发射速度成为上限。
结合 NVTX 标记观察 get_next_batch_to_run、run_batch、D2H 与 process_batch_result 的相对位置。若 process_batch_result(n-1) 与 forward(n) 已重叠,空隙仍位于 forward(n) 内部阶段之间,继续优化 Scheduler 不会解决问题;应转向 ModelRunner、采样或 backend。
常见误读一:run_batch() 返回表示 GPU 已完成
CUDA 默认异步。返回结果对象只表示工作已排队,并且后续依赖有 event 可等待。真正读取 host 结果前仍要同步 copy_done。把 Python 函数返回当设备完成,会导致过早释放和偶发 illegal memory access。
常见误读二:Future token 是 CPU 预测值
FutureMap 不猜 token。它提前确定稳定地址,让前一轮 GPU 写、后一轮 GPU 读。数值依赖仍严格成立。若把 future token 理解为乐观预测,就会错误推导出需要回滚模型状态;普通 overlap 不需要 token 级回滚,只需处理已知的一拍 overshoot。
常见误读三:last_batch 与 result_queue[-1][0] 可以合并
前者参与下一轮计划,后者保存旧结果解释快照。二者在简单 decode 中内容相近,但生命周期和允许修改的字段不同。合并后,Scheduler 对 batch 的过滤或 merge 可能破坏旧结果行映射。
常见误读四:finished 请求再次出现在结果中就是 bug
一轮 overshoot 是单步流水的自然结果。真正的错误是把 overshoot token 提交给用户、让它推进 grammar,或没有释放其 KV。结果处理器对 finished/retracted 的早期跳过与公共 release 的 overallocated tail 回收必须配套存在。
常见误读五:重叠后所有回收都应延后一轮
只有可能被在途读者引用的资源才需延迟。无关的 Python 临时对象、已完成 copy 的 host buffer可以立即释放。把所有东西统一多保留一轮虽然容易正确,却会抬高峰值显存和请求槽占用;资源应由最后使用事件决定,而不是由一个全局“保险轮次”决定。
常见误读六:开启更多 CUDA stream 就会更快
stream 只表达可并行性,不创造独立硬件资源。两个 stream 若访问同一 tensor 存在 RAW/WAR/WAW 依赖,仍需 event;大量细碎 event 还会增加 launch 和同步开销。SGLang 的收益来自切开 CPU 控制依赖、设备 relay 与 D2H,而不是 stream 数量本身。
边界条件清单
- 请求在 waiting、in-flight decode、结果已物化但未提交三个窗口收到 abort;
- EOS、
max_new_tokens、stop token 与 sampling mask failure 的完成路径; - batch 中部分请求结束,其余请求继续,旧快照行顺序仍正确;
- request pool row 很快复用,旧 event 或 relay 不得污染新 generation;
- chunked prefill 中间 chunk 被 abort,
inflight_middle_chunks最终回到零; - mixed chunk 同时包含 CPU prefill 输入与 FutureMap decode 输入;
- sliding-window eviction 不回收上一轮仍在读的前缀;
- grammar bitmask 必须看到正确的已提交 FSM 状态;
- TP/DP rank 对 overlap 开关、batch mode 与 collective 顺序一致;
- 服务空闲、暂停、热更新或退出前排空 result queue,不能遗留在途资源;
- CUDA Graph padding row 不读取未初始化 future 值;
- logprob、hidden state 和 routed expert 等附加输出的 D2H 生命周期与 token 对齐。
这些测试的共同目标不是覆盖每个 feature flag,而是验证四条流水线不变量:旧结果不会错配新 batch,future 值先发布后消费,语义状态只在提交点前进,物理资源只在最后读者完成后复用。
小结与后续路线
SGLang Overlap Scheduler 把串行的“GPU 前向 → CPU 结果处理 → 下一批准备”改造成一拍软件流水:batch 在 forward_stream 上执行时,CPU 提交 batch 并准备 batch ;copy_stream 单独搬运结果,尽量不阻塞下一次前向。它消除的是时间线中的可见 CPU 气泡,不是 CPU 工作本身。
这条流水能够成立,依赖四组机制共同闭环。last_batch 保存下一轮调度所需的在途结构,result_queue 保存尚未提交的结果与批次快照;FutureMap 用稳定 request pool row 在设备侧传递下一 token 和长度,避免 CPU 为取值同步;process_batch_result() 把 token、完成原因和缓存发布收敛到唯一提交点;overshoot 与 overallocated tail 回收则吸收一拍控制延迟带来的多算。
从源码角度看,最重要的不是记住某个 event 名称,而是判断一个值处于 planned、in-flight、materialized 还是 committed。只要把这四个时刻混成一个“当前状态”,就会出现 token 错位、stop 泄漏、缓存悬空或页复用竞态。反过来,只要每个跨 stream 对象都有稳定索引、发布栅栏、快照和最终释放点,事件循环就能在保持自回归因果关系的同时,让 GPU 连续工作。
SGLang 源码系列当前进度如下:
| 序号 | 主题 | 状态 |
|---|---|---|
| 一 | 整体架构、进程拓扑与请求数据流 | 已完成 |
| 二 | Entrypoints、TokenizerManager 与 DetokenizerManager | 已完成 |
| 三 | Scheduler 请求状态机 | 已完成 |
| 四 | PrefillAdder、调度策略与 chunked prefill | 已完成 |
| 五 | KV 内存池与当前 RadixCache 源码 | 已完成 |
| 六 | Overlap Scheduler | 本篇 |
| 七 | ForwardBatch、TpModelWorker 与 ModelRunner | 下一篇 |
| 八 | Attention Backend | 待写 |
| 九 | CUDA Graph 与编译路径 | 待写 |
| 十 | Sampling、Grammar 与结构化输出 | 待写 |
| 十一 | 投机解码 | 待写 |
| 十二 | TP 与 PP | 待写 |
| 十三 | DP Attention、EP 与 MoE | 待写 |
| 十四 | Prefill/Decode 分离与分布式 KV | 待写 |
下一篇将沿 ScheduleBatch -> ForwardBatch -> TpModelWorker -> ModelRunner 继续向设备执行层推进:调度计划怎样变成扁平 token、position、sequence length 与 attention metadata,Worker 为什么要隔离分布式与采样分支,ModelRunner 又怎样在 eager、编译和 CUDA Graph 路径之间选择。
参考资料
- SGLang v0.4:Zero-Overhead Batch Scheduler 官方发布文章
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv)
- SGLang 论文(NeurIPS 2024)
- NanoFlow: Towards Optimal Large Language Model Serving Throughput(arXiv)
- Scheduler 主循环与设备提交源码(固定提交)
- FutureMap 与输入延迟解析源码(固定提交)
- Req 与 ScheduleBatch 源码(固定提交)
- Batch Result Processor 源码(固定提交)
- SGLang 官方 GitHub 仓库
- SGLang v0.4 Overlap Scheduler 初始实现 PR
- SGLang 默认启用 Overlap Scheduler 的 PR
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


