


Training-Free Looped Transformers 完全拆解:免训练测试时循环,让冻结 LLM 多想几遍
背景:循环是训练出来的,还是可以推理时装上去的?
2025 年以来,「循环 Transformer」(looped transformer)成了测试时计算(test-time compute)最热的一条技术路线。它与传统 Transformer 的根本区别是:不再把 N 个独立参数层从头堆到尾,而是让一小段共享权重的层被重复应用多次,把「深度」变成运行时可以调节的量。这条线的谱系很长:从 2019 年 Google 的 Universal Transformer、参数共享的 ALBERT,到把网络当作隐式不动点求解的 Deep Equilibrium Model(DEQ,arXiv:1909.01377),再到 2024 年起把「looped」做大的新一批工作——把循环 Transformer 当作可编程计算机的理论研究(Looped Transformers as Programmable Computers,arXiv:2301.13196)、在 7.7T token 上预训练的 Ouro(Scaling Latent Reasoning via Looped Language Models,arXiv:2510.25741)、recurrent depth 路线的测试时扩展研究、MoEUT、Mixture-of-Recursions、弹性深度的 LoopFormer(arXiv:2602.11451)、研究循环语言模型缩放律的 Parcae、甚至给循环模型做强化预训练的 LoopRPT。
这些工作有一个共同前提:循环结构与模型参数一起训练。层与层之间的权重在每一轮循环里共享,优化器显式地让网络适应「同一个层被反复调用」这件事;循环轮次一多,梯度还要跨轮次传播,训练配方(残差缩放、优化器、批大小)都得为此重新设计。后果是:循环能力被焊死在权重里。对于市面上几乎全部已发布的开源权重——Qwen3、Llama-3.2、Moonlight、DeepSeek-V2-Lite——你没法直接对它们做循环推理,因为网络的后半段在训练时从未见过「被循环处理过一遍」的中间表征,强行循环只会让隐藏状态飞出它熟悉的区域。
这就产生了一个此前几乎没人正面回答的问题:
能否在推理时直接循环一个冻结的、现成的模型——不微调、不继续训练、不加任何辅助参数、不改任何架构?
2026 年 5 月 22 日发布于 arXiv 的论文 Training-Free Looped Transformers(arXiv:2605.23872,作者 Lizhang Chen、Jonathan Li、Chen Liang、Ni Lao、Qiang Liu 等)给出了肯定的答案,并且用的是完全「推理侧」的思路:一个轻量级的推理时包装器(wrapper)找到冻结模型中部的一段连续层,把它们在每次前向里多跑 K 遍。实验横跨 7 个模型家族(稠密、稀疏 MoE、MLA+MoE 都有),45 个(模型,基准)组合,用一套固定配方拿到 Qwen3-4B-Instruct 在 MMLU-Pro 上 +2.64、在 GPQA-Main 上 +2.01、Qwen1.5-MoE-A2.7B-Chat 在 ARC-Challenge 上 +2.30 的成绩。
为什么敢这么干?论文把三条互相独立的证据串了起来。其一,Men 等人的 ShortGPT(arXiv:2403.03853)发现,整块删除 Transformer 中部的若干层,模型损失极小;其二,Lad 等人的工作(The Remarkable Robustness of LLMs: Stages of Inference?,arXiv:2406.19384)报告中部层可以被跳过、交换甚至重复而不至于灾难性退化,说明网络前向可以粗略分成「早期建表示 → 中期精炼 → 晚期读出」几个阶段;其三,Tuned Lens 实验(Eliciting Latent Predictions from Transformers with the Tuned Lens,arXiv:2303.08112)表明中间层的 logits 已经编码了最终预测的大部分信息。主流解读把这三条证据读作「可压缩性」——中间层冗余,所以能删。本文指出一个被忽略的互补视角:让中间层「删掉也安全」的那个性质,同样让它们「重复也安全」。不过作者强调,朴素地整块重复应用通常会退化,怎么循环才是全部难点所在——这正是本文方法的出发点。
方法总览:把模型切成「循环前 + 循环窗 + 循环后」
把冻结模型记为 ,其中 是第 个解码层,作用于形状为 的残差流( 个 token, 维)。选择一个连续的循环窗口 ()和循环次数 ,窗口诱导出一个算子:
包装器把网络切成三段:循环前的层 、被迭代的中间段 、循环后的层 :
如果 或 ,对应一侧的空组合就是恒等映射。整篇方法的核心都浓缩在 的两个选择上:迭代模式(iteration mode)和循环策略(loop strategy)。
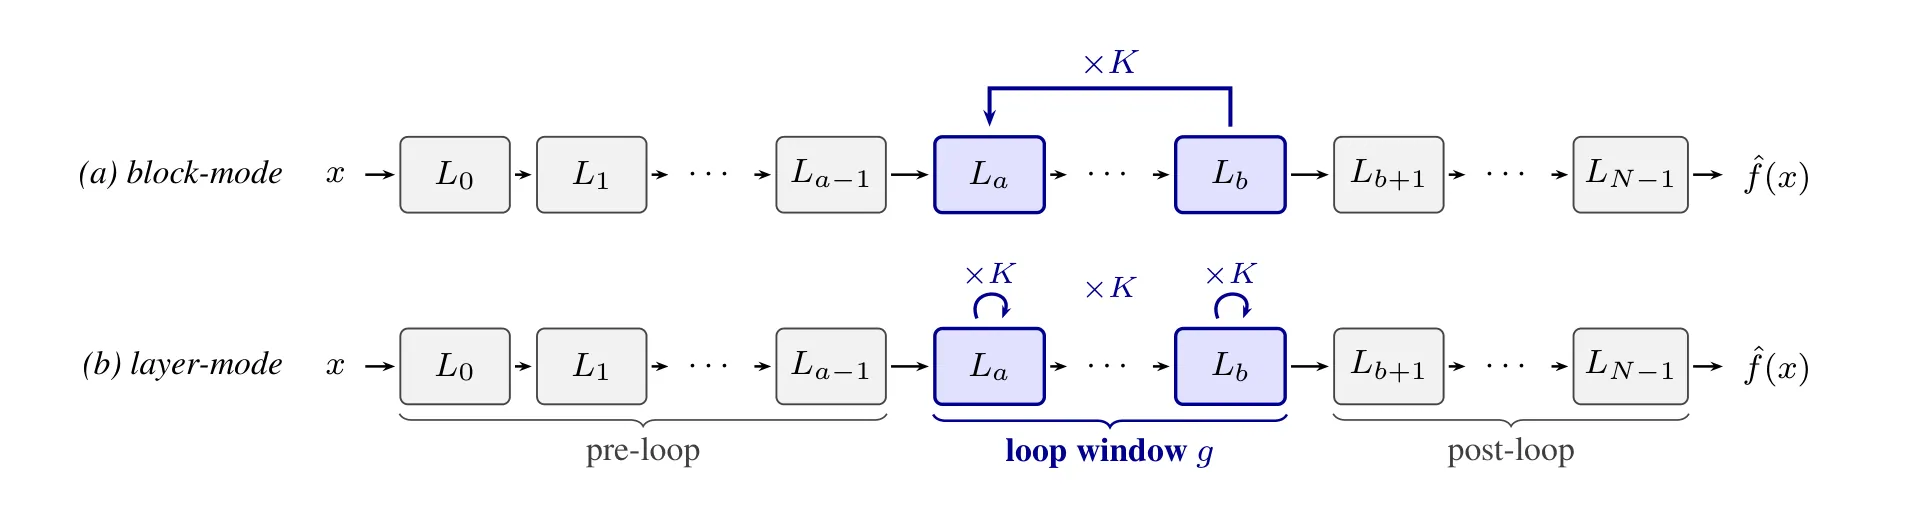
两种迭代模式:block-mode 与 layer-mode
给定窗口算子 , 有两种自然的实现方式:
block-mode 把整个窗口当作一个单元整体回卷 次——相当于反复执行「从 一路走到 」的完整子程序;layer-mode 则先让 自己循环 次,把结果交给 ,再由 循环 次……逐个层来。上图(论文 Figure 1)画的就是这个区别:(a) 里一个大的 回卷箭头罩住整个蓝色窗口;(b) 里蓝色窗口的每一层上方都各自挂着一个 。
对稠密模型,两种模式质量大致相当;但对 MoE 模型二者有天壤之别——block-mode 下,每轮迭代窗口内每个 MoE 层的门控网络都会在一个被轻微扰动的隐藏状态上重新做专家路由,前后两轮路由到的专家集合不同,路由引入的噪声逐轮累积,最终盖过循环本来想要的「精炼」效果,论文称之为路由抖动(routing thrash)。layer-mode 把门控决策固定下来:进入某层时只算一次路由,同一组专家混合被重复应用 次,从而绕开这个失败模式。所以对 MoE 骨干,layer-mode 是正确默认(后面有专门一节讲它)。
ODE 视角:一个 pre-norm 层就是一步前向欧拉
为什么「重复应用一段层」这件事能讲出道理来?关键是论文把 Transformer 的前向与常微分方程(ODE)的数值积分对应了起来。先看一个标准的 pre-norm 解码层:
右端第一项就是输入 本身,其余全是残差更新。把这一结构推广到循环窗口算子 (不管它包含一层还是多层),定义窗口残差场:
于是 ——把它与数值分析里最经典的前向欧拉格式 对照,立刻看出: 的一次应用,恰是以步长 对自治 ODE 做的一步前向欧拉。这个对应关系对窗口内层数多寡都成立;两种迭代模式的区别只在于 展开成什么:
- layer-mode: 就是单层的残差场 ;
- block-mode:把链式展开前后抵消(telescoping), 是窗口内各层残差场沿前向轨迹求和:
其中 是第 层自己的残差场。换句话说,block-mode 的 就是把 到 每一层「各自贡献的位移」串起来的总位移场。
朴素循环为什么崩:积分到了 t=K,可网络只见过 t=1
关键的一步在这里。网络的后半段( 到 )在训练时接收的输入,是 以步长 的欧拉步「隐式逼近」的 这个终点——注意训练让 的输出尽量是正确的 端点,而不是别的时刻。而朴素地把 应用 次( 重复 遍,正是 Universal Transformer、Ouro 等训练期循环模型的用法),等价于以 连走 步,积分逼近的是 。于是循环区出口处的隐藏状态偏离了后段网络熟悉的分布,且 越大偏离越远——这就是「冻结模型上朴素循环普遍退化」的数学原因。
论文用一个极小的端到端可训练网络把这个效应可视化(下图的 Figure 2):网络结构是 3 个残差层 ,在 2-D 回归目标上训练。因为瓶颈只有 2 维,可以直接把「喂给 post 层」的隐藏状态画在平面上:训练好的基线在网络中部诱导出一条低 loss 的谷(图中蓝色区域),每条测试样本的基线终点都落在这条谷里。
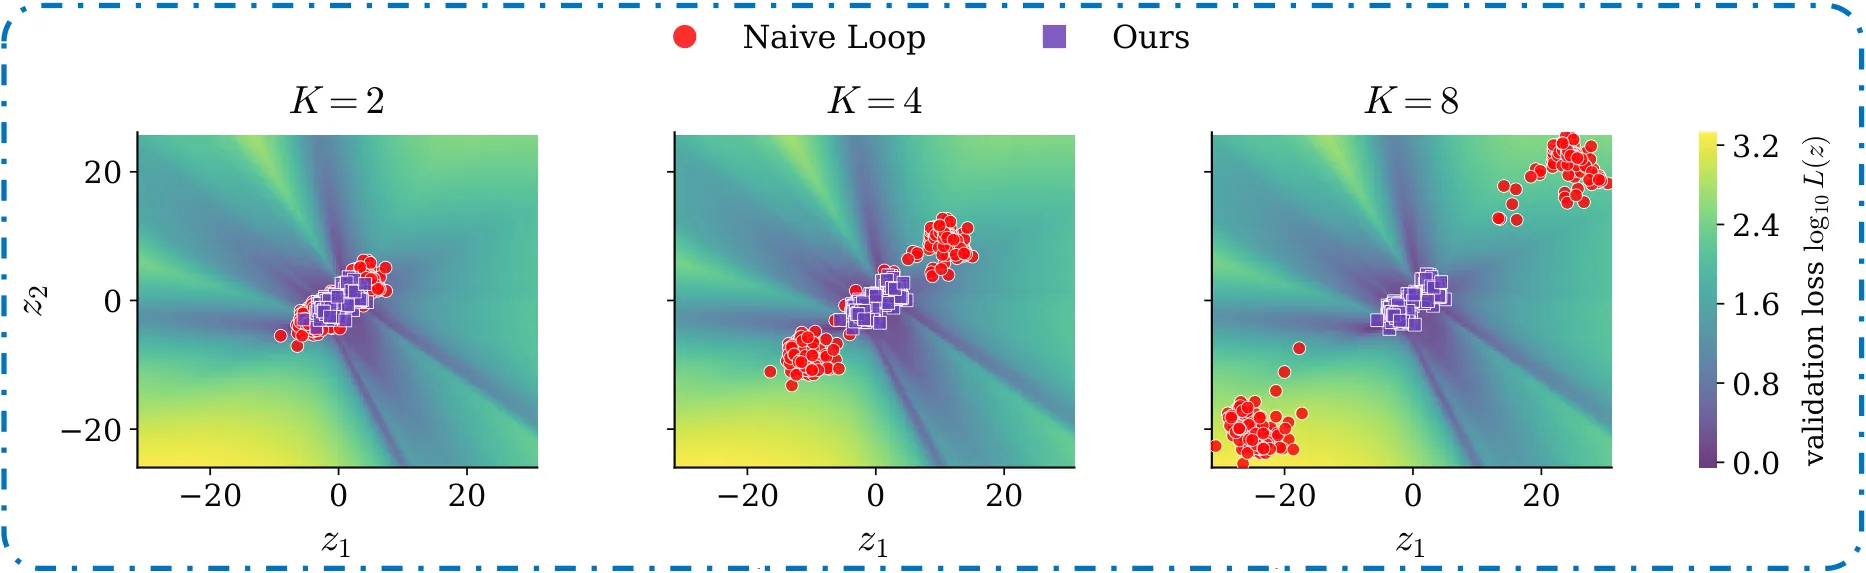
数值上,测试集平均后: 时朴素循环把 MSE 从基线的 0.015 抬到 2.88,而阻尼子步只有 0.36(约 8 倍差距); 时朴素循环的 MSE 膨胀到 335,阻尼子步只有 1.04(约 320 倍差距)。红色圆点(朴素循环)随 增大向外漂进黄色高 loss 区,紫色方块(阻尼积分)则始终簇拥在低 loss 谷里——同一套权重,仅仅因为「怎么循环」不同,行为天差地别。
阻尼子步:把一次大步拆成 K 个小步,仍走到同一个终点
既然朴素循环错在「走到了 」,正确的目标就明确了: 不应当把积分推进到 ,而应当用更细的分辨率去逼近同一个 终点——那个未经改动的网络本来就瞄准的点。经典数值分析给出的做法是把总积分时长 以步长 细分。对 ODE 走 步步长 的欧拉,得到阻尼更新:
直觉上,这等价于「把每次 带来的位移只采用 ,剩余 保留原状态」,即对残差更新做阻尼; 步累计的总位移和一次大步差不多,但轨迹被细化了。欧拉法的全局误差是 ,所以这套阻尼子步以 的阶收敛到真正的 ,严格优于网络每层隐式实现的那一步粗糙的 欧拉。由于方程 与模式无关,这套阻尼原理在 layer-mode(对单层场细分)和 block-mode(对复合场 细分)下都成立。
统一框架:带锚定的 K 级 Runge–Kutta
阻尼欧拉只是数值积分的一个特例。更一般地,可以用 级显式 Runge–Kutta(RK)来逼近 :
其中各级斜率沿轨迹逐级取样:
系数 由 Butcher 表给出。论文取了一个特别的表:设 、、(对 )——于是第 级恰好是在阻尼欧拉序列 处求值( 即阻尼欧拉映射)。再把输出权重设成带参数 的形式:,其余 (),它们非负且和为 1。可以证明这个 RK 的输出满足恒等式:
这个公式很有解释力:最终输出 = 原始一次性前向结果 与 K 步阻尼欧拉结果 的凸组合,权重由 控制。两个极端: 时输出就是 ,包装器退化成原模型,什么都不做; 时就是纯 K 子步阻尼欧拉。中间的 则相当于把轨迹「往回锚定」到训练过的一次性端点方向——论文称 为锚点(anchor),这也是图 Figure 1 里那句「循环结束后与锚点做凸组合」的含义。数学上它对应一种前置加载的求积规则(front-loaded quadrature):更重视第一条残差方向。
注意默认配方里的「K=2/3 级 RK」与「damped Euler」在 时是同一件事,论文术语里两者经常混用;它们相对普通 RK4 的优势在于只需 次前向(RK4 要 次),且不需要场的光滑性假设。
与高阶积分器、不动点加速器的对比
把「怎么循环」当成数值分析问题后,工具箱立刻变大了。论文系统对比了以下策略家族(数字来自论文 Table 1,前向次数按每次迭代计):
| 策略 | 更新规则(示意) | K 次迭代的 g 求值总数 | 直觉 |
|---|---|---|---|
| 朴素循环 Naive Loop | 不做任何阻尼,走到 | ||
| 阻尼欧拉 Euler | 细分同一段积分时长 | ||
| 中点法 Midpoint (RK2) | 先半步子步再整步 | 二阶精度,需场光滑 | |
| Heun (RK2) | 端点斜率取平均 | 二阶精度,需场光滑 | |
| RK4 | 四级斜率加权 | 四阶精度,最贵 | |
| Heavy-ball | 带动量,加速收敛 | ||
| Anderson 加速 | 用最近 步残差解最小二乘外推 | 不动点收缩时最优 | |
| Aitken | 逐坐标外推(带 Steffensen 保护) | 收缩时超线性 | |
| Uniform Loop | 对历史状态平均后再进 | 内层循环式平均 |
在 Qwen3-1.7B-Base 的标准窗口 [12–15] 上做 16 任务宏平均消融,结论非常干脆:高阶方法全部输给阻尼欧拉。block-mode 下 midpoint、Heun、RK4 分别比参考配置低 −0.85、−0.92、−0.65 pp;layer-mode 下差距更大(−1.96、−1.90、−2.34 pp)。不动点加速器更惨:Heavy-ball 勉强接近(−0.12/−0.06 pp),Aitken 直接 −7.00 pp,而 Anderson 加速在最差配置()下暴跌 −18.06 pp(layer-mode −19.56 pp),是全篇最差单配置。这个结果本身是一个重要诊断:Anderson 加速在收缩不动点上被证明接近最优,它在这里全面溃败,说明冻结 Transformer 的中段在任何有用的意义上都不是收缩映射——固定点求解器那套「反复迭代会收敛」的假设不成立,必须靠阻尼把迭代钉在训练分布里。论文因此把 K 级 RK( 的阻尼欧拉,)作为默认配方。
在哪里循环:4 层窗口与「深度分数」规则
确定了「怎么循环」,下一个问题是「循环哪几层」。论文的系统答案是:中部连续 4 层。在 Qwen3-1.7B-Base 上用阻尼欧拉 做窗口宽度扫描(16 任务宏平均 pp,论文 Table 2(a)):
| 窗口宽度 n | 窗口 | 16-task 宏平均 | pp |
|---|---|---|---|
| 1 | [14] | 55.72 | +0.18 |
| 2 | [13,14] | 55.60 | +0.06 |
| 3 | [13,14,15] | 55.75 | +0.21 |
| 4 | [12–15] | 56.09 | +0.55 |
| 6 | [11–16] | 54.72 | −0.82 |
| 12 | [8–19] | 54.91 | −0.63 |
| 28(全网络) | [0–27] | 27.81 | −27.73 |
n=4 是甜点,n≥6 出现陡峭悬崖;把整个网络重复一遍(等价于把模型跑两遍做集成)则彻底崩溃——LAMBADA 困惑度直接爆到 。这印证了方法部分的机制分析:只有中段那一小条(约 4 层)表现为「安全可重复」的细化场,窗口一旦加宽就会包进行为不收缩的层,而把非收缩区迭代 K 次只会放大其非收缩性。n=4 的选择在模型规模间泛化良好:Qwen3-1.7B/4B-Base 与 Llama-3.2-3B-Instruct 上 n=4 全部优于 n=3,Qwen3-0.6B 是唯一例外(n=3 的 +0.57 胜过 n=4 的 +0.22)。
窗口的绝对位置则由一条经验规律决定:深度分数规则。对论文测过的全部检查点,最优窗口中心落在深度分数(窗口中心层号 / 总层数 N)的一个狭窄区间里:参数量大于 1.7B 的模型,最优中心在 0.43–0.71(众数约 0.50);1B 以下的模型前移到 0.25–0.56。论文 Figure 6(下图)把九个检查点的最优窗口范围画在同一张图上,阴影条带标出 0.45–0.60 的经验甜点区,横跨 16 到 48 层、稠密与 MoE、base 与 instruct。
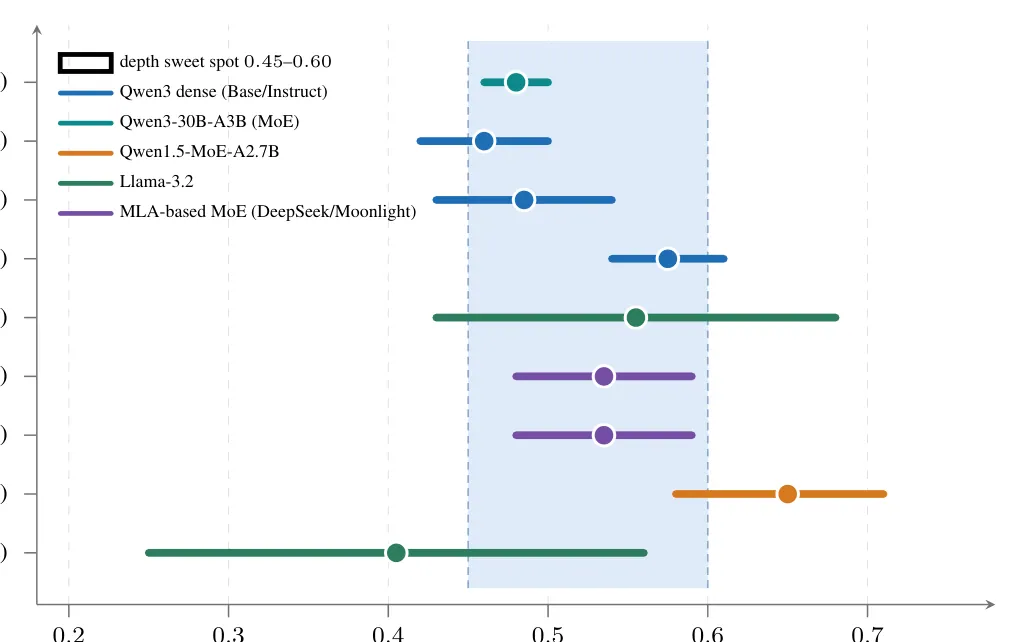
为什么是中部?论文给出的机制假说与 Tuned Lens、Lad 等人的「推理阶段」观察一致:浅层还在构造表征,深层在向输出空间坍缩并完成「读出」所需的头部特化(head specialization),这两端都不能动;中段才是「表示精炼」发生的区域——它既冗余得可以被安全删除,也因此可以被安全重复。小模型与重度蒸馏模型(如 Llama-3.2 系列是蒸馏出来的)里,后段承担特化的比例更大,可安全循环的区域就相应前移。落到具体数值:Qwen3-4B(36 层)的窗口是 [15–18](窗口中心深度分数约 0.46),1.7B(28 层)是 [12–15](约 0.48),Qwen1.5-MoE-A2.7B(24 层)是 [13–16](约 0.60),30B-A3B(48 层)的泄漏自由迁移窗口是 [22–24](0.46–0.50)——全部落在规则带内。
路由抖动与 MoE 的 layer-mode 救赎
上面说过 block-mode 在 MoE 上会因路由抖动而不稳,这里是数据。论文在 Qwen1.5-MoE-A2.7B 与 Moonlight-16B-A3B 两个 MoE 骨干上直接对比两种模式(论文 Table 2(c),Δpp vs 基线):
| 模型 / 基准 | block-mode | layer-mode |
|---|---|---|
| Qwen1.5-MoE-A2.7B ARC-Challenge | +0.17 | +0.85 |
| Qwen1.5-MoE-A2.7B CommonsenseQA | +0.16 | +0.33 |
| Qwen1.5-MoE-A2.7B OpenBookQA | +1.00 | −1.40 |
| Qwen1.5-MoE-A2.7B MMLU | −1.18 | 0.00 |
| Moonlight-16B-A3B ARC-Challenge | −1.45 | +0.51 |
| Moonlight-16B-A3B GPQA-Main | −2.00 | +0.90 |
| Moonlight-16B-A3B OpenBookQA | −0.20 | +1.20 |
| Moonlight-16B-A3B CSQA | −0.66 | +0.49 |
layer-mode 把绝大多数负单元翻正,在硬基准上带来 +0.5 到 +1.7 pp 的提升。注意 OpenBookQA 那行 block-mode 反而胜出,说明两种模式各有适用域,并非严格支配关系。另外 layer-mode 也并非万能:它对 K 更敏感,layer-mode 的 heavy-ball 在 Qwen3-4B-Base 上比规范配置低 5–6 pp——单层内部迭代超过两次就会产生强分布外状态,所以 MoE 上的默认是温和的 layer-mode 。
机制上,为什么门控抖动这么致命?MoE 层的门控把 token 路由到不同专家,等于在残差更新上叠加了一个「离散选择」;block-mode 每轮迭代,窗口内每个 MoE 层都在轻微扰动后的状态上重新做这个离散选择,两轮之间专家集合的差异会累积成与表示无关的纯噪声,K 轮下来噪声量级超过精炼本身。layer-mode 把「选专家」从循环里解耦出来:路由决策对整层循环只算一次(论文原话是 computes the gating decision once),随后 K 次子步重复应用同一组专家混合——噪声源被掐断,留下的才是表征层真正的迭代精炼。这个洞见对训练期循环模型同样成立:MoEUT(MoE Universal Transformer)等训练 MoE 循环的工作本来就用逐层循环而非整块循环,本文把这个经验从「训练期设计」迁移成了「推理期选择」。
工程实现:KV Cache 的「快照/恢复」与 stash 通道
到此为止的讨论都发生在理想化的前向图里。真正做自回归推理时,循环与 KV Cache 的交互是最大的工程陷阱——论文在附录里给了完整的两阶段协议,这一节值得细讲,因为任何想把该包装器落到服务端的实现都会撞上同样的坑。
先看两个阶段的处境差异:
- Prefill 阶段(一次处理整段 prompt,无历史 KV):循环体内部以
use_cache=False运行,不写任何 KV;循环结束后,再做一次单独的 stash 通道(stash pass)跑过循环区,写入规范的 KV 条目。 - Decode 阶段(每步一个新 token,带着既有 past KV):循环体内部必须以
use_cache=True运行——否则新 token 在窗口内的注意力就读不到真实的历史上下文,等于对着截断的上下文计算;但它又不能留下任何净 KV 写入,因为规范条目要由循环结束后的 stash 通道来写。
麻烦在于 transformers 的 DynamicCache.update() 是无条件追加的,没有原地覆盖模式。如果朴素地在 decode 循环体里开 use_cache=True,每轮迭代每个循环层都会在同一逻辑位置上追加一条 KV,K 轮就是 K 条——下一次 decode 时注意力会把这些「幻影前缀 token」(phantom prefix tokens)全部读进去,缓存被彻底污染。论文的解法是快照/恢复(snapshot/restore):进入循环前,先记录每个循环层缓存当前的 token 数 ;每轮迭代体跑完后立刻把缓存裁剪(crop)回 。这样每轮迭代都能读到真实的 past KV,但迭代本身对缓存的净效果为零,而且裁剪是 allocation-free 的。
循环结束后是决定性的 stash 通道:额外跑一遍循环区前向,为每个循环层在每个位置写入恰好一条规范 KV。用哪个隐藏状态作为这一趟的输入,就是论文所谓的缓存策略 :
三种取值对应: 用循环后的输出状态(post-loop hidden state)作为 stash 通道的输入, 用循环前的输入 (pre-loop input), 则不写任何 KV(纯消融用,实际部署不可行)。
整个流程下来,每个 token 在循环区每层恰好贡献一条 KV——与未改动的原模型逐 token 完全同形状、同内存。这正是免训练包装器能无痛嵌入现有服务栈的原因。
缓存策略 是包装器配置里影响最大的单个旋钮。(循环区不写 KV)在 decode 上必然灾难:Qwen3-4B-Instruct 上 MBPP pass@1 从 61.60 掉到 38.20(−23.40 pp),MMLU-Pro 从 57.14 掉到 48.29(−8.86 pp)——原因不难理解:下一个 token 经过循环区时必须能读到「自己在前一步写下的过去」,如果该区域对 KV 而言是空洞,自回归链条就断了。两个合法策略则都好用,取舍取决于输出结构:长 prompt / 长 CoT(如 MMLU-Pro 5-shot CoT)用 cache=first 明显更好(+2.64 vs +1.00 pp),短结构化生成(如 MBPP 代码)用 cache=last 略优(+0.80 vs +0.20 pp)。论文对此的解释是:first 策略把「循环前的原始状态」存进缓存,后续 token 读到的是未经过循环扰动的一致性上下文,更利于长程连贯生成;last 策略则把循环精炼后的状态固化下来。部署时按「长自由文本还是短结构化 token」来切,而不是逐基准搜索。
除了缓存策略,论文还暴露了第三个维度的旋钮:decode 时机。decode_mode 有三种取值:
bypass:只在 prefill 循环,增量 decode 阶段完全不循环。纯 log-likelihood 评测(知识类选择题的准确率就是这样算的)默认用它。实测墙钟开销 ≈ 0(甚至 −1.5%,属于噪声范围内的 KV 写入路径瘦身)。first_n:只循环前 N 个生成 token(原本为 CoT 前缀精炼设计):N=16 时开销 −1.0%(与基线不可区分),N=64 时 +4.6%。实测从未在「循环该起作用的地方」胜过 full。full:每个 decode 步都循环。Qwen3-4B-Instruct、GSM8K@200、K=3 的端到端测量:194 秒 → 236 秒,+21.6%。
论文给出了便于推算的分解口径:4 层窗口占 36 层总深度的约 11%,full 模式(K=3)等于在这段网络上比基线多跑两遍(K−1 次额外迭代 ≈ 22% 的额外前向),再叠加快照/恢复开销——与实测 +21.6% 量级吻合。也就是说,K=3 的完整循环(prefill + 每个 decode 步)在 4B 级模型上的代价是约五分之一的墙钟时间,换来知识类任务上的稳定提升;只做 prefill 循环(bypass)则完全免费。
把视线拉回整个循环模型家族,本文在 KV 处理上的取舍与训练期循环模型正好互补。Ouro 这类把循环焊进权重的模型,推理时若为每轮循环维护独立注意力状态,KV 内存要随循环次数成倍上涨(T=4 就是 4 倍)——其部署方案因此在解码阶段复用最后一轮(或取平均)的 KV,只在 prefill 阶段分开保存。本文反其道而行:循环窗口只占模型中部一小段,迭代期间干脆不写 KV(快照/恢复保证注意力仍能读到真实历史),循环结束后用一次 stash 通道写回规范条目,于是缓存形状与逐 token 内存和原模型完全一致——「循环的代价」被严格限制在墙钟上,而不是内存上。缓存条目数与无循环模型逐 token 相同,也意味着 RadixAttention 式前缀复用、PagedAttention 式分页显存这类现有缓存管理机制不必为循环做任何适配。对服务端来说这是一个连续的「精度—延迟」旋钮,而不像模型替换那样是离散选择。
实现层面还有两个值得注意的工程点。第一,包装器是对模型顶层 decoder class 的连续 monkey-patch:patch 面因架构而异(Qwen3 稠密在 Qwen3Model.forward、Llama 在 LlamaModel.forward、MoE 系在各自的 MoE 模型类上),对 DeepSeek-V2-Lite 和 Moonlight 这类 MLA+MoE 远程代码模型,还需要一个薄的 DynamicCache 兼容层,把新版 transformers 已移除的 seen_tokens/get_max_length/get_usable_length 三个旧 API 重新暴露出来,远程代码才能原样运行。第二,patch 除了 KV 写入外完全无状态:除了策略更新需要的 激活缓冲(W 为窗口宽度)外不维护任何辅助状态,卸载 patch 后从零加载模型输出与基线 bit-exact 一致。
效果:知识密集型多选题上最可靠
方法、模式、窗口、缓存都齐了,论文用一套「开箱即用」的固定配方(中部 4 层、K=2–3 阻尼欧拉/K 级 RK、稠密走 block-mode、MoE 走 layer-mode、cache 按输出类型选、零逐单元超参搜索)横扫 7 个模型家族。先看代表性成绩(论文 Table 3,Δpp 是相对同 prompt 无循环基线的提升):
| 骨干 | 基准 | 基线 | 循环后 | Δpp |
|---|---|---|---|---|
| Qwen3-4B-Instruct | MMLU-Pro 5-shot CoT | 57.14 | 59.79 | +2.64 |
| Qwen3-4B-Instruct | GPQA-Main 0-shot | 33.71 | 35.71 | +2.01 |
| Qwen3-4B-Instruct | CommonsenseQA | 78.87 | 79.93 | +1.06 |
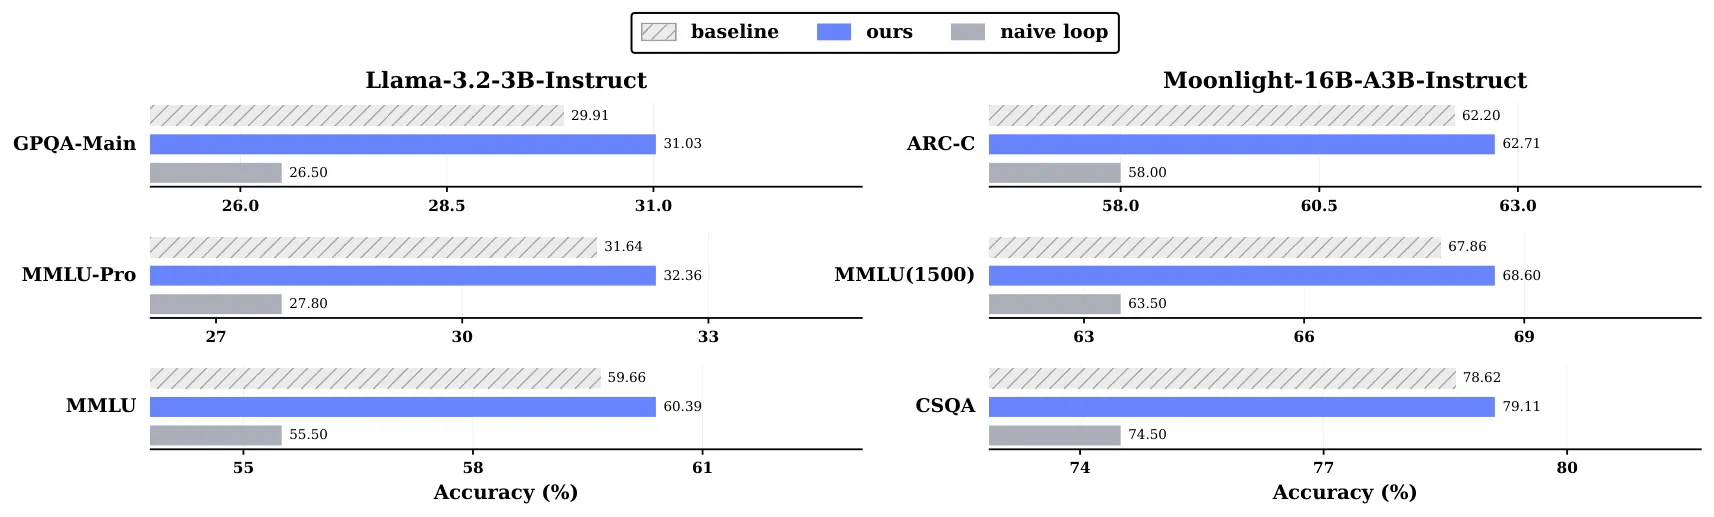
| Llama-3.2-3B-Instruct | GPQA-Main | 29.91 | 31.03 | +1.12 |
| Llama-3.2-3B-Instruct | MMLU | 59.66 | 60.39 | +0.72 |
| Llama-3.2-1B-Instruct | GPQA-Main | 27.90 | 29.69 | +1.79 |
| Qwen1.5-MoE-A2.7B | ARC-Challenge | 48.29 | 50.59 | +2.30 |
| Qwen1.5-MoE-A2.7B | CommonsenseQA | 79.61 | 81.33 | +1.72 |
| Moonlight-16B-A3B | OpenBookQA | 31.60 | 32.80 | +1.20 |
| DeepSeek-V2-Lite-Chat | ARC-Challenge | 57.94 | 58.79 | +0.85 |
下图(论文 Figure 3)用条形图展示了三类骨干的典型行为:灰色条纹是基线、蓝色实条是循环后,每块面板的 y 轴都做了裁剪以放大差异。左面板是 Qwen3-4B-Instruct(稠密 MHA)在四个中等难度知识基准上的一致抬升;中面板是 Qwen3-4B-Base 在四个最难的 MMLU 5-shot 科目上(按附录逐科目分解挑选);右面板是 Qwen3-30B-A3B-Instruct(大型 MoE)——注意它的配方完全是从小模型迁移过去的(窗口按深度分数规则定为 [22–24],零泄漏、零调整)。
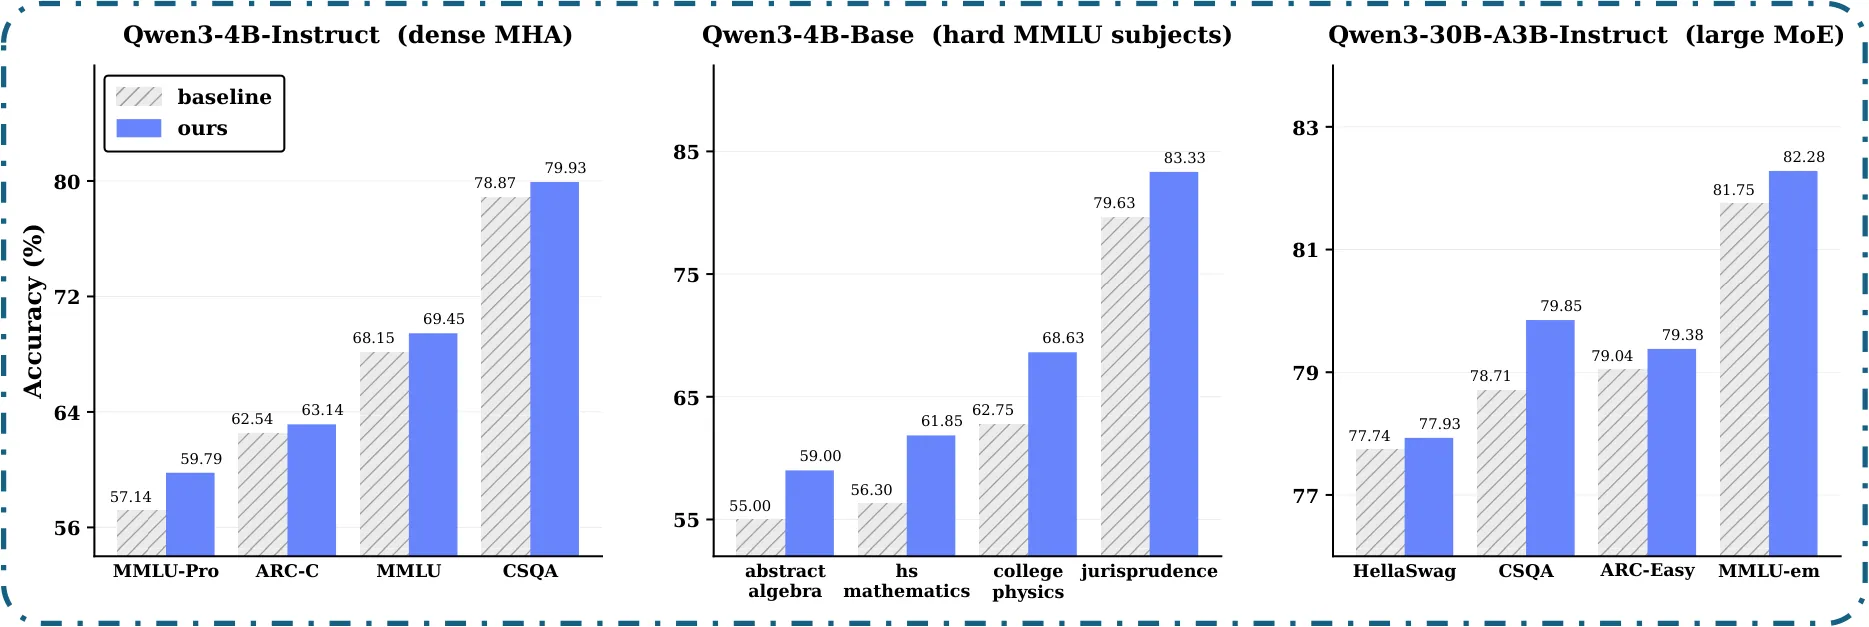
最强的 +2.0 到 +2.6 pp 增益集中在最硬的知识基准(MMLU-Pro、GPQA-Main、ARC-Challenge)上最强壮的 MHA 骨干上;MLA+MoE 系(DeepSeek-V2-Lite、Moonlight)方向一致但幅度小 3–4 倍——论文推测这与 MLA 的低秩 KV 压缩改变了注意力读写结构有关。零调整迁移到 30B-A3B 的那一整栏同样干净:9 项评测 8 项为正(CommonsenseQA +1.14 领跑),唯一打平的是 LAMBADA 困惑度(4.12 → 4.11)——语言建模本身没有被循环打扰,被提升的只是「用足已有知识」的能力。跨全部 45 个(模型,基准)单元统计:60% 单元为正(Δ > +0.3 pp)、27% 中性(|Δ| ≤ 0.3 pp)、非负合计 87%;负单元高度集中在「sub-3B 蒸馏检查点的知识选择题」这一单一区域(如 Llama-3.2-1B 的 MMLU −0.63、MMLU-Pro −1.36)——sub-scale 模型缺少循环所依赖的中段冗余。但失败边界是任务相关而非绝对:同一个 Llama-3.2-1B 在 GPQA-Main 上反而 +1.79(窗口前移到很浅的 [4–7])。
增益的科目分布也很有信息量(论文逐科目分解):MMLU 57 科目里高增益几乎全部落在 STEM 与定量推理科目——college_physics +5.88、high_school_mathematics +5.56(0-shot 下 +5.18)、abstract_algebra +4.00、econometrics +3.51;MMLU-Redux 上 professional_accounting 达 +8.00。但也有纯粹的「知识召回」科目受益(global_facts +6.00、us_foreign_policy 在 K=1 Heun 下 +6 到 +7),说明循环并非只帮「推理」——论文更愿意把它描述成冻结上下文上的知识精炼器(frozen-context knowledge refiner):在不对提示词做任何改动的前提下,把模型内部已编码但一次前向没来得及用足的信息多榨出来一些。这恰好与 Ouro 的机制学发现相呼应:循环增加的不是知识的存储量,而是知识的操纵能力。
与朴素循环的正面交锋
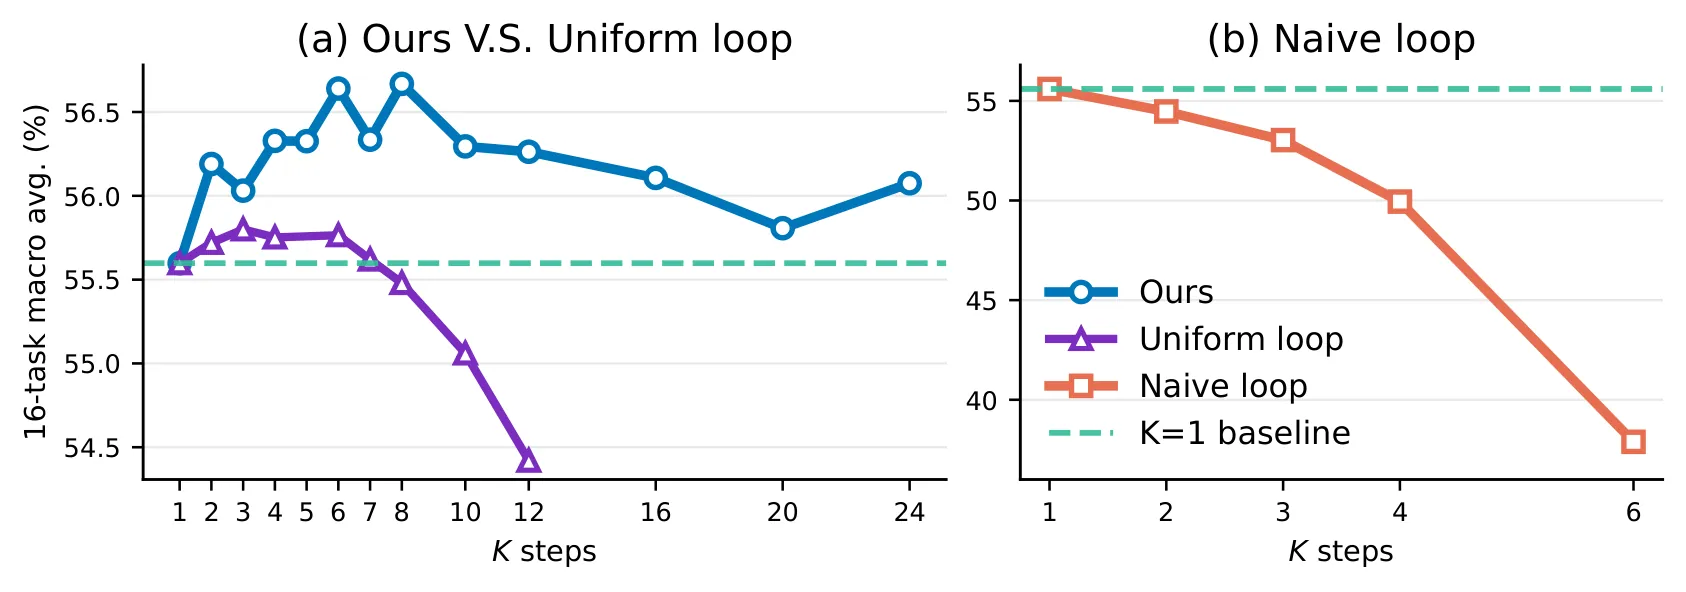
论文还单独拎出与「训练期循环的朴素用法」的对比(Figure 5,见下图):同一批冻结检查点上,朴素 循环(不做阻尼地重复 )在 Llama-3.2-3B-Instruct 和 Moonlight-16B-A3B-Instruct 的每一个评测单元上都崩掉几个百分点——迭代离开了后段层训练过的分布;而论文方法在每个单元上都是三者最高。配套的 K 消融(Figure 4,见下下图)进一步显示论文方法对循环次数极其鲁棒:K 从 1 到 24 全程稳定,而无阻尼的朴素循环随 K 单调恶化(K=6 时 16 任务宏平均跌到 37.89%,比基线低 17.71 pp)——「循环多少次安全」这个问题在正确的阻尼策略下几乎不存在,在错误的策略下则无处不在。
开销、鲁棒性与失败日志
评估本身消耗约 2 万 H100 GPU 小时(4B 级模型单套 16 任务评测约 3 小时,30B-A3B 约 10 小时;显存占用与原模型相同——循环不需要额外驻留权重,因为循环的就是模型自己的层)。论文的诚实之处在于附录里保留了一整节「失败配置日志」,其中几条对后来者价值极高:
- 朴素 K=4 循环即崩:Qwen3-0.6B-Instruct 上 LAMBADA 困惑度从约 13 爆到 1054.12,16 任务宏平均 −10.21 pp——四个中段层、四次无阻尼迭代,肉眼可见地发散。这正是「中段块不是收缩映射」的初始实证观察。
- 16-task 筛选会过拟合:有两个窗口在 16 任务聚合上比规范窗口好 +0.9 到 +1.3 pp,却在留出的 MMLU 5-shot(约 1.4 万样本)上退步 −1.0 到 −1.4 pp。论文因此立了两级验证纪律:16 任务聚合只当筛选器,所有「赢家」必须在 MMLU 5-shot 上复核后才进头条表;小科目只有 100–300 样本,sub-pp 级别的信号不可信。我们看到的全部头条数字都过了这一关。
- 评测协议的方差上界:固定种子下,万样本级基准(MMLU、MMLU-Pro、ARC-Challenge)的运行间方差 ≤0.02 pp,千样本级基准(GPQA-Main、OpenBookQA)≤0.5 pp——所以论文把 |Δ|≤0.3 pp 记为「中性」而非「正」。
墙钟开销(GSM8K@200、Qwen3-4B-Instruct、K=3)之前已经给过:bypass ≈ 0、first_n(16–64) 在 −1.0% 到 +4.6% 之间、full +21.6%。单 query 视角的结论是:如果评测方式不需要 decode 循环(多选题准确率正是如此),这套方法免费;需要生成时,它是价格明确的精度旋钮。
局限与开放问题
把这套方法放到更大的图景里看,几点局限值得明说。其一,增益温和:+0.3 到 +2.6 pp 级别的提升,且集中在知识密集型选择题;对已经接近天花板的基准或对话流畅度类指标帮助有限。其二,失败域真实存在:sub-3B 蒸馏模型的知识选择题基本是负区,窗口搜索必须避开浅层——「深度分数规则」目前是稳健的经验规律(论文对 8 种架构的观测),但「为什么恰好是中段、为什么恰好约 4 层」还缺严格理论刻画。其三,位置与配方仍要按架构机械地换算(层号随总层数平移),尽管论文用 30B-A3B 的零调整迁移证明了规则的跨规模有效性。其四,与更广义的测试时计算的关系:它和「生成更多 token 思考」(CoT/self-consistency)正交——一个在每个 token 上「想得更深」,一个在 token 数上「想得更久」;和 Ouro 这类「训练期把循环焊进权重、推理时靠自适应退出调节」的路线互为镜像:那边是权重适配了循环,这边是循环适配任意权重。把两边拼起来(训练时加循环友好正则 + 推理时循环)论文明确列为未来方向;输入难度自适应的 K、让模型自己决定循环窗口、向多模态扩展也在清单上。
小结
Training-Free Looped Transformers 把一个看似「只能训练期解决」的问题——给模型加递归深度——整个搬到了推理期:借 ODE 数值积分的视角,把每个 pre-norm 层看成一步前向欧拉,于是「循环一段冻结层」就从玄学变成了「用更细步长重新积分网络已经在近似的 ODE」。朴素循环之所以崩,是因为它积分到了网络从未训练过的 ;阻尼子步之所以有效,是因为它用 K 个 小步逼近同一个 。配合中部 4 层窗口的经验规则、MoE 的 layer-mode 路由固定、KV 缓存的快照/恢复与 stash 通道,这套包装器在 7 个模型家族上拿到 87% 非负、知识硬基准最高 +2.64 pp 的结果,而 KV 内存与原模型逐 token 相同、显存占用不变、patch 完全无状态。对推理服务而言,它提供了一个此前不存在的自由度:在不触碰权重的前提下,用可精确计价的额外前向,换取冻结模型上限之外的那几个百分点。
参考资料
- Training-Free Looped Transformers(arXiv:2605.23872,论文主页)
- Scaling Latent Reasoning via Looped Language Models(Ouro,arXiv:2510.25741)
- ShortGPT: Layers in Large Language Models are More Redundant Than You Expect(arXiv:2403.03853)
- The Remarkable Robustness of LLMs: Stages of Inference?(arXiv:2406.19384)
- Eliciting Latent Predictions from Transformers with the Tuned Lens(arXiv:2303.08112)
- Looped Transformers as Programmable Computers(arXiv:2301.13196)
- Universal Transformers(arXiv:1807.03819)
- Deep Equilibrium Models(arXiv:1909.01377)
- LoopFormer: Elastic-Depth Looped Transformers for Latent Reasoning via Shortcut Modulation(arXiv:2602.11451)
- Training-Free Looped Transformers(Hugging Face Paper 页面)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


