


SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
从 PrefillAdder 的缓存预算继续向下
前四篇已经沿着请求主线走完入口、状态机和 Prefill 接纳:TokenizerManager 把外部请求变成 token,Scheduler 维护 waiting/running 状态,PrefillAdder 再依据计算量、分块时间片和 KV 容量决定谁能进入下一次前向。第四篇留下了一个关键问题:available_size()、缓存命中长度和 lock_ref 为什么能够共同参与同一本显存账?
答案不是“RadixCache 里存了一份 KV,running request 又存一份 KV”。SGLang 让缓存前缀与活动请求共享同一批物理 KV 槽;差别只在索引关系和所有权:活动请求通过请求行定位序列中每个 token 的物理槽,RadixCache 通过压缩前缀树定位同一批槽,allocator 则决定哪些槽仍可分配。一次命中、checkpoint、结束或淘汰,本质上都是在改变“谁能引用哪些物理槽、谁有权释放它们”。
SGLang 由 LMSYS 团队于 2023 年 12 月公开,论文发表于 NeurIPS 2024;RadixAttention 是其运行时的代表性设计。本文以系列前文相同的固定提交 d88d5c325ad1cf28f2b804edcd8886e891a8f9b8 为基线。这个版本已经把早期 cache_unfinished_req / cache_finished_req 的职责收敛为 checkpoint() 与 release_kv_cache():名字变化了,但“运行请求把已计算 KV 发布到树,再释放私人所有权”的不变量没有变。
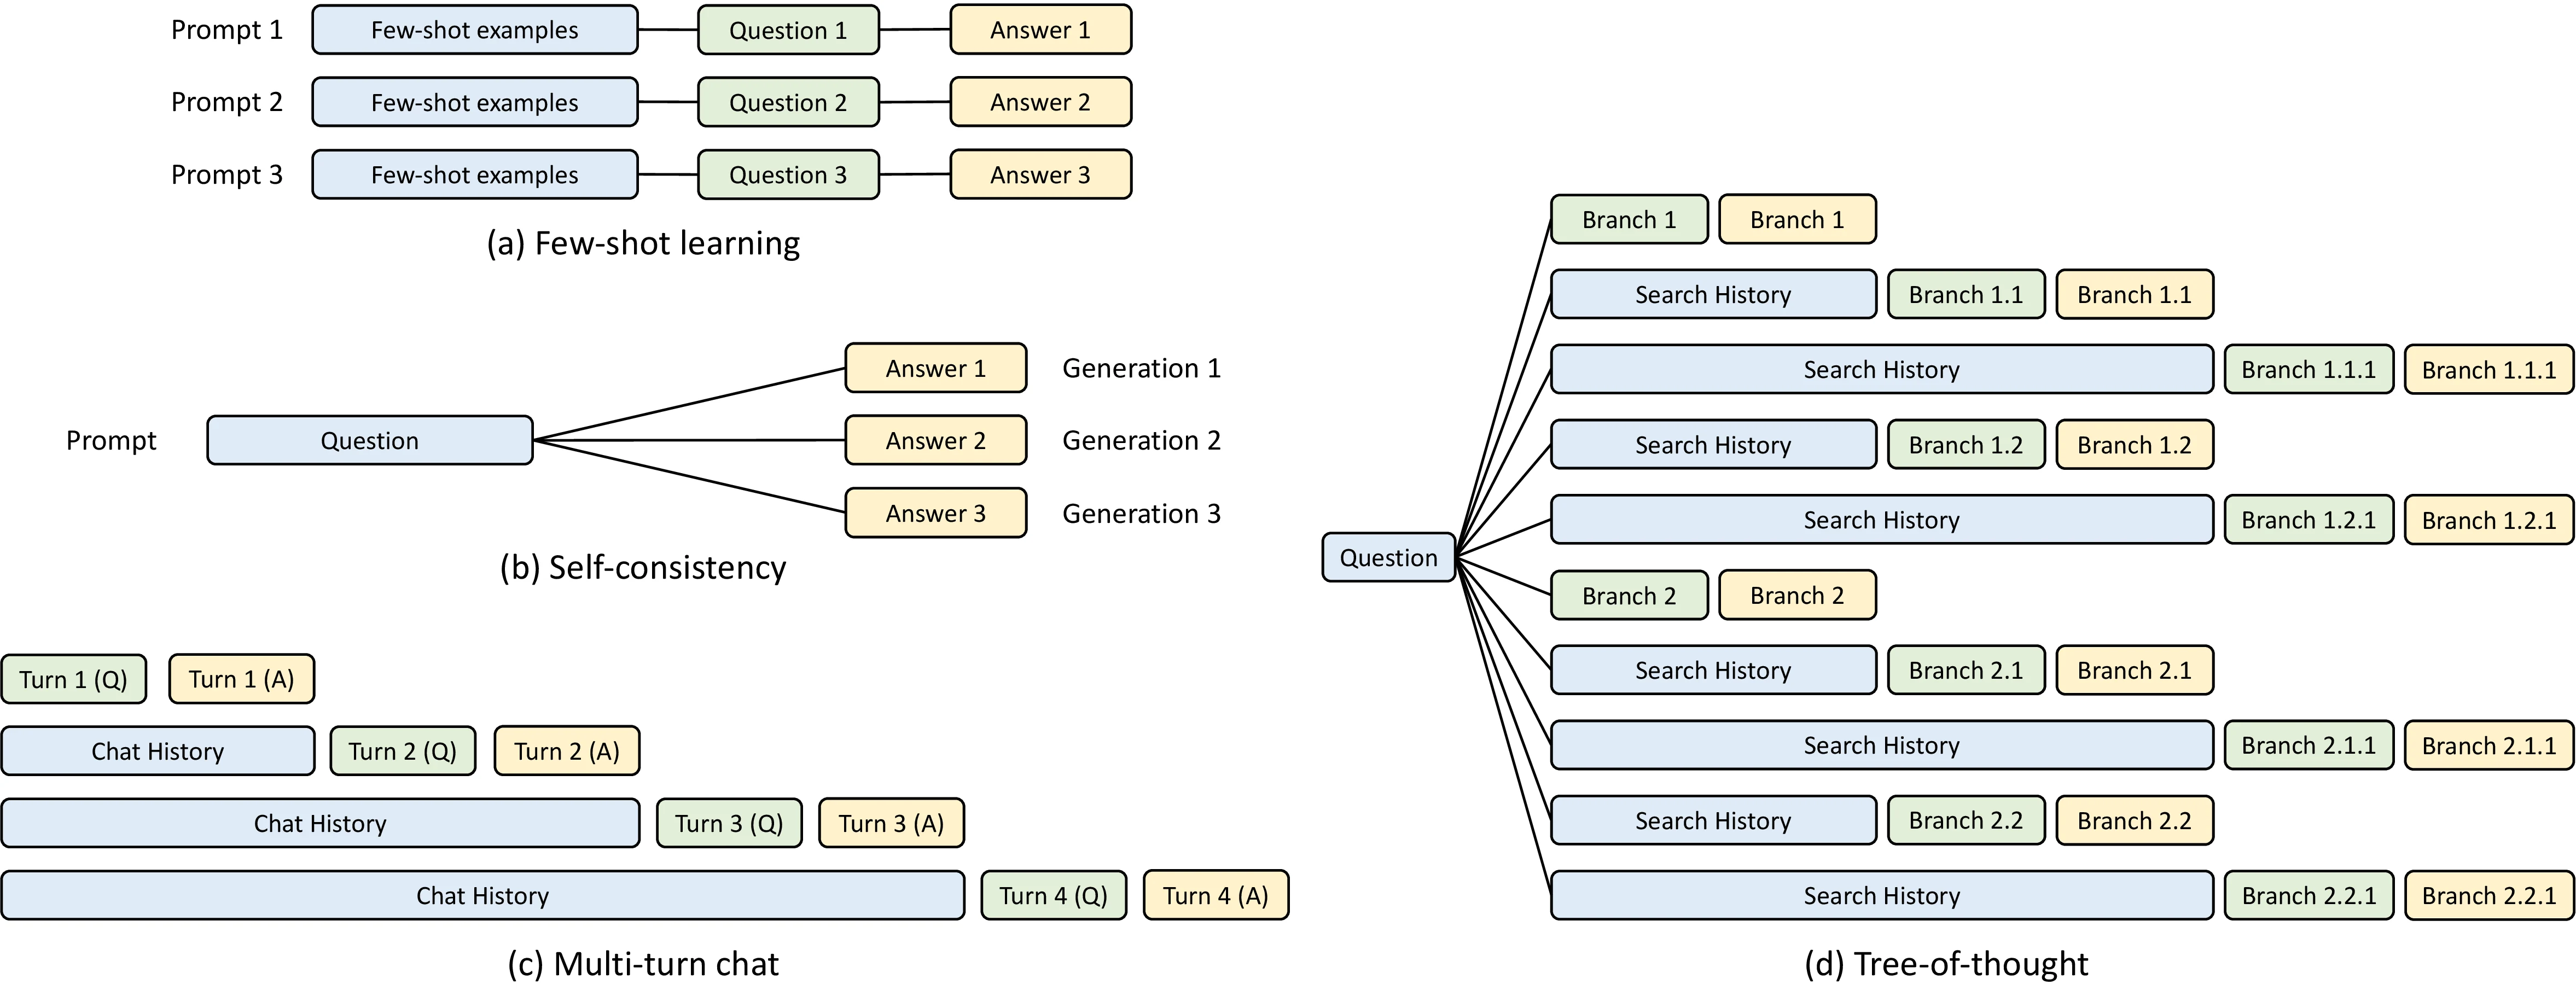
图源:SGLang 论文 Appendix Figure 9。蓝色块是可共享输入,绿色块是当前调用私有输入,黄色块是模型输出。Few-shot 示例、自一致性采样、多轮对话与树搜索的共享形状并不相同,这正是“按请求 ID 缓存整段 prompt”无法覆盖、而 token 前缀树可以统一表达的原因。
本文不再重复 RadixAttention 原理篇 对前缀树概念和论文实验的完整介绍,而是回答源码阅读时更容易卡住的五个问题:
ReqToTokenPool、token allocator、物理KVCache和RadixCache分别存什么;- 为什么树节点的
value是索引,而不是 K/V 张量; - 最长前缀匹配为什么可能修改树结构;
lock_ref怎样把“可驱逐缓存”临时变成“活动请求保护页”;- checkpoint、请求释放与 LRU 淘汰怎样保证一个物理页既不泄漏,也不被释放两次。
两层内存池与一棵索引树
memory_pool.py 开头给出了最简洁的架构说明:SGLang 有两层 memory pool,ReqToTokenPool 把请求映射到 token location,token allocator 管理这些 location 指向的物理 KV 数据,而 KVCache 持有真正的张量。源码中的对象较多,可以先压成四层:
Req / ScheduleBatch req_pool_idx = r │ ▼ReqToTokenPool.req_to_token[r, position] = slot_id │ CPU RadixCache │ token prefix -> [slot_id...] └──────────────────┬──────────────────────────┘ ▼TokenToKVPoolAllocator: slot/page 的空闲、分配与回收 │ ▼KVCache: 每层真正的 K/V tensor buffer第一层:请求行不是 KV 数据
ReqToTokenPool 初始化一个形状为
的 int32 张量 req_to_token。其中 是最多同时保留的请求行数, 是单请求最大上下文长度;多出的第 0 行专门给 CUDA Graph 的 padding batch 使用,使虚拟请求的默认索引落到安全位置。这里每个元素只有一个物理槽编号,不保存 K 或 V。
设请求行号为 ,逻辑 token 位置为 ,物理槽为 ,映射可以写成:
注意力 Kernel 再用 访问每一层的物理缓存:
是间接寻址表, 与 才是第 层的真实缓存。分页 KV 的“非连续”发生在 上:同一请求相邻 token 的 slot ID 可以来自不同页,但 req_to_token[r, :] 仍按逻辑序列顺序列出它们。Kernel 不必要求整条请求在显存中连续,只需读取这张表。
ReqToTokenPool.alloc(reqs) 还处理一个容易忽略的分支:chunked prefill 的后续 chunk 已经拥有 req_pool_idx,必须复用旧行,只有第一次进入的请求才从 free_slots 取新行。源码从列表尾部批量弹出行号,使复杂度与本次申请行数相关;释放时只把行号放回空闲列表,并将 req.kv.req_pool_idx 置空。
这也解释了两种“容量不足”为什么不是一回事:请求行不足表示无法再追踪更多并发序列;KV 槽不足表示还有请求行,却没有空间存下一批 token 的 K/V。前者受 batch/并发规模影响,后者受上下文长度、页大小、KV dtype、层数与 KV head 数影响。
第二层:allocator 管的是槽,KVCache 管的是字节
token allocator 的逻辑职责是维护可分配 slot/page 集合,并提供 alloc、free、available_size 与“先驱逐树缓存再重试”等操作。实际类会随普通 MHA、MLA、滑动窗口、Mamba、分层缓存和设备后端变化,但 Scheduler 依赖的是统一契约:给定要写入的 token 数,返回不冲突的位置;释放时按 allocator 的 page 粒度归还。
MHATokenToKVPool 则创建每一层的 K/V buffer,并根据 backend 采用 NHD、HND 或平台专用布局。以普通多头注意力为例,忽略 padding 与量化元数据,单个 token 的 KV 字节数近似为:
式中 是层数, 是 KV head 数, 是 head dimension, 是每个元素的字节数;系数 2 对应 K 与 V。物理池最多容纳的 token 数近似为可用于 KV 的显存除以 。GQA 减少 、KV 量化减少 ,都会直接扩大 slot pool;它们不会改变 ReqToTokenPool 的二维映射语义。
RadixCache:CPU 上的第二套索引
RadixCache 的 TreeNode.value 保存一段 torch.int64 物理 KV 索引,TreeNode.key 保存与之等长的 token 序列。树结构和 token key 主要驻留 CPU;真正的 KV 仍在设备 pool 中。若路径上三条边的 key 长度分别为 ,那么终点代表的逻辑前缀长度就是
而对应物理位置是三段 value 的串接。树不会复制 K/V 张量,只会多保存一条可复用的寻址路径。因此,同一物理 slot 可以同时出现在某个请求行和树路径中,但必须通过锁与 cache_protected_len 明确谁负责释放。
把这四层分开后,几个名字就不会混淆:req_pool_idx 是行号,kv_indices 是物理 token 槽,prefix_indices 是旧实现对命中路径的物化,当前基线更多通过 last_node 与 path_device_indices() 延迟取得路径,K/V buffer 才是大头显存。
一次 Extend 怎样把两层索引接起来
对一条已经命中 个 token、本轮还要计算 个 token 的请求,调度侧先确保它有请求行,然后把缓存路径对应的 slot 写入行前缀:
接着 allocator 为新 token 申请 个位置 ,写入:
本轮输入 token、位置、序列长度与新写位置被整理进 ForwardBatch。模型每层计算出新 K/V 后,以 为散写地址写进物理 pool;attention backend 同时根据请求行读取 与本轮新位置。于是一次 extend 的注意力历史在逻辑上连续,在物理上可以完全离散。
可以把一次写入的正确性条件写成:
并且对本轮新分配的集合要求:
是 pool 容量, 是其他未释放数据占用的槽集合。命中前缀允许与别的请求行重叠,所以不能粗暴要求整行 slot 全局唯一;真正必须互斥的是新分配写位置。很多 KV 错误排查失败,正是因为把“共享读地址合法”和“重复写地址非法”混成同一条去重规则。
这种间接寻址也解释了为什么 request row 必须在模型前向期间稳定。Kernel 可能异步读取 req_pool_indices、sequence length 和页表;CPU 若在 GPU 尚未完成时释放并复用该行,新请求会覆盖旧映射。普通 Scheduler 通过同步提交边界避免此事,Overlap Scheduler 则需要更精细地区分已发出、已完成与可回收批次,下一篇会专门展开。
为什么不让树直接取代请求行
树适合表达跨请求共享前缀,却不适合作为每轮 Kernel 的批量页表。首先,活动请求的最新后缀可能尚未达到 checkpoint 边界,根本不在树里;其次,从每个 last_node 沿 parent 链重建路径会产生不规则 CPU 工作;最后,CUDA Graph 希望输入 tensor 的形状和地址尽量稳定。ReqToTokenPool 用固定二维表提供设备友好的随机访问,RadixCache 用 CPU 树处理动态共享,两者是针对不同访问模式的互补结构。
由此也能理解内存开销的层次。请求表的字节数约为
因为元素为 int32;RadixCache 主要增加 token key、索引副本和 Python/C++ 节点元数据;物理 KV 则随层数、KV head 和 dtype 成倍增长。工程上常常值得用较小的索引开销换取大量 KV 计算复用,但 request table 的 仍需纳入超长上下文部署的显存预算。
RadixKey:前缀树究竟拿什么做键
最简单的答案是 token ID 序列,但生产实现还必须回答“相同 token 是否一定产生相同 KV”。RadixKey 因而包含 token_ids、extra_key、cache_salt、is_bigram 与可选 limit。
token_ids是基本序列;只有 token 前缀相同,因果注意力的历史 KV 才可能复用。extra_key建立逻辑命名空间。例如不同 LoRA adapter 即使输入 token 相同,权重不同也会产生不同 KV,不能跨空间命中。cache_salt同样隔离树与外部 KV 事件,适合显式禁止不可信请求之间的共享。limit让匹配只观察原数组前 个 token,而不必为token_ids[:n]做一次随上下文增长的 CPU 拷贝。is_bigram为 EAGLE 等投机路径提供相邻 token 对视图;它改变逻辑 key 单元,但仍保留原始 token 数组。
Req.init_next_round_input() 计算匹配上界时会留下至少一个未命中 token:
原因是生成与 prompt logprob 需要一个本轮输入位置来产生 logits。如果整条 fill 序列都只作为历史 KV 命中,前向没有 query token,便不能自然得到下一 token 的分布。这个“减一”不是缓存能力不足,而是自回归前向的语义边界。
当 page_size>1 时,page_aligned() 还会把 key 截到完整页:
其中 是页大小。部分页不能安全作为独立共享单元,因为 allocator 的释放和复用以整页为边界。树若记录半页前缀,后续释放整页就可能误伤仍被请求使用的槽;因此匹配、插入和回收必须使用同一页粒度。
还有一个容易被 key 名称掩盖的事实:缓存安全不仅由 token 决定。位置编码配置、模型权重版本、LoRA、KV dtype/布局以及多模态 embedding 都可能改变相同 token 的 K/V。并非所有差异都直接编码进 RadixKey;有些由“每个模型实例拥有独立缓存”保证,有些通过 extra_key / cache_salt 隔离,有些场景则干脆禁用匹配。阅读新增特性时应先问:它是否改变 KV 的函数输入?如果答案为是,就必须能指出缓存命名空间在哪里被区分。
match_prefix:最长前缀匹配与节点分裂
压缩树的边存一段 token,不是一个 token
普通 trie 的每条边只存一个符号,长 prompt 会产生大量只有一个孩子的节点。radix tree 把连续单分支压成一条边,因此 TreeNode.key 与 TreeNode.value 都是一段序列。节点还保存 children、parent、lock_ref、last_access_time、hit_count 与 eviction priority。children 的字典键不是完整前缀,而是子边第一个逻辑单元;确定候选子边后,再逐项比较整段 child.key。
把查询 key 记为 ,当前边 key 记为 ,两者最长公共前缀长度为
匹配循环有三种结果:
- 没有以
Q.child_key(page_size)开头的子边,匹配在当前节点结束; - ,整条边命中,把
child.value加入结果,继续用 向下; - ,查询在压缩边内部结束,需要先把边切出一个真实节点。
最后一种情况说明 match_prefix() 并非纯只读操作。假设树中已有:
root -- [A B C D E] / [10 11 12 13 14] --> leaf新查询只有 [A B C]。若直接返回旧 leaf,last_node 会代表五个 token,锁定和释放边界都会多出 [D E]。_split_node() 因而改写为:
root -- [A B C] / [10 11 12] --> middlemiddle -- [D E] / [13 14] --> leaf新节点继承原节点的 priority、hit_count 与 lock_ref,旧节点保留后半段 key/value。物理 KV 没有复制;.clone() 复制的是很小的索引 tensor。分裂的目标是让命中终点、锁终点与可淘汰边界一致。
match_prefix() 返回的 MatchResult 中,普通单层 RadixCache 的 last_device_node、last_host_node 与 best_match_node 是同一个节点。接口之所以保留三个字段,是为了兼容 HiCache 等分层实现:最长逻辑命中可能在 host,而已经位于 GPU 的命中终点更短。Scheduler 应依赖接口语义,不能把当前三者相等写成永久假设。
为什么只返回终点,不长期复制整条路径
当前基线用 last_node 保存命中终点,需要物理索引时调用 path_device_indices():从终点沿 parent 回到 root,收集各段 value,反转后拼接。这样请求长期保存的是一个树节点句柄,而不是每轮都复制随上下文增长的完整索引数组。
代价是节点句柄依赖树结构稳定。只要请求可能使用这条路径,就必须加锁阻止相关节点被驱逐;匹配结果在下一次 allocation 或 eviction 后是否仍有效,也由 BasePrefixCache 的接口注释明确约束。换句话说,last_node 不是普通缓存查询结果,而是一张需要生命周期管理的借用凭证。
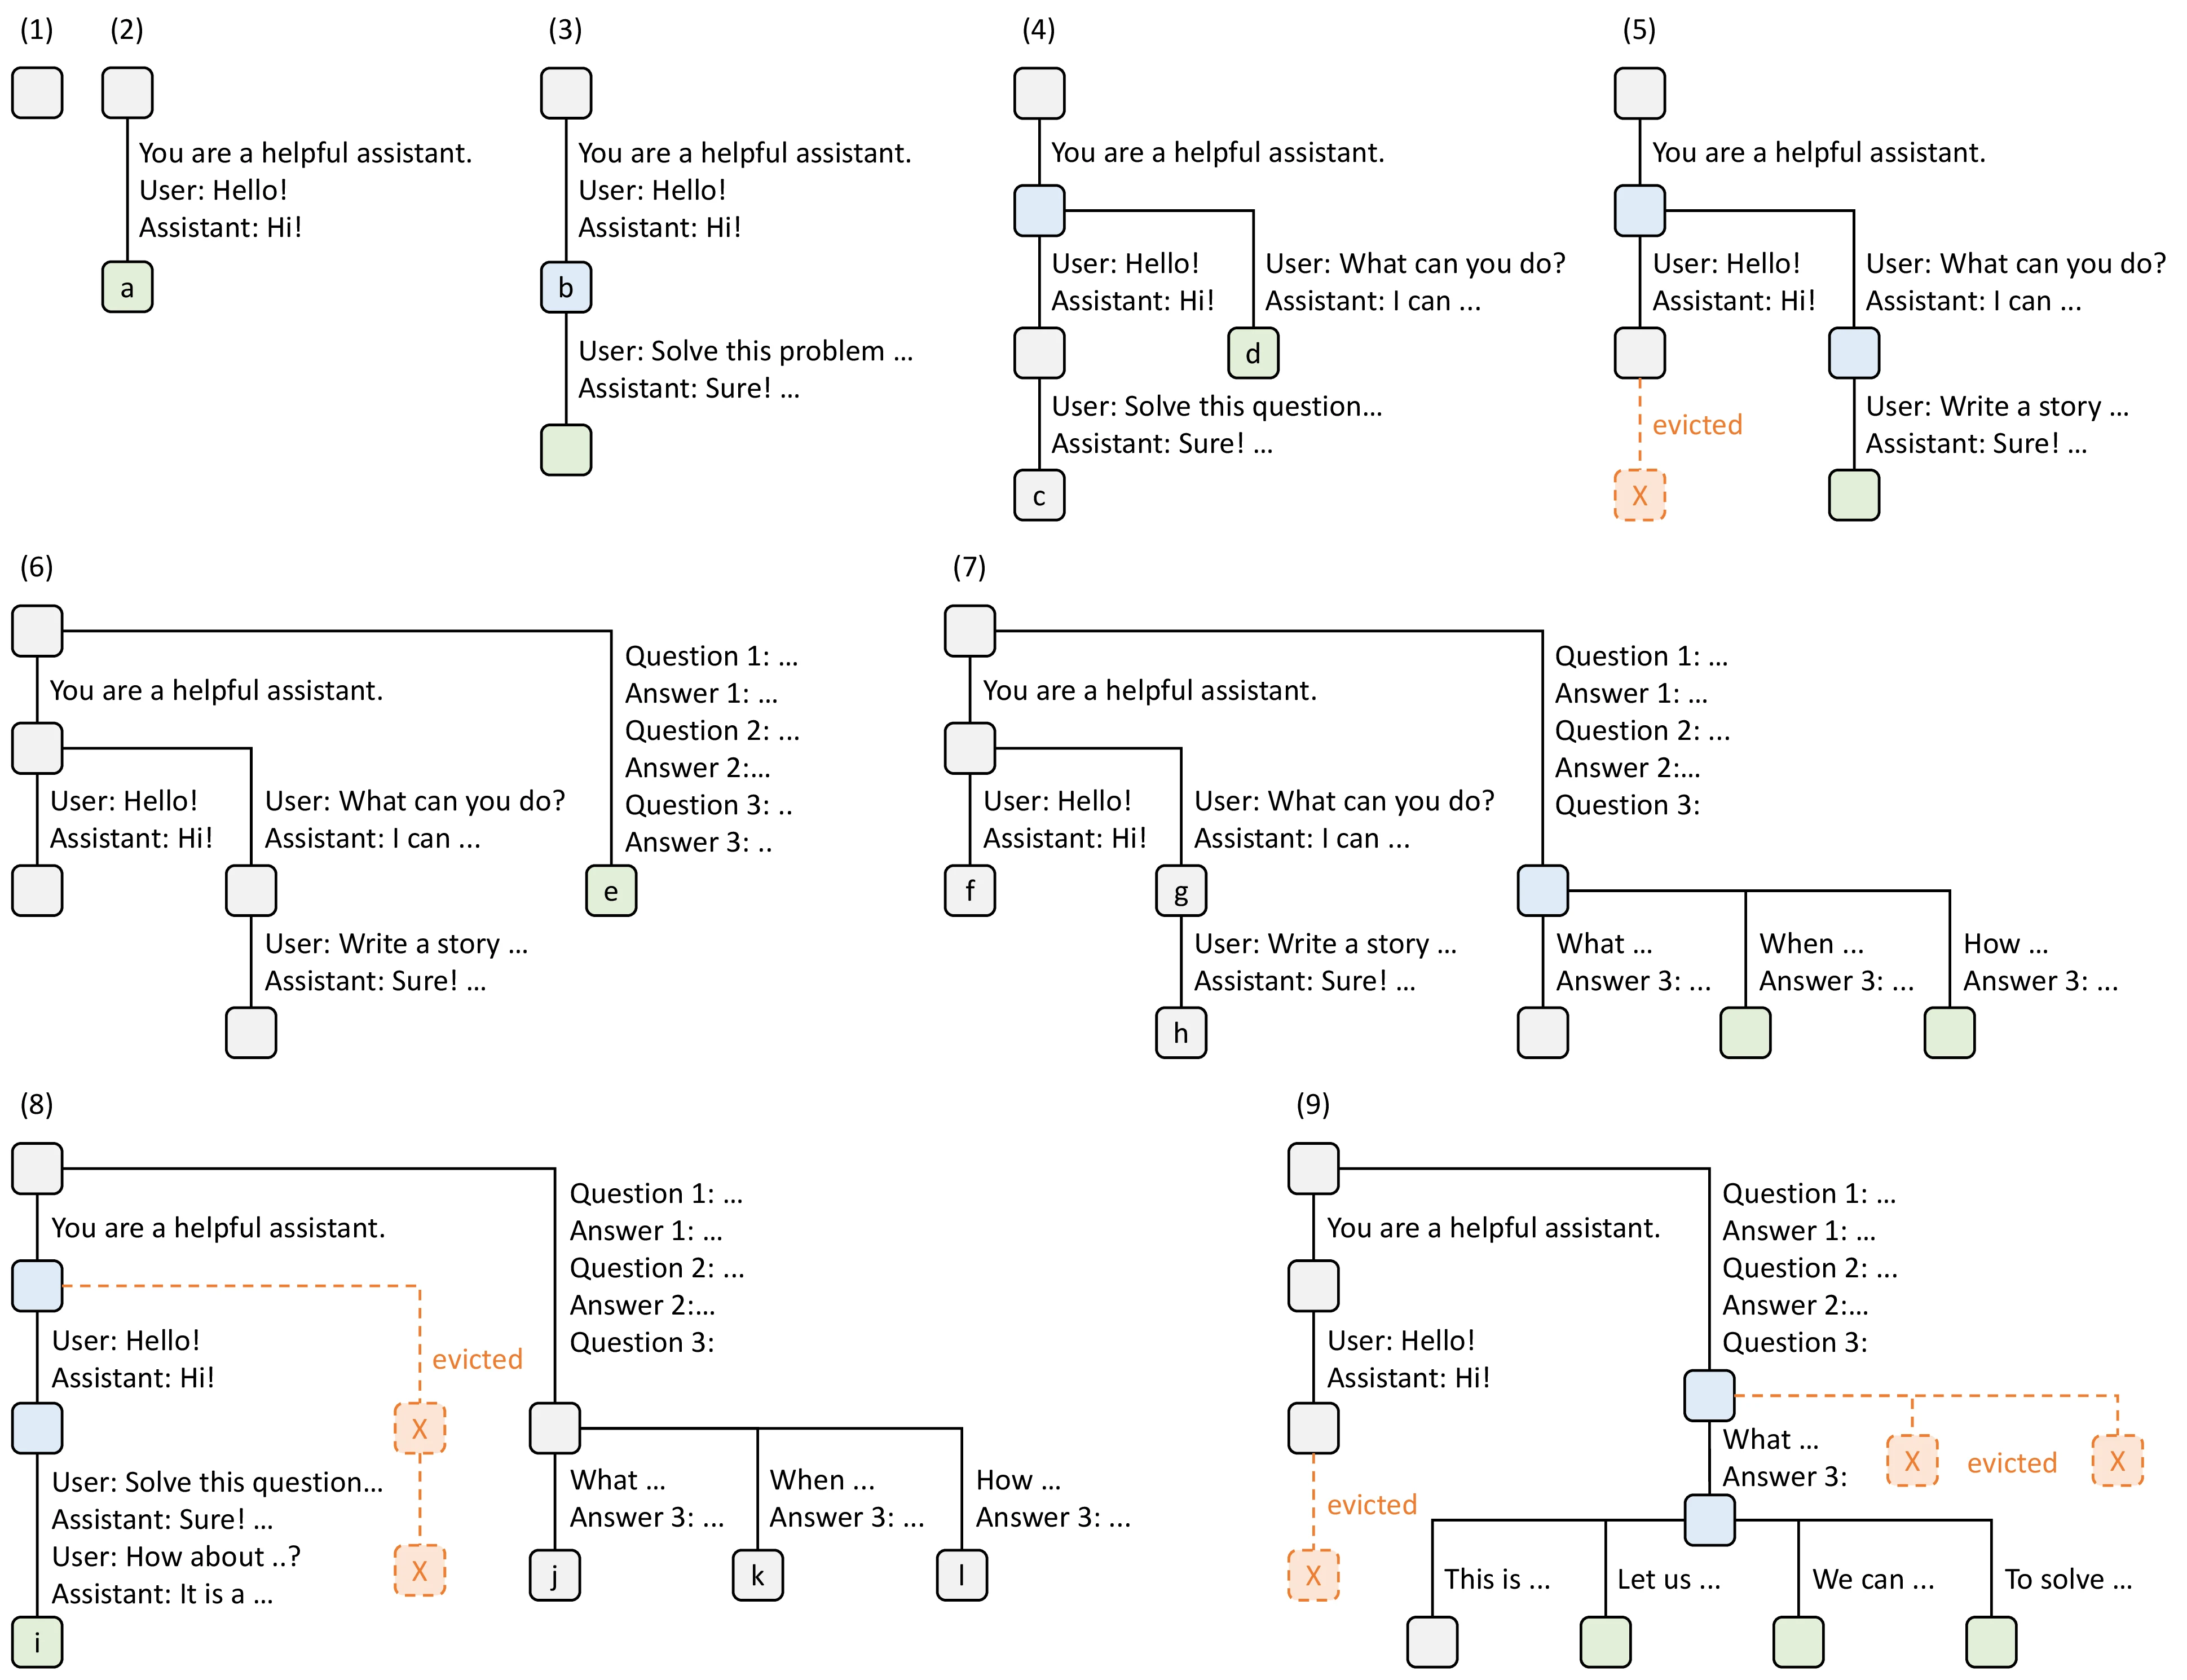
图源:SGLang 论文 Figure 3。图中每条边承载一段 token,绿色表示新插入,蓝色表示本时刻访问的缓存,红色表示被淘汰的节点。第 7 步为了暴露共享 few-shot 前缀而分裂节点;第 8、9 步则从最久未访问的叶子回收空间。源码中的 _split_node() 与 _delete_leaf() 正是这两类结构变化的落点。
用伪代码保留主干
真实实现还要处理 page alignment、EAGLE bigram、事件 hash 与访问优先级。去掉这些分支后,最长匹配主干只有以下几步:
def match(node, key): values = [] while key and first_unit(key) in node.children: child = node.children[first_unit(key)] n = common_prefix_len(child.key, key)
if n < len(child.key): node = split(child, n) values.append(node.value) break
values.append(child.value) node = child key = key[n:]
return concat(values), node若树深为 、实际比较了 个 token,则搜索代价可写成 ;压缩边减少了 Python 节点跳转,却不能省掉必要的 token 比较。长上下文下,CPU 端重复走完整前缀仍可能成为瓶颈,这也是后续 C++/统一缓存实现持续优化树遍历的原因。
锁引用:命中为什么会改变可回收容量
lock_ref 不是“这个节点本身被几条请求直接指向”,而是“有多少锁路径经过这个节点”。inc_lock_ref(last_node) 从命中终点一直走到 root 的孩子,对整条祖先路径加一;dec_lock_ref() 做相反操作。只有这样,锁住深层前缀时,其共享祖先才不会被淘汰。
设节点 的边长为 ,锁前 lock_ref(v)=0,第一次加锁会进行:
是 evictable_size_, 是 protected_size_。若锁计数从 1 增到 2,物理页仍只从“可驱逐”转移过一次,所以两个计数不再变化。解锁时也只有从 1 变 0 才反向搬账。
这正是第四篇 PrefillAdder 中临时锁会改变容量预算的原因。假设 allocator 只剩 20 个空闲 token,树里有 100 个可驱逐 token;某请求命中其中 64 个并将路径锁住后,可承诺给其他请求的容量不是 ,而是
如果接纳器先按 120 计算容量,再锁命中路径,就会把同一批 64 个 slot 同时承诺给当前请求和未来淘汰,形成超售。源码因此在尝试接纳时先临时 pin,成功后把锁交给 req.lock;失败则通过上下文管理器立即解锁。
锁对象 TreeLock 还保存 inc_lock_ref() 返回的 receipt,供对应的 dec_lock_ref() 使用。普通 RadixCache 只需节点与 delta,统一/分层缓存可能需要更复杂的组件级信息。封装锁而不是到处手工加减引用,有两个工程收益:异常路径更容易释放,缓存实现也能扩展而不把 Scheduler 改成大量类型判断。
树维护 evictable_leaves 集合,而不是每次 O(整棵树) 扫描。_update_leaf_status(node) 只在节点的孩子数量或锁状态变化时更新候选集:无孩子且 lock_ref==0 才是可驱逐叶子。一次插入、分裂、加锁或解锁,都必须同步维护这个集合;漏掉任何一处都可能让明明可回收的页永远不进淘汰堆,或者让活跃路径成为错误候选。
checkpoint:分块 Prefill 后如何写回
当前基线已经不再以 cache_unfinished_req() 作为公共入口。分块 Prefill 的中间 chunk 完成后,checkpoint_kv_cache() 调用 tree_cache.checkpoint(req, up_to=req.extend_end);自然完成时,release_kv_cache(..., checkpoint=True) 也会先 checkpoint,再释放请求行。继续使用旧函数名理解代码容易漏掉新的 cache_protected_len 与统一释放契约,因此本节按当前调用链说明。
第一步:从请求行截取 token 与 slot
checkpoint 先取 full_untruncated_fill_ids[:up_to],再从
req_to_token_pool.req_to_token[req.kv.req_pool_idx, :len(token_ids)]取出同长度的 kv_indices。二者必须位置对齐:第 个 token 的 key 与第 个 slot value 共同组成一条树边。随后按 page size 截齐,并复制索引 slice。复制索引的必要性在于请求行稍后会回收和复用,树不能保留指向可变行的 view。
第二步:插入时识别重复物理 KV
insert() 沿已有路径比较 key。若某段前缀早已在树中,返回 prefix_len;剩余后缀才创建新 TreeNode。这里存在两份“内容相同但槽不同”的 KV:树中旧前缀指向槽 ,本请求刚计算的相同前缀可能指向槽 。保留两份没有意义,_insert_cache() 会释放请求私有区间内被现有树前缀覆盖的槽:
[0, cache_protected_len) 之前已由树保护,不归请求释放[cache_protected_len, matched) 本轮发现为重复,释放请求副本[matched, key_len) 新插入树的后缀,树接管[key_len, allocated_len) 部分页或预分配尾部,仍由请求管理cache_inserted_len 用来区分当前请求此前已经发布的部分与真正的新命中,避免统计和事件重复。对 chunked prefill 来说,每个 chunk 都会推进该边界;这不是“每轮重新缓存完整 prompt”,而是把已经算完的连续前缀逐步发布。
第三步:重新匹配并改写请求行
插入之后,checkpoint 再调用一次 match_prefix(),得到规范化后的 new_last_node,通过 path_device_indices() 取得树选择的整条物理路径。随后只改写请求行中从旧 cache_protected_len 到新路径末端的部分。
为什么不直接继续使用插入前的 kv_indices?因为插入可能发现同 key 已由另一条请求先发布,规范路径会选择树中已有 slot,并释放当前请求的重复 slot。请求行必须改指向树的 canonical copy,否则下一轮 attention 仍可能读取已释放位置。
最后,cache_protected_len 更新为树路径长度,旧锁释放,新锁锚定 new_last_node。这三个动作必须共同提交:只改行不换锁会让新后缀可被驱逐;只换锁不改行会让行仍引用重复或已释放槽;只推进长度不处理部分页,会在请求结束时越过所有权边界。
当 page size 大于 1 时,尾部不满一页的 token 仍留在请求行,却不进入树。cache_protected_len 因而总是页对齐,并准确标出“左侧由树持有、右侧仍由请求持有”的分界。
release_kv_cache:完成请求如何交还 KV 所有权
同样,当前入口是 release_kv_cache(req, tree_cache, checkpoint=...)。它既服务于自然完成,也服务于 abort、retract 等不应写回缓存的路径。核心区别只有一个布尔值:释放前是否把有效 KV 发布到树。
自然完成时的顺序是:
refresh_fill_ids -> checkpoint(up_to=owned_kv_len) -> free request-owned [cache_protected_len, owned_kv_len) -> unlock tree path -> release speculative / overallocated tail -> free req_pool row -> mark_kv_released这里最容易误读的是 checkpoint 后又调用 free_kv_row():既然刚缓存,为什么马上释放?因为 checkpoint 已把完整页范围纳入树并将 cache_protected_len 推到相应边界,后续释放区间从新边界开始,只清理未被树接管的部分页或请求私有尾部。树保护区不会被请求释放。
retract 为了尽快腾出空间,通常走 checkpoint=False。它保留 prompt 与已生成 token 的语义历史,却放弃本请求尚未发布的物理 KV;重新入队后再通过 RadixCache 命中可复用部分,其余部分重算。Abort 也不能把未确认有效或不希望共享的状态无条件发布。由此可见,release 不是“释放全部 KV”的同义词,而是一次所有权结算。
完成请求还可能有 speculative decoding 的预分配尾部。owned_kv_len 表示真正有语义所有权的有效长度,kv_allocated_len 可能更长;_release_overallocated_kv_indices() 单独回收多分配位置。若直接按逻辑 token 长度释放整页而忽略 allocator page size,就可能重复释放同一页,因此公共释放路径还要合并相邻区间,并使用 allocator 的页宽对齐。
evict:为什么只从叶子开始淘汰
物理池需要 个 token 槽却分配失败时,allocator 可以要求 tree cache 驱逐至少 个可驱逐 token。RadixCache.evict() 先把 evictable_leaves 放入 heap,优先级由所选 eviction strategy 计算;经典策略是 LRU,即 last_access_time 最老者先出队。
每次弹出叶子 后,源码依次执行:
free_segment(x.value),把这一整段页对齐 slot 归还 allocator;_delete_leaf(x),从父节点的children删除边并扣减evictable_size_;- 若父节点因此变成无锁叶子,把父节点加入 heap;
- 记录 KV remove 事件与驱逐统计。
为什么不能直接淘汰最老的任意节点?因为内部节点的 KV 是所有后代前缀的一部分。删掉内部节点但保留子树,会让子树 token key 失去从 root 可达的完整前缀,也会让后代 value 的逻辑位置失效。叶子删除保持剩余树闭合;父节点在最后一个孩子消失后成为新叶子,才有资格继续被回收。
叶子优先并不等于“只淘汰很长 prompt 的结尾”。压缩树节点可能承载很多 token,一次删除会超过目标 。这属于页/节点粒度的内部碎片:实现承诺“至少腾出足够容量”,而不是精确释放恰好 个 token。更细节点能减少超额驱逐,却会增加 CPU 节点数和遍历开销,这正是 radix 压缩粒度与回收精度之间的权衡。
LRU 时间在 match、insert 与 touch 时更新。touch_prefix() 只刷新已缓存路径,不触发外部层级加载;调度器可在等待请求排序时用它保护即将使用的热前缀。若只在真正执行后更新时间,长时间排队的热门前缀可能在即将接纳前被其他请求挤出。
优先级策略也不只看时间。当前 TreeNode 还带有 priority 与 hit_count,插入时把请求 priority 沿路径取最大值传播。无论策略怎样变化,有两个硬约束不变:候选必须是叶子,且 lock_ref==0。策略只能决定“可驱逐集合里先删谁”,不能越过活动引用安全线。
可用、可驱逐与受保护三本账
读日志时应区分:
allocator.available_size():此刻已经空闲、可立即分配的容量;tree_cache.evictable_size():仍装着缓存,但可通过 eviction 变成空闲的容量;tree_cache.protected_size():树中被活动请求锁住、不能用于本轮回收的容量。
在普通单组件池中,可以把潜在可分配上界近似写成:
但它不是永远精确的恒等式。page size 会带来向上取整,滑动窗口和混合模型可能有多类 allocator,分层缓存还涉及 host/device load-back;当前源码甚至会在 page-interleave sharding 下循环驱逐,直到 available_size() 真正达到要求。安全做法是把 available_size() 当分配事实,把 evictable_size() 当潜在供给,最终仍由 allocator 的实际申请结果裁决。
从请求到缓存的完整生命周期
用两个请求 A、B 串起全部对象。设 page size 为 4,A 的 token 为 [10,11,12,13,20,21],B 为 [10,11,12,13,30]。
A 第一次进入
树为空,A 的最长命中为 0。ReqToTokenPool 给 A 分配行 ,allocator 为前四个 token 分配一页物理槽 [100,101,102,103]。第一次 chunk 执行后:
R[r_A, 0:4] = [100, 101, 102, 103]checkpoint 把 key [10,11,12,13] 与 value [100,101,102,103] 插入树,设置 cache_protected_len=4,并锁住该节点。A 的剩余 [20,21] 在后续 forward 中获得其他槽;不足一整页的尾部暂时仍属请求。
B 到达并命中
B 的匹配上界是 ,恰好命中树中的完整页,得到 prefix_len=4 与相同物理路径 [100,101,102,103]。B 获得自己的请求行 ,但前四个位置写入同一组 slot:
R[r_A, 0:4] = [100, 101, 102, 103]R[r_B, 0:4] = [100, 101, 102, 103]这不是两份 KV,而是两张逻辑行共享四个物理位置。B 锁住命中节点后,路径的 lock_ref 再加一;即使 A 结束并解锁,B 仍在运行,页也不能被驱逐。
A 完成
A 的 release 先把页对齐的有效后缀 checkpoint 到树,再释放未进入树的尾部或过量预分配,解锁路径并归还请求行 。此时 slot [100..103] 仍由树与 B 引用,不会进入 allocator 空闲表;“请求行释放”和“KV 页释放”完全是两件事。
B 完成后发生内存压力
B checkpoint 自己的 [30] 分支,但 page size 为 4 时不足一页,是否进入树取决于后续补齐与有效长度。B 解锁共享路径并释放行后,已缓存且无锁的叶子进入 evictable_leaves。新 batch 申请空间不足,evict 才真正把某个冷叶子的 value 归还 allocator。
这条时间线揭示三个不变量:
三个区间可以为空,但不能重叠释放。checkpoint 推进第一条边界,正常/异常 release 结算第二条边界,投机或批量预分配清理第三条边界。
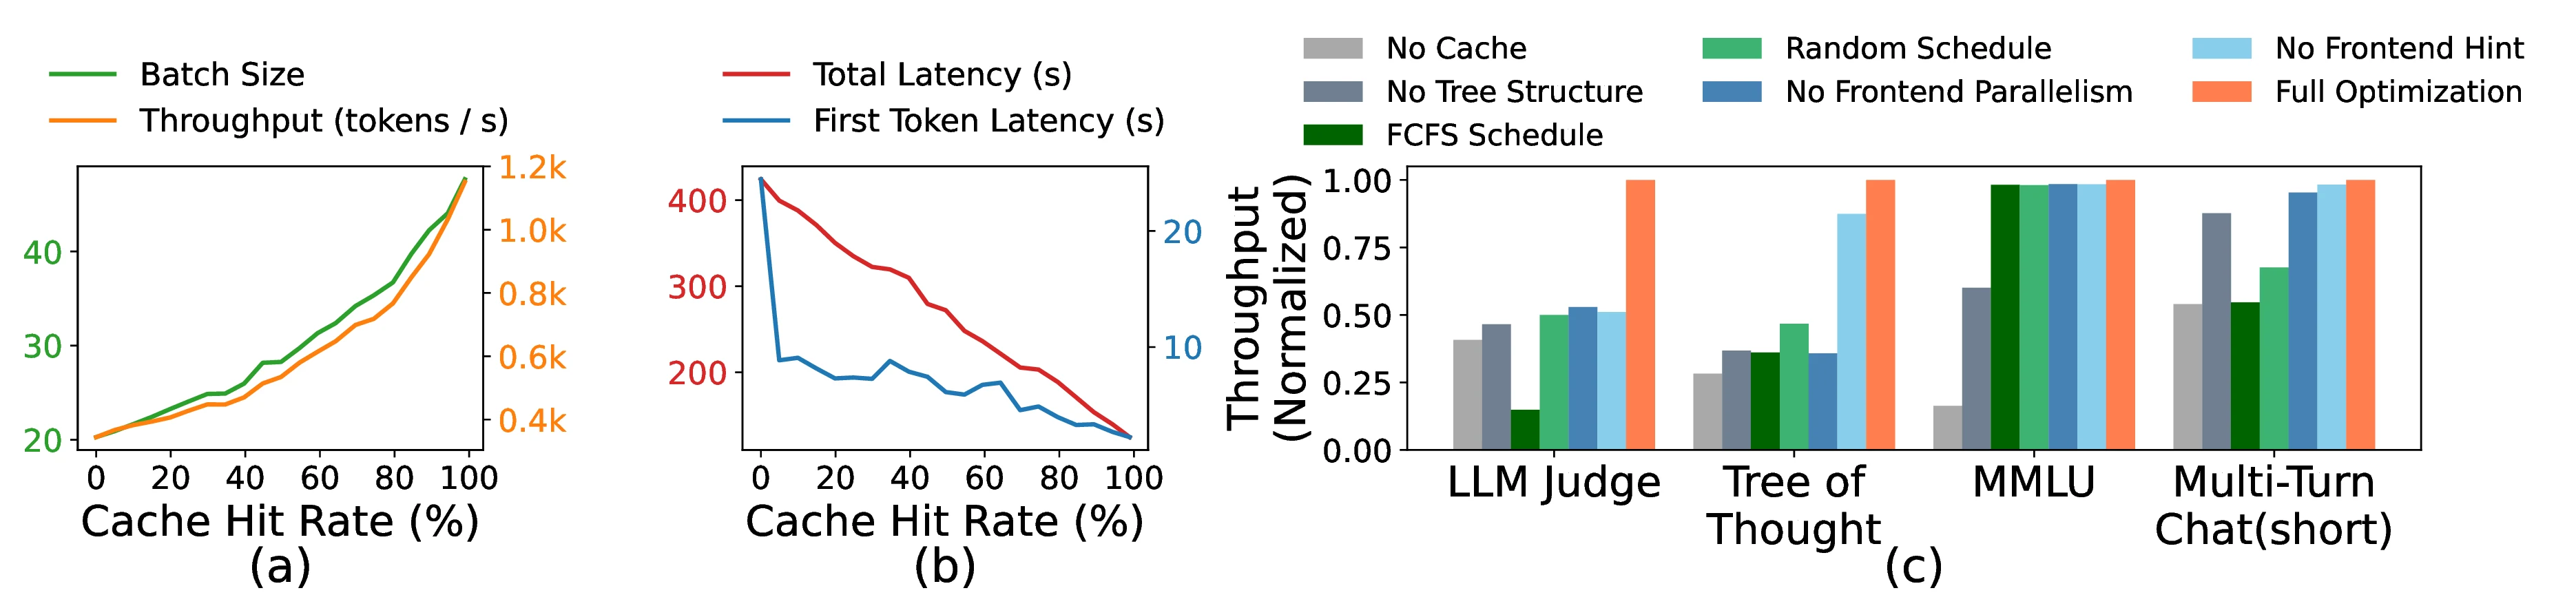
图源:SGLang 论文 Figure 8。左侧比较不同缓存策略的命中率,右侧比较关闭 RadixAttention 等组件后的吞吐。论文结果说明前缀复用的收益来自“少算 token”与“调度维持命中”共同作用;这些数据基于论文版本、模型与工作负载,不能直接外推到当前提交或任意线上流量。
源码阅读与调试路径
先沿所有权走,不要先钻进张量布局
建议用一个两请求、单 GPU、无投机、无 HiCache 的最小例子,按以下顺序打断点:
Req.init_next_round_input -> match_kv_cache -> RadixCache.match_prefix
PrefillAdder / ScheduleBatch.prepare_for_extend -> lock matched node -> ReqToTokenPool.alloc -> token allocator alloc -> write req_to_token row
Batch result commit -> checkpoint_kv_cache -> RadixCache.checkpoint -> _insert_cache / insert / match_prefix
Finish / abort / retract -> release_kv_cache -> free_kv_row -> unlock -> ReqToTokenPool.free第一遍只记录长度和索引,不查看所有层的 K/V 数值。推荐的观察表如下:
| 观察时刻 | 必看字段 | 应满足的关系 |
|---|---|---|
| 匹配后 | prefix_len、last_node | prefix_len <= input_len - 1 |
| 接纳后 | req_pool_idx、kv_allocated_len | 活动请求拥有唯一有效行 |
| 分配后 | req_to_token[row, :n] | 已提交位置不含未分配 slot |
| checkpoint 后 | cache_protected_len、树路径长度 | 二者相等且按页对齐 |
| 锁迁移后 | 旧/新路径 lock_ref | 新路径受保护,旧私人锁已释放 |
| release 后 | req_pool_idx、is_kv_released | 行已归还,状态只转换一次 |
| eviction 后 | allocator available、树总长度 | 空闲增加,树对应叶子消失 |
源码导航可以直接使用:
rg -n "class (ReqToTokenPool|MHATokenToKVPool)" \ python/sglang/srt/mem_cache/memory_pool.py
rg -n "class (RadixKey|TreeNode|RadixCache)" \ python/sglang/srt/mem_cache/radix_cache.py
rg -n "def (match_kv_cache|checkpoint_kv_cache|release_kv_cache)" \ python/sglang/srt/mem_cache/common.py用断言定位所有权错误
若遇到 illegal memory access、生成内容随机损坏或 KV 泄漏,不要只盯 attention Kernel。可以按以下顺序缩小范围:
- 在写 KV 前检查每个 slot 是否位于 pool 合法范围,且本 batch 内需要唯一的位置没有重复;
- checkpoint 前检查 token key 与
kv_indices长度一致; - checkpoint 后检查请求行的保护区与
path_device_indices(last_node)完全相同; - release 前把三个所有权区间打印出来,确认无负长度、无交叠;
- eviction 时确认候选是无锁叶子,释放长度等于
len(node.value); - 请求行复用时比较
req_generation,排除旧异步读者把新请求的同一行当成旧状态。
ReqToTokenPool.clear() 特意不把 req_generation 清零,因为某些读者用 generation 判断行是否已经复用。若清零,经历足够少的重启/清理后,新请求可能恰好得到与旧请求相同的 generation,迟到消息就无法识别 ABA 式复用。这类字段看起来与 KV 算法无关,却是异步系统正确性的组成部分。
看懂日志里的“内存够不够”
排查 OOM 时至少同时打印四组量:request row 的 free count、allocator 的 available token/page、tree 的 evictable/protected size、每条请求的 kv_allocated_len 与 cache_protected_len。只看 torch.cuda.mem_get_info() 解释不了预分配 pool 内部是否有槽;只看 pool available 又解释不了多少冷缓存可以驱逐。
若 available=0、evictable>0,说明可通过淘汰扩容;若二者都为 0 但 protected 很大,说明活跃 batch 或临时接纳锁住了容量;若 request rows 先耗尽,增加 KV 显存也无法提升并发。把这三类压力分开,才能决定该调 batch、上下文上限、页大小还是缓存策略。
边界条件与常见误读
误读一:RadixCache 自己保存 K/V tensor
树节点只保存 token key 与物理 slot 索引。物理 K/V 由 KVCache 持有,allocator 管理 slot 的生死。树的 CPU 内存开销和 KV 的 GPU 显存开销不在一个数量级,也不能用删除 Python 节点替代 allocator free。
误读二:匹配是只读查询
查询若停在压缩边内部,会调用 _split_node() 暴露精确终点;每次查询还刷新访问时间。并发化或迁移到 C++ 时必须保留这些写语义,不能把 match 当无锁只读函数随意并行。
误读三:命中前缀不占容量
命中避免新分配与重复计算,却会把命中路径从 evictable 变成 protected。对单条请求,它几乎不增加物理占用;对接纳器,它会减少可承诺的驱逐容量。两句话同时成立。
误读四:lock_ref 只加终点节点
终点依赖所有祖先边。锁必须沿 parent 链传播到 root,否则淘汰祖先会让终点成为不可达的悬空路径。解锁也必须沿同一路径对称执行。
误读五:checkpoint 会复制整段 KV
普通设备 RadixCache 主要复制的是 slot 索引,并在必要时让请求行改指向既有 canonical slot;真实 K/V 通常仍在原物理池位置。HiCache load-back、设备迁移或特殊组件可能发生数据搬运,但那不是 radix 插入的普遍语义。
误读六:请求结束就应立即 free 全部 slot
可复用前缀要由树继续持有。结束路径先 checkpoint,再只释放树未接管的范围,最后释放请求行。立即 free 全部 slot 会让树留下指向空闲甚至已被重用位置的悬空索引,产生静默错误。
误读七:禁用 RadixCache 后可以删除缓存接口
Scheduler 仍需要统一的匹配、checkpoint、release 与容量调用。禁用前缀共享时可用空实现或 chunk cache 保持接口契约,这比在所有调用点散布 if disable_radix 更容易维护;chunked prefill 仍需跨轮记录已分配 KV。
误读八:page size 只影响性能,不影响正确性
page size 同时决定匹配截断、插入长度、free 粒度与 cache_protected_len 边界。任何一处用 token 粒度、另一处用 page 粒度,都可能产生重复释放或半页悬挂。性能上的内部碎片只是表象,底层首先是所有权原子性。
还需单独审查的分支
- LoRA 或其他改变权重的上下文必须通过
extra_key隔离; - 自定义 positional embedding override 不能只凭 token ID 共享 KV,当前请求会禁用前缀匹配;
- EAGLE bigram key 的逻辑长度与原始 token 数不同,key/value 截断必须一致;
- speculative verify 可能一次预分配多个位置,并在接受长度确定后回收尾部;
- sliding-window attention 已经丢弃窗口外状态,不能把普通全注意力的前缀规则原样套用;
- Mamba/混合模型除 token KV 外还有 recurrent state,checkpoint 可能需要转移组件状态;
- HiCache 的 host hit 不等于 device hit,load-back 完成前不能把它计入可执行
prefix_len; - P/D 分离会让 KV 所有权跨节点传输,远端完成与本地释放之间需要额外握手;
- 多模态输入即使 token 占位符相同,底层图像 embedding 不同也不能错误共享。
小结与后续路线
SGLang 的 KV 管理可以归纳为“一份物理数据、两套索引、三段所有权”。KVCache 保存每层真实 K/V,token allocator 管理物理槽;ReqToTokenPool 用请求行表达活动序列,RadixCache 用压缩前缀树表达跨请求复用。两套索引可以同时指向同一物理页,但树保护区、请求私有区与过量预分配区必须由 cache_protected_len、有效长度和分配长度严格分开。
最长前缀匹配会页对齐 key,并在压缩边内部建立精确节点;锁从终点传播到所有祖先,把 evictable 容量转为 protected 容量。checkpoint 把已计算前缀发布到树,释放重复副本,重写请求行并迁移锁;release 再根据正常完成、abort 或 retract 决定是否写回,然后逐段归还资源。内存压力到来时,eviction 只删除无锁叶子,保证剩余树仍是从 root 可达的完整前缀集合。
SGLang 源码系列当前进度如下:
| 序号 | 主题 | 状态 |
|---|---|---|
| 一 | 整体架构、进程拓扑与请求数据流 | 已完成 |
| 二 | Entrypoints、TokenizerManager 与 DetokenizerManager | 已完成 |
| 三 | Scheduler 请求状态机 | 已完成 |
| 四 | PrefillAdder、调度策略与 chunked prefill | 已完成 |
| 五 | KV 内存池与当前 RadixCache 源码 | 本篇 |
| 六 | Overlap Scheduler | 下一篇 |
| 七 | ForwardBatch、TpModelWorker 与 ModelRunner | 待写 |
| 八 | Attention Backend | 待写 |
| 九 | CUDA Graph 与编译路径 | 待写 |
| 十 | Sampling、Grammar 与结构化输出 | 待写 |
| 十一 | 投机解码 | 待写 |
| 十二 | TP 与 PP | 待写 |
| 十三 | DP Attention、EP 与 MoE | 待写 |
| 十四 | Prefill/Decode 分离与分布式 KV | 待写 |
下一篇将进入 Overlap Scheduler:CPU 如何在上一轮 GPU 前向尚未完成时准备下一轮 batch,last_batch 与 future token 怎样跨过在途边界,以及 overshoot、完成提交和缓存 checkpoint 为什么必须延迟到安全点。
参考资料
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv)
- SGLang 论文(NeurIPS 2024)
- SGLang 官方 GitHub 仓库
- RadixCache 源码(固定提交)
- BasePrefixCache 接口(固定提交)
- KV 内存池源码(固定提交)
- KV 匹配、checkpoint 与释放公共路径(固定提交)
- Req 与 ScheduleBatch 源码(固定提交)
- SGLang Radix Cache Eviction Policies 官方文档
- SGLang HiCache 官方文档
- RadixAttention 完全拆解:用前缀树自动复用 KV Cache
- SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


