


SGLang 源码完全拆解(四):PrefillAdder 如何预算 KV、切分长提示并组装 Prefill Batch
从请求状态机走进接纳控制
上一篇 SGLang 源码完全拆解(三):Scheduler 请求状态机如何闭环 已经把一条请求从 waiting_queue、extend、running decode 一直追到完成、Abort 与 Retract。那篇有意把一个关键问题压成了黑盒:waiting queue 里可能同时有短提示、长提示、缓存命中请求和撤回后恢复的请求,Scheduler 到底依据什么决定“这一轮让谁做 prefill”?
答案不只是排序。SchedulePolicy 先决定候选请求的考察顺序,PrefillAdder 再逐条做接纳控制(admission control):计算未命中的输入量、未来输出的保守估计、页对齐开销、running batch 的后续增长,以及本轮允许投入的 prefill 计算量。长提示放不下时,它还要选择一个合法切点,把请求保留成 chunked_req,下轮从断点继续。
SGLang 最初由 LMSYS 团队在 2023 年 12 月公开,论文发表于 NeurIPS 2024。论文用 RadixAttention 说明了 KV 前缀复用为什么能提高吞吐;当前运行时在此基础上补出了更完整的在线调度账本。本文仍以本系列前三篇使用的仓库提交 d88d5c3 为源码坐标,聚焦普通自回归生成主线;扩散语言模型、Mamba 状态、分层缓存和 P/D 分离只在它们改变基础不变量时说明。
先固定几个术语:
- prefill 是把一段已有 token 写入 KV Cache,并用最后一个位置的 logits 产生首个输出 token;
- extend 是源码中的更一般说法,表示只计算“已有缓存前缀之后的新后缀”;
- admission 是承诺让请求进入本轮 forward,不等于 forward 已经执行;
- reserve 是为将来的 decode 增长预留容量,不等于此刻已经分配对应 KV 页;
- chunked prefill 是把一个长 extend 拆成多轮执行,中间 chunk 不采样、不输出。
这几个概念不能混用。请求命中 3000 个 token、还需计算 1000 个 token 时,本轮是一次 EXTEND forward,计算账单只有 1000 个 token,但其序列历史长度是 4000。若它还有最多 500 个输出 token,接纳算法不能只问“1000 个 token 能否塞进 GPU”,还要问运行请求继续增长时是否会很快把系统推到无法分配下一页的状态。
为什么 Prefill 不能按先来先服务直接塞满
最朴素的批处理器可以遍历队列,把请求不断加入 batch,直到输入 token 总数达到上限。它在离线推理中可能工作,在在线服务中却会同时破坏延迟、内存安全和缓存效率。
第一,prefill 与 decode 的单轮工作量不对称。设长提示需要处理 个 token,running batch 中有 条请求各推进一个 token。若把整个长提示一次性送入 GPU,本轮近似工作量由 主导;decode 请求必须等这次大 forward 完成,用户会看到 token 输出停顿。把长提示切成大小为 的块后,最坏阻塞粒度从 降为 ,代价是增加 次调度、Kernel launch 和批次整理。
第二,当前能放下不代表未来能继续。请求 的保守容量需求可写成:
是本轮需要计算的 extend token 数, 是预计仍会生成的 token 数, 是页对齐、请求状态或特殊缓存布局带来的额外开销。pageceil 表示向 KV 页大小的整数倍取整。若只核算 ,prefill 可以成功,首 token 之后的 decode 却可能立即发现没有新 KV 槽,只能 retract 刚接纳的请求,形成“接纳—撤回—重算”的抖动。
第三,队列顺序会改变缓存命中。两个等待请求共享很长前缀时,先执行其中一个,完成后产生的 KV 可能被另一个直接命中;若两者在同一个 batch 内同时作为冷请求执行,共享前缀会重复计算。相反,一味选择最长前缀命中也可能让冷请求长期饥饿。排序策略因此是在吞吐、TTFT 与公平性之间选取偏好,不是一个无关紧要的 sort()。
第四,计算预算与显存预算不是同一个单位。max_prefill_tokens 限制这一轮愿意计算多少输入 token;KV budget 限制现在和未来能占多少物理位置;chunked_prefill_size 又限制一次长提示最多推进多少。它们经常数值相近,却回答三个不同问题:GPU 这一轮做多少工作、内存能否履约、单请求可以连续占用多大的 prefill 时间片。
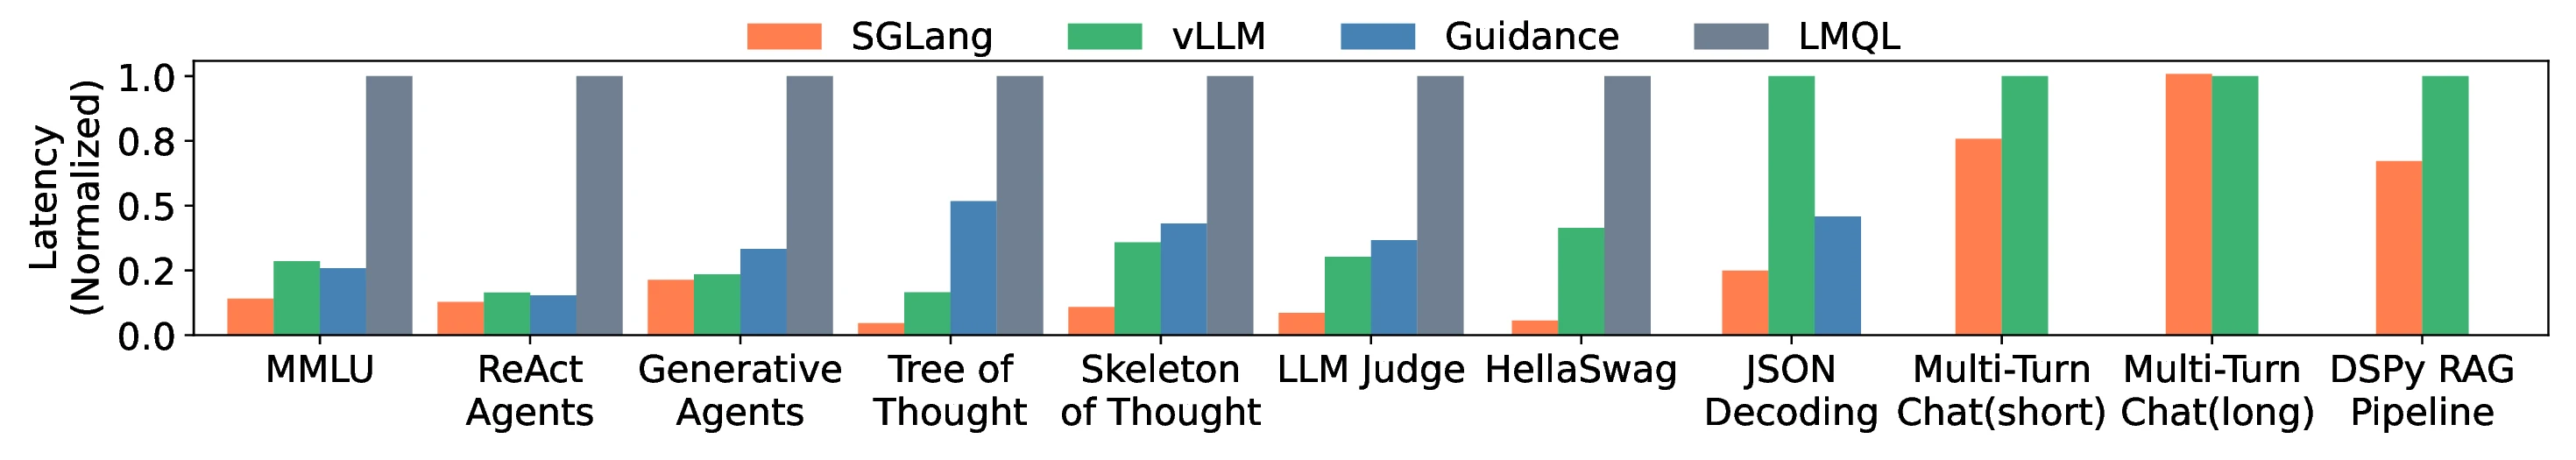
图源:SGLang 论文 Figure 6。图中的延迟收益是 RadixAttention、批处理、压缩 FSM 等机制共同作用的系统结果,不能直接归因于 PrefillAdder。它说明的调度背景是:端到端延迟既包含实际计算,也包含排队和跨请求干扰;只提高单个 prefill Kernel 的吞吐,并不能自动保护正在 decode 的请求。
调度入口:一次新 Prefill Batch 怎样被触发
关闭 overlap 后,可以把 Scheduler 的关键循环压缩成:
while True: ingest_requests() plan = get_next_batch_to_run(running_batch, last_batch) if plan.batch_to_run is not None: result = run_batch(plan.batch_to_run) process_batch_result(plan.batch_to_run, result)get_next_batch_to_run() 先把上一轮已经完成的状态收敛,再尝试 get_new_batch_prefill(running_batch)。后者并不保证返回新 batch。至少有四类门会让它返回空:
- waiting queue 为空,而且没有未完成的
chunked_req; - running batch 已被标记为
batch_is_full; - request pool 没有可分配行; 4.延迟器判断现在应先推进 decode,而不是插入新的 prefill。
这里有一个重要例外:若 self.chunked_req 非空,调度器会尽量让它继续推进。中途 chunk 已经进入一个跨轮协议,若把它永久挡在 request-slot 检查之外,可能留下锁、在途计数或不可完成的半段请求。因此源码对 chunk continuation 跳过部分普通新请求的门,并在进入 waiting queue 遍历前先调用:
chunked_req.init_next_round_input()chunked_req = adder.add_chunked_req(chunked_req)随后才遍历 waiting_queue,对每条候选执行 req.init_next_round_input(tree_cache) 与 adder.add_one_req(...)。若返回 CONTINUE,继续看下一条;若返回 NO_TOKEN,说明内存容量是硬门,通常设置 batch_is_full;若返回 OTHER,则是本轮输入预算、chunk 预算、batch 形态或延迟策略等非内存原因,停止继续装批。
最终 adder.can_run_list 被移出 waiting queue,构造 ScheduleBatch,调用 prepare_for_extend() 分配 request row 和 KV 位置。注意时间顺序:PrefillAdder 只做选择和预算承诺,真正把本轮输入编译为张量、写入 request-to-token 映射,发生在 ScheduleBatch 准备阶段。把这两步分开,候选请求被拒绝时就不需要回滚已经发布的物理映射。
SchedulePolicy:先改变顺序,再谈能否接纳
SchedulePolicy.calc_priority() 不直接决定 batch,它只重排 waiting queue,并在需要时计算缓存前缀匹配。固定提交中的策略分成缓存无关与缓存感知两组:
| 策略 | 排序依据 | 主要目标 | 主要风险 |
|---|---|---|---|
fcfs | 到达顺序,可叠加显式优先级 | 简单、公平、易解释 | 长提示造成队头阻塞 |
lof | 预计输出长者优先 | 改变完成顺序或吞吐形态 | 短请求 TTFT 可能变差 |
random | 随机 | 测试或打散相关性 | 不提供稳定 SLO |
lpm | 已命中前缀最长者优先 | 少算冷前缀,提高 KV 复用 | 冷请求可能等待更久 |
dfs-weight | Radix tree 的 DFS 权重 | 聚拢共享树分支 | 策略依赖缓存形态 |
hrrn | 响应比,使用 token 进度老化 | 兼顾短作业和饥饿控制 | 需要可靠工作量估计 |
shortest-prefill-first | 未缓存 prefill 工作量最短者优先 | 降低短提示 TTFT | 长提示需要额外防饥饿机制 |
最长前缀匹配(LPM)按 num_matched_prefix_tokens 降序排列。若请求 A 命中 7000/8000 个 token,请求 B 命中 0/1000 个 token,两者真实 prefill 工作量同为 1000;仅看命中长度会优先 A,因为它更有可能沿现有热分支继续复用。shortest-prefill-first 则更直接地估算:
是原始输入长度, 是 retract 后可能已提交的输出长度, 是各层缓存已匹配长度。 近似本轮需要恢复或计算的 token 数。相同工作量再按入队时间打破平局。
缓存感知排序还有一段容易忽略的“同批前缀缓存”模拟。若多个冷请求在 waiting queue 中共享长前缀,策略用一个只保存 token 键的临时 Radix tree 模拟入队顺序:第一条请求保留较高优先级,后续重复前缀暂时降级。这样第一条先计算并把结果写入真实缓存,后续请求下一轮再匹配,避免同批重复计算相同冷前缀。
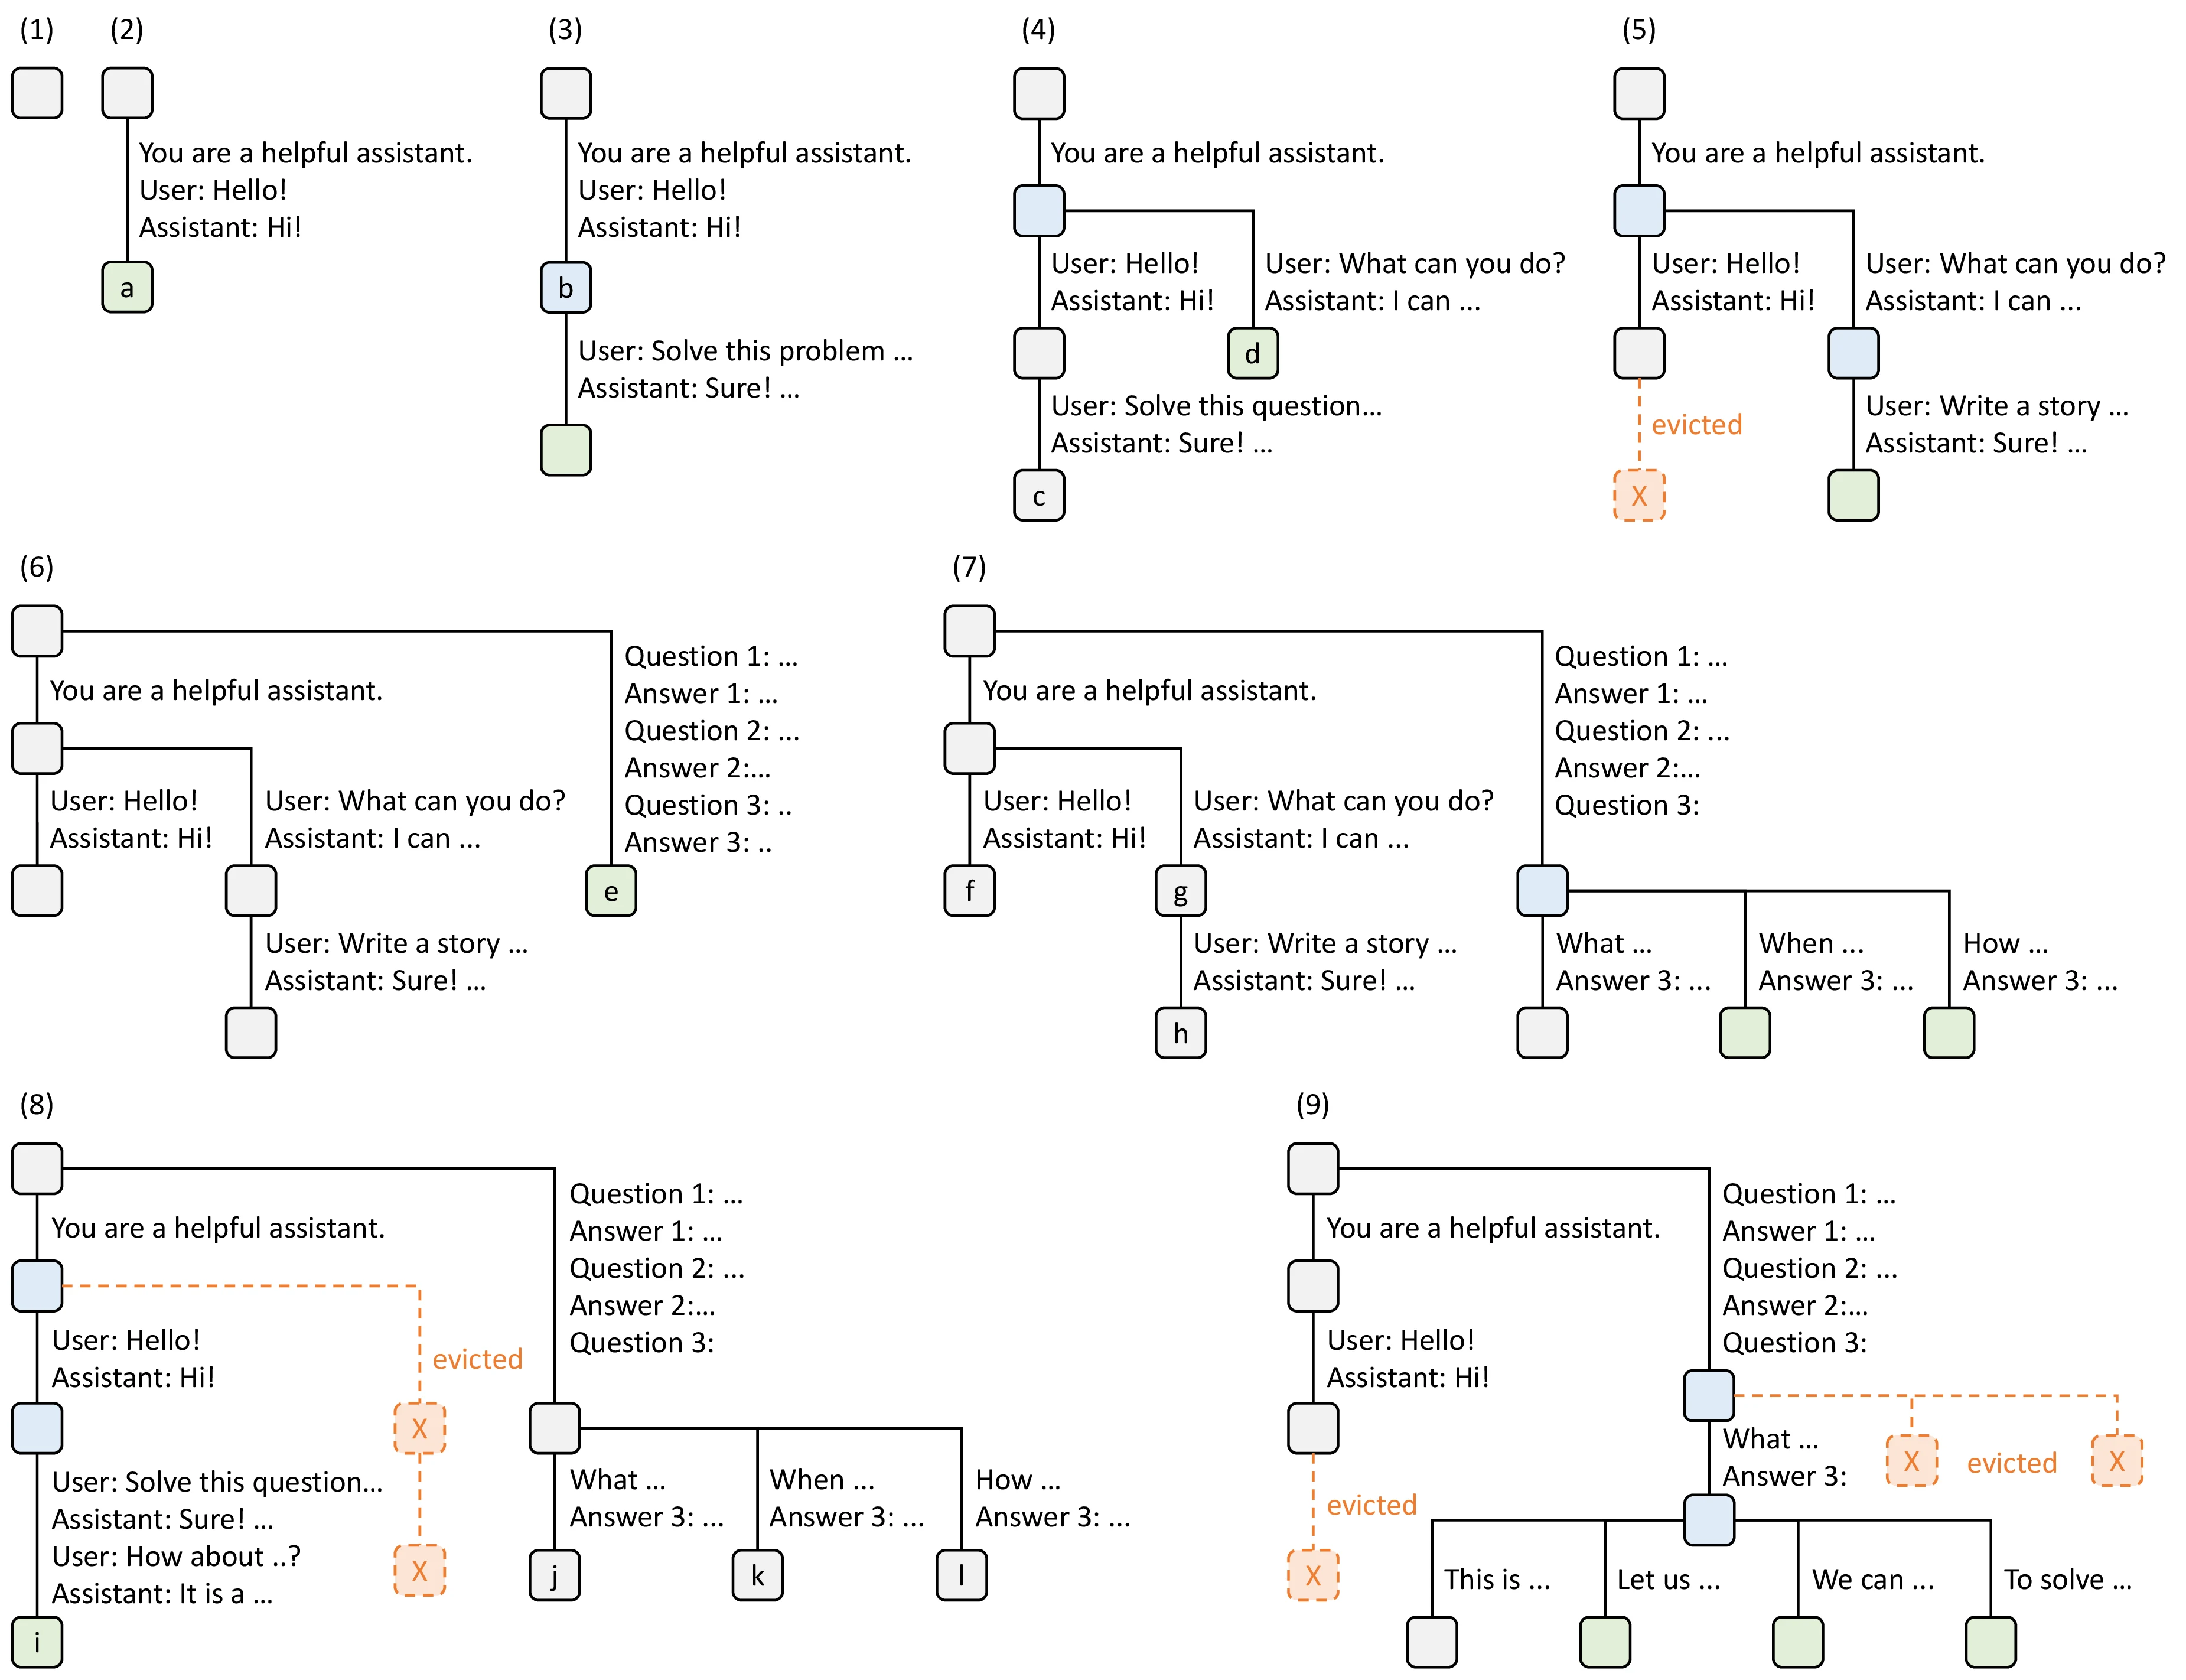
图源:SGLang 论文 Figure 3。图中树节点保存 token 片段与对应 KV 索引,引用计数保护正在使用的路径,LRU 驱逐回收未锁定叶子。SchedulePolicy 读取这棵树来排序,PrefillAdder 在接纳候选时临时锁住命中节点;两者都不复制 K/V tensor。
PrefillAdder 的三本账
PrefillAdder 是一次装批过程中的临时对象。每次 get_new_batch_prefill() 都重新创建它,所以它保存的是“本轮还剩多少预算”,不是服务全局累计值。构造参数中最容易混淆的是 rem_input_tokens、rem_chunk_tokens 与内部 memory_budget。
计算账:rem_input_tokens
rem_input_tokens 初始来自 max_prefill_tokens,限制本轮所有 extend 输入的总计算量。启用 mixed chunk 时,running batch 中每条 decode 请求也会在同一次 extend forward 中占一个输入位置,因此构造器先扣除 num_mixed_decode_tokens:
接纳请求后,源码按页向上取整扣账。设 KV 页大小为 ,请求实际 extend 长度为 ,基础路径的计算扣款是:
于是 。之所以保守取整,是分配器与部分 Kernel 元数据按页组织;某些硬件上的 exact-chunk-fill 特化会改为按真实 forward token 收费,但不能把这个平台分支误当成基础语义。
当 chunking 关闭时,源码允许空 batch 的第一条请求超过 rem_input_tokens。这是为了避免一条长提示永远无法被调度:若限制是 4096,而最短候选也有 6000 token,又不允许拆块,严格执行上限会形成活锁。第二条及以后仍受预算约束。这里的含义是“上限在无法切分时可被第一条突破”,不是内存检查也可以突破。
时间片账:rem_chunk_tokens
rem_chunk_tokens 初始来自 chunked_prefill_size。它限定本轮用于 chunked prefill 的推进量,也会扣掉 mixed decode 占据的位置。每接纳一段 chunk 就递减;归零时 budget_state() 返回 OTHER,表示本轮计算时间片用完,但未必缺 KV。
为什么已经有 rem_input_tokens 还要再放一本账?两者可以服务不同目标:前者是整个 prefill batch 的计算上限,后者是长提示可连续占用的切分粒度。在常见配置中它们可能相等,所以表面行为相似;一旦 mixed chunk、动态 chunk size 或平台对齐策略介入,它们的扣款和停止条件就可能不同。
容量账:memory_budget
memory_budget 来自 KV allocator 的 create_prefill_budget()。它至少暴露两种视角:
remaining_current:此刻可直接分配的 KV 位置,不把“将来可以驱逐”的缓存全部当现金;remaining_total:当前可用加可驱逐容量,再减去已经为 running batch 与本轮候选承诺的未来增长。
构造 PrefillAdder 时,Scheduler 对每条 running 请求估算剩余输出,并加入 total_offset。普通请求的估计为:
是动态 new_token_ratio,表示输出通常不会全部跑到 max_new_tokens 的经验折扣;若 ignore_eos=true,请求更可能生成到硬上限,源码使用 。4096 是接纳估计的裁剪上限,只防止一个极大的 max_new_tokens 让调度器过度保守,并不会修改真正的停止条件。请求仍然可以生成超过 4096 个 token,届时容量压力由后续 decode 检查、驱逐或 retract 处理。
因此 remaining_total 不是简单的“free pages”:
这个公式是理解 PrefillAdder 的核心。缓存页虽然占着显存,但若没有活动引用,它可以在需要时驱逐;running 请求尚未写入的未来 token 虽然不占显存,却已经构成服务承诺。两者都必须出现在接纳账本里。
三本账的停止语义可以整理为:
| 检查失败 | 返回值 | 含义 | Scheduler 的典型动作 |
|---|---|---|---|
| KV 总量或当前量不足 | NO_TOKEN | 再接纳会破坏内存承诺 | 停止装批并标记 batch full |
| input 预算耗尽 | OTHER | 本轮计算额度已用完 | 用已接纳请求发起 forward |
| chunk 预算耗尽 | OTHER | 本轮时间片结束 | 保存 chunked_req,下轮续算 |
| batch 形态不兼容 | OTHER 或跳过 | 不能放进同一 forward | 留在 waiting queue |
| 仍有全部预算 | CONTINUE | 可以继续考察下一候选 | 继续遍历 |
NO_TOKEN 与 OTHER 的区别很实际:前者说明继续遍历通常没有意义,因为后面的请求同样面对容量硬门;后者未必是 OOM,只是当前 batch 应该封口。
add_one_req:一条请求的接纳决策
add_one_req() 可以分成“计算候选形状”和“提交承诺”两阶段。固定提交已经把这两步明确拆成 _select_prefill_admission() 与 _commit_prefill_admission(),这比把字段边算边改更容易保证失败无副作用。
先看精简后的伪代码:
def add_one_req(req, has_chunked_req, align): max_new = min( max(req.max_new_tokens - len(req.output_ids), 0), 4096, ) candidate_extend = len(req.full_untruncated_fill_ids) - req.prefix_len total = candidate_extend + max_new + per_request_overhead
with temporarily_pin(req.last_node): admission = select_shape( req, total_tokens=total, alignment=align, has_chunked_req=has_chunked_req, ) if admission is rejection: return admission
reserve_scratch(admission) commit(req, admission)
return budget_state()第一步计算剩余输出,而不是再次使用完整 max_new_tokens。retract 后恢复的请求已经生成了一部分 token,只需要为剩余部分预留。接着把未命中后缀、未来输出和每请求页开销组成 total_tokens,交给 allocator 特定的预算对象检查。页式 KV、滑窗注意力、混合状态空间模型可能有不同的实际容量函数,所以高层不应假设所有模型都是“一 token 对应一等份 KV”。
第二步临时 pin 住 req.last_node。预算把可驱逐缓存算进总容量;如果候选正在检查时,命中的前缀又被其他回收路径驱逐,刚算出的 prefix_len 与可用容量都会失效。临时锁让“基于这个命中结果做选择”成为一个一致快照。接纳成功后,提交阶段再把正式锁交给请求生命周期持有。
第三步 _select_prefill_admission() 计算四元组:
(prefix_len, extend_len, max_new_tokens_reserved, is_chunked)其中 prefix_len 可能包含已经在设备上的命中,也可能包含分层缓存从 host 加载回来的 KV;extend_len 是本轮实际 forward 的新 token 数;只有最后一个 chunk 才为输出增长预留 max_new_tokens;is_chunked 表示这轮之后输入仍未处理完。
若完整后缀能同时通过计算与容量检查,extend_len 取全部剩余长度。若只能拆块,则按 chunk_tokens_limit 截断,并向页边界或额外的 truncation_align_size 对齐。对齐不是为了数学正确性,而是为了让下一轮的绝对序列边界、物理页和某些分片 scratch 区兼容。对齐后长度若变成 0,本轮必须返回 OTHER,否则会生成一个不前进的空 chunk。
最后 _commit_prefill_admission() 才修改持久状态:
req.extend_end = prefix_len + extend_lenreq.lock = tree_cache.lock(req.last_node)can_run_list.append(req)if is_chunked: new_chunked_req = requpdate_all_budgets(...)这个顺序建立了一条很有用的不变量:出现在 can_run_list 中的请求已经有确定的 extend_end、缓存锁和预算扣款;被拒绝的请求不应留下半扣的预算、已发布的 KV 映射或孤立锁。调试“可用 KV 越来越少但没有请求运行”时,应优先检查是否有分支在 commit 前分配、失败后却没有回滚。
Chunked Prefill:长提示怎样跨轮推进
假设一条请求的 prompt 长 10000 token,没有缓存命中,chunked_prefill_size=4096。忽略页对齐时,它会经历 4096、4096、1808 三段 extend。前两段是 middle chunk,最后一段才是 final chunk。
轮次 1: [0, 4096) 写 KV,不采样,不输出轮次 2: [4096, 8192) 写 KV,不采样,不输出轮次 3: [8192, 10000) 写 KV,采样首 token,进入 decode第一次切分发生在 add_one_req():它把 req.extend_end 设到本轮边界,把请求加入 can_run_list,同时记录为 adder.new_chunked_req。Scheduler 接管后写入 self.chunked_req,并增加 inflight_middle_chunks。下一轮进入 get_new_batch_prefill() 时,这条请求在遍历普通 waiting queue 之前执行 init_next_round_input(),再由 add_chunked_req() 从当前 prefix_len 继续。
中间 chunk 的结果不能被当作首 token。Transformer 对 chunk 最后一个位置同样会产生 logits,ModelRunner 也可能返回占位或可计算的 token;但此时 prompt 还没有完整输入,采样得到的只是“只看见半段提示时的答案”,语义无效。结果处理器用 inflight_middle_chunks 阻止提交:
should_commit_output = ( not req.finished() and not req.is_retracted and req.inflight_middle_chunks <= 0)
if req.inflight_middle_chunks > 0: req.inflight_middle_chunks -= 1 skip_stream_req = req只有最后一个 prefill chunk 完成、计数归零后,采样 token 才追加到 output_ids,设置 prefill finished 时间,并允许流式输出。这个计数不是“还剩多少未计算 chunk”的静态估计,而是在 overlap 或流水并行下追踪已经发出但尚未完成提交的中间 chunk;因此 abort 也不能无条件把它立刻清零。
为什么系统只保留一个显式 chunked_req?它简化了跨轮所有权:只有一条请求可以处于“输入处理了一部分、持有 continuation 状态、下轮必须优先恢复”的位置。其他请求可以与它同批进入,但不能再产生第二个需要跨轮追踪的未完成长 chunk。代价是多个超长冷提示不能都以独立 continuation 并发推进;调度器用普通候选和短请求填充剩余预算,避免状态结构膨胀。
shortest-prefill-first 还会为更短的 waiting 请求预留部分 chunk 预算。它把短请求工作量按页收费,在至少给活跃 chunk 留一页的前提下,从本轮 budget 中扣出 reserved 部分,再限制 continuation 的最大推进量。这样长 chunk 不会每轮都吃满时间片,使后来到达的短提示有机会插入;页对齐又保证 continuation 边界能被 allocator 接受。
chunk size 的取舍可以写成:
第一式表示块越小,固定 launch、调度和元数据开销重复越多;第二式表示块越大,一次 prefill 对 decode 的最长阻塞越大。不存在对所有模型与 GPU 都最优的固定 :prompt 分布、attention backend、页大小、并发量和 TBT 目标都会改变平衡点。源码中的动态 chunk sizer 正是根据历史长度等信息覆盖静态值,但基础接纳协议不变。
Mixed Chunk:为什么 Extend 与 Decode 能进同一次 Forward
分块只缩短单次 prefill,并没有自动让 decode 获得 GPU 时间。如果调度循环连续选择 chunk,而 running batch 只能等待,TBT 仍会周期性抖动。SGLang 的 mixed chunk 路径进一步把本轮新 extend 与已有 decode 请求合到同一个 ScheduleBatch。
设新 prefill 部分有 个输入 token,running batch 有 条请求。混合后的扁平输入长度近似为 :prefill 请求贡献一段连续后缀,每条 decode 请求贡献一个新 token。它们共享一次模型层遍历,但 attention metadata 不同:
- extend 行的 query 对应多个新位置,每个位置可见缓存前缀与同一 chunk 中更早的 token;
- decode 行只有一个 query,需要读取该请求全部可见 KV;
- logits 与采样只在各请求有效的最后位置产生;middle chunk 的采样仍必须丢弃。
PrefillAdder 构造时已经先从 rem_input_tokens 和 rem_chunk_tokens 中扣掉 ,防止随后接纳的 prefill 把计算预算全部吃完。新 batch 完成 prepare_for_extend() 后,Scheduler 检查一组兼容条件,再调用 new_batch.mix_with_running(running_batch):
if ( is_mixed_chunk and not running_batch.is_empty() and not return_logprob and new_batch.input_embeds is None and no_beam_group): remove_finishing_inflight_reqs() if running_batch.check_decode_mem(): running_batch.prepare_for_decode() new_batch.mix_with_running(running_batch) new_batch.decoding_reqs = running_batch.reqs限制条件都对应真实的张量或提交问题。return_logprob 需要精确区分 prefill 与 decode 的 logits 区间;自定义 input_embeds 不能像 token IDs 那样直接拼接;beam group 有组级状态,不能把成员行当普通独立 decode;已经在途完成的请求必须先过滤,否则混合 batch 会为逻辑完成的行再分配一个位置。
内存不足时,mixed 路径不会为了本轮强行 retract running 请求。源码先用 check_decode_mem() 检查 decode 行能否安全加入;若不能,它们这一步暂时不混入,下一轮再以普通 decode 推进。原因是 prefill 已经完成接纳,临时混合是一项延迟优化,不应把一次“可选共车失败”升级成 running 请求的破坏性状态迁移。
从 Kernel 角度看,mixed batch 也不保证总是更快。prefill 更接近大矩阵乘,decode 更受内存带宽限制;混在一起会增加 metadata 和形状复杂度,却能减少两个阶段串行造成的等待。是否获益取决于 backend 能否高效处理不均匀 query length,以及 batch 中 与 的比例。调度器只保证语义与预算正确,最终吞吐仍要用具体硬件测量。
缓存命中、锁与内存压力怎样改变预算
一条请求的完整 token 序列记为 ,Radix Cache 匹配长度为 ,则基础 extend 工作量是:
命中会同时改变计算账与容量账。计算上,只需处理 ;容量上,命中的 KV 已经存在,不需要再次分配,但它在请求运行期间必须保持不可驱逐。于是接纳请求会把命中节点从“可驱逐缓存”转为“活动引用保护的缓存”。若预算先把它算作可驱逐容量,提交后却不扣除或锁定,就会出现同一页被两次承诺的超售。
这就是 with self._lock_node(req.last_node) 的作用。选择期间使用临时 pin,提交成功后 req.lock 延长保护期;请求完成、retract 或 abort 时再由统一资源路径释放。缓存树与 allocator 共享同一物理 KV pool,所谓“缓存容量”和“运行容量”只是不同所有权状态,不是两块静态分区。
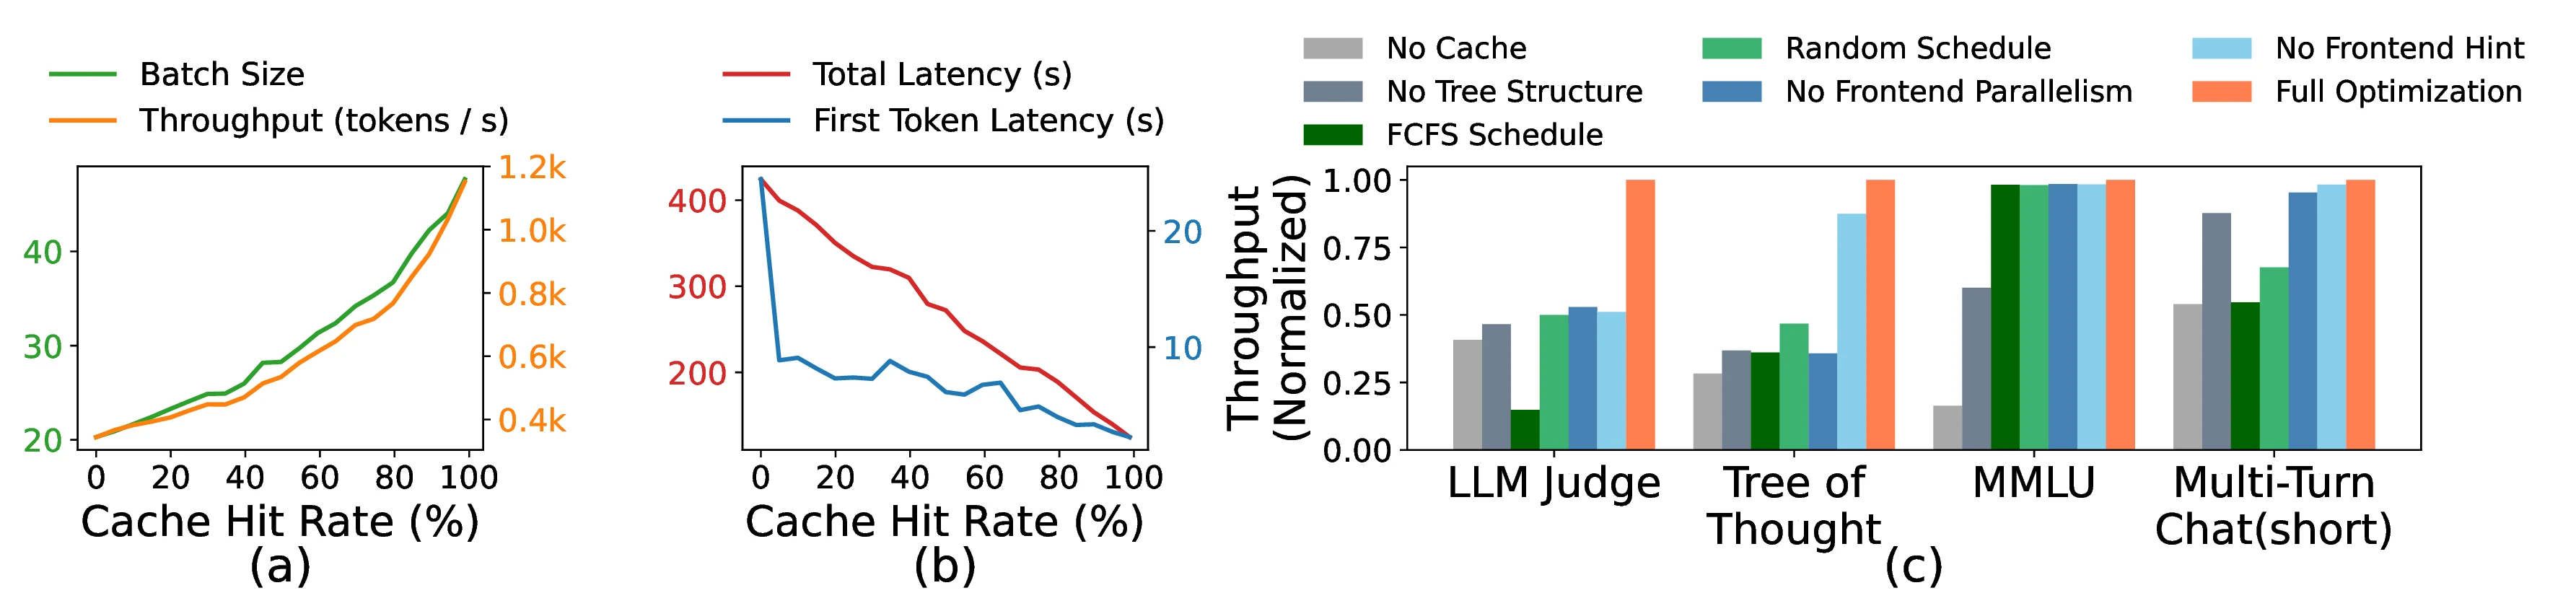
图源:SGLang 论文 Figure 8。左侧对比不同工作负载下缓存策略的命中率,右侧展示 RadixAttention 等组件对吞吐的贡献。图中数据来自论文版本,不能直接代表当前提交的生产性能;它仍清楚说明了为什么 waiting queue 排序与前缀所有权必须进入 Scheduler,而不是交给 attention Kernel 临时决定。
分层缓存又增加了“命中但不在 GPU”这一状态。若前缀只存在 host 或外部存储,req.host_hit_length 会减少理论重算量,却需要先完成 load-back。add_one_req() 在临时锁住 host 命中路径后检查搬回设备的容量,只有完整承诺成立才更新 prefix_len。搬回失败时可以退回重新计算的接纳形状,但不能把尚未到设备的 KV 当成已命中直接发起 forward。
缓存命中也不意味着一定优先。LPM 倾向于热分支,FCFS 不看缓存,HRRN 用等待时间修正工作量偏好。正确的策略取决于目标:吞吐优先的离线队列可以更激进地聚拢共享前缀;在线接口若有 TTFT SLO,则需要防止冷请求在持续热流量下饥饿。PrefillAdder 不决定这类价值判断,它只保证给定顺序下的每次接纳不越界。
用例推演:四条请求如何被装进两轮 Batch
用一个简化例子把排序、缓存、页对齐和分块放到同一张账上。假设:
- KV page size 为 16;
max_prefill_tokens=128;chunked_prefill_size=96;- running batch 有 8 条 decode 请求,mixed chunk 开启;
- 忽略未来输出预留与每请求额外一页,只演示计算预算;
- waiting queue 有 A、B、C、D 四条请求。
| 请求 | 完整输入长度 | 已缓存前缀 | 未缓存工作量 | 到达顺序 |
|---|---|---|---|---|
| A | 160 | 0 | 160 | 1 |
| B | 80 | 64 | 16 | 2 |
| C | 48 | 0 | 48 | 3 |
| D | 96 | 64 | 32 | 4 |
若采用 FCFS,A 先被考察。mixed decode 先扣 8 个位置,剩余 input budget 为 120,chunk budget 为 88。A 的 160 个 token 放不下,于是按页对齐取 80 个 token,形成 chunked_req=A。剩余 chunk budget 只有 8,小于一页,其他请求不能再接纳。第一轮做 A 的 80-token middle chunk,加 8 条 decode 行;A 不产出首 token。
第二轮 A 的 prefix_len 已推进到 80,仍剩 80。它作为 continuation 优先进入 adder,最多再取 80;这次是最后一个 chunk,所以 forward 结束后可以采样首 token 并进入 running。若没有剩余 budget,B、C、D 继续等待。FCFS 的结果容易解释,但 B 明明只需计算 16 个 token,也要在长请求之后等两轮。
若采用 shortest-prefill-first,初始顺序变成 B、D、C、A。扣除 mixed decode 后,本轮 chunk budget 为 88:
- B 收费 16,剩余 72;
- D 收费 32,剩余 40;
- C 需要 48,无法完整装入;如果切成 32-token middle chunk,会占用唯一
chunked_req; - A 留在队列。
第一轮因此可以让 B、D 获得首 token,同时推进 C 的一部分,还让 8 条 running 请求 decode 一步。代价是 A 更晚开始。若流量持续包含短提示,调度器必须依赖等待时间老化、优先级或专门的 chunk 预留规则,避免 A 永远被插队。
真实 PrefillAdder 比这个例子更保守:B 与 D 还要为未来输出和页开销预留容量,缓存命中节点会被锁住,可能存在 host load-back,LoRA 不兼容也会让某条候选暂时跳过。手算时应始终区分“计算收费”和“KV 容量承诺”,不要用一列 token 数替代全部状态。
源码阅读与调试路径
阅读这一模块时,建议继续使用前三篇的固定提交,不依赖会漂移的行号。第一遍关闭 overlap、P/D 分离、投机解码、分层缓存和 Mamba,只保留普通页式 KV;启用一个较小的 chunked_prefill_size,让一条长提示稳定跨两到三轮。
先沿控制流设置日志:
Scheduler._get_new_batch_prefill_raw -> SchedulePolicy.calc_priority -> Req.init_next_round_input -> PrefillAdder.add_one_req -> _select_prefill_admission -> _commit_prefill_admission -> _update_prefill_budget -> ScheduleBatch.init_new -> ScheduleBatch.prepare_for_extend -> SchedulerBatchResultProcessor.process_batch_result_prefill每次尝试接纳时记录一行结构化数据:
rid, prefix_len, candidate_extend, selected_extend,rem_input_before/after, rem_chunk_before/after,remaining_current, remaining_total,is_chunked, add_result应验证以下不变量:
selected_extend > 0,否则 continuation 会活锁;extend_end = prefix_len + selected_extend;- 中间 chunk 完成后
output_ids不增加,最后 chunk 才增加首 token; - 被拒绝请求不在
can_run_list,也不持有新锁或新 request row; can_run_list中所有请求的页化收费不超过计算预算,除非命中“无 chunk 时首请求可突破”的明确例外;remaining_total已扣除 running 请求的未来增长估计;- mixed batch 中 decode 行数已经从 prefill 与 chunk 预算各扣一次,且只扣一次。
可以用符号搜索快速建立导航:
rg -n "class (SchedulePolicy|PrefillAdder)|def (calc_priority|add_one_req|add_chunked_req)" \ python/sglang/srt/managers/schedule_policy.py
rg -n "def (_get_new_batch_prefill_raw|get_next_batch_to_run)" \ python/sglang/srt/managers/scheduler.py
rg -n "def process_batch_result_prefill|inflight_middle_chunks" \ python/sglang/srt/managers/scheduler_components/batch_result_processor.py测试至少覆盖四组输入:单个短 prompt、单个跨三块长 prompt、共享长前缀的两个请求、已有 running decode 时到达的长 prompt。再分别切换 FCFS 与缓存感知策略,比较队列顺序与实际 prefill 工作量。只看最终文本正确,无法发现重复计算、错误预留或 TBT 抖动。
若要定位延迟,应分别记录排队时间、每个 chunk 的 forward 时间、两次 chunk 之间的 decode 数量、首 token 提交时间。TTFT 增加可能是请求排序靠后,也可能是 chunk 过小导致多轮固定开销;TBT 增加可能是 chunk 过大,也可能是 backend 对 mixed shape 效率差。四类原因不能从一个端到端平均值反推。
边界条件与常见误读
误读一:max_prefill_tokens 就是显存上限
它是本轮输入计算预算。显存安全由 allocator 提供的 prefill memory budget、未来输出预留、页开销和活动缓存锁共同决定。把数值调小可以缩短单轮工作,却不等价于为 KV 留出固定字节数。
误读二:缓存命中 token 不占任何资源
命中 token 不需要重新计算,也不需要新分配一份 KV,但其物理页必须在请求使用期间保持存在。它从可驱逐缓存变成活动依赖,因而会减少可供其他请求回收的容量。
误读三:middle chunk 的最后一个 logits 可以当首 token
它只看到了不完整提示。结果处理器必须丢弃该采样结果,并阻止流式输出。只有 final chunk 后的 logits 才对应完整 prompt。
误读四:chunk 越小越能降低延迟
它降低单次阻塞,却增加 forward 次数、CPU 调度、Kernel launch、元数据构造和可能的对齐浪费。过小 chunk 还可能让 GEMM 形状低效。应同时观察 TTFT、TBT、吞吐和 GPU 利用率。
误读五:Mixed chunk 等于把两种 attention 算法强行做成一个矩阵
框架混合的是同一次模型 forward 的请求行;attention backend 仍根据每行的 query length、sequence length 与 KV metadata 执行正确路径。它可以使用统一变长 Kernel,也可以内部区分 extend 与 decode,不要求数学上把所有请求补齐成同一稠密矩阵。
误读六:add_one_req 返回 OTHER 表示请求非法
OTHER 多数表示本轮预算或 batch 形态不允许继续装载,请求仍留在 waiting queue,下一轮可以重试。输入非法通常在更早的验证阶段结束并产生明确 finish reason。
误读七:max_new_tokens 裁剪到 4096 会截断输出
裁剪只用于 admission 的未来容量估计,停止条件仍保留原值。它减少过度保守,却把超长生成后期的压力交给运行期容量检查;极端情况下仍可能触发 retract。
误读八:只要 total budget 为正,就能立刻分配
remaining_total 可以包含可驱逐缓存,remaining_current 表示当前直接可用量。驱逐、host load-back、不同 KV 类型和页对齐都可能让“总量够”与“当前形状可分配”不同。预算对象必须与实际 allocator 使用同一口径。
需要额外审查的边界
- 页大小大于 1 时,chunk 终点与
prefix_len的绝对页边界要一致; - retract 恢复请求的
output_ids已进入完整上下文,不能只按原 prompt 算工作量; ignore_eos请求应按硬上限保守预留,不能使用普通早停比例;- logprob、input embeddings、beam group 可能禁用 mixed batch;
- LoRA batch 受已加载适配器集合与容量约束,队列中的某条请求可能被跳过而不是终止遍历;
- host 或外部存储命中必须在 load-back 真正建立设备所有权后才能增加
prefix_len; - overlap 下 middle chunk 计数描述在途提交,不能只根据剩余输入长度推断;
- 单请求完整上下文本身超过物理容量时,chunking 只能降低单轮计算,不能突破最终 KV 容量。
小结与后续路线
SGLang 的 prefill 调度是“两层选择、三本账、一个跨轮 continuation”。SchedulePolicy 决定考察顺序,把 FCFS、公平性与缓存复用偏好显式化;PrefillAdder 再用计算预算、chunk 时间片和 KV 容量承诺逐条接纳。add_one_req() 先在临时缓存锁下选择 (prefix, extend, reserve, chunked) 形状,全部检查通过后才提交锁、列表与预算,避免失败留下半成品状态。
Chunked prefill 把长提示的阻塞粒度从完整长度降到 chunk size,中间 chunk 只写 KV,不得提交 token;最后一个 chunk 才产生首 token并进入 running。Mixed chunk 又把已有 decode 行并入 extend forward,在预算中提前为它们扣位,以更细的粒度平衡 TTFT、TBT 与吞吐。缓存命中则同时减少计算、改变可驱逐容量与调度顺序,所以前缀树、allocator 和 batch builder 必须在同一个控制面协调。
SGLang 源码系列当前进度如下:
| 序号 | 主题 | 状态 |
|---|---|---|
| 一 | 整体架构、进程拓扑与请求数据流 | 已完成 |
| 二 | Entrypoints、TokenizerManager 与 DetokenizerManager | 已完成 |
| 三 | Scheduler 请求状态机 | 已完成 |
| 四 | PrefillAdder、调度策略与 chunked prefill | 本篇 |
| 五 | KV 内存池与当前 Radix Cache 源码 | 下一篇 |
| 六 | Overlap Scheduler | 待写 |
| 七 | ForwardBatch、TpModelWorker 与 ModelRunner | 待写 |
| 八 | Attention Backend | 待写 |
| 九 | CUDA Graph 与编译路径 | 待写 |
| 十 | Sampling、Grammar 与结构化输出 | 待写 |
| 十一 | 投机解码 | 待写 |
| 十二 | TP 与 PP | 待写 |
| 十三 | DP Attention、EP 与 MoE | 待写 |
| 十四 | Prefill/Decode 分离与分布式 KV | 待写 |
下一篇将沿本篇反复出现但尚未展开的物理账本继续向下:request-to-token pool 如何把逻辑序列位置映射到 KV 槽,token allocator 如何分配与回收页,Radix Cache 的 match、lock、checkpoint 和 eviction 又怎样在同一批物理页上维护所有权。
参考资料
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv)
- SGLang 论文(NeurIPS 2024)
- SGLang 官方 GitHub 仓库
- SchedulePolicy 与 PrefillAdder 源码(固定提交)
- Scheduler 的 Prefill Batch 构造源码(固定提交)
- Prefill 结果提交源码(固定提交)
- Req 与 ScheduleBatch 源码(固定提交)
- SGLang Server Arguments 官方文档
- Sarathi-Serve: Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
- RadixAttention 完全拆解:用前缀树自动复用 KV Cache
- 连续批处理完全拆解:Orca 的迭代级调度与选择性批处理
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


