


GGUF 完全拆解:一个文件里的张量布局、k-quants 块量化与元数据字典
背景:为什么需要一个新的模型文件格式
在 HF Transformers 的生态里,一个模型通常以“safetensors + config.json + tokenizer 文件”的目录形式存在:权重本体是 fp16 或 bf16 的 safetensors 文件,结构信息分散在若干 JSON 里,加载端先读 config、再读 tokenizer、再把权重依序 mmap 进显存。这套体系对云端 GPU 推理足够好,但有一个端侧部署绕不开的短板:权重精度固定为 16 位浮点,量化后模型想要单文件分发,就得自己在格式层引入第二个文件格式、自己定义量化类型,加载端再各自实现一套解析器——每个量化工具都自带一种私有格式,正是 2023 年 ggml 社区分裂出 GGML/GGMF/GGJT 一连串前代格式的原因。GGUF 于 2023 年 8 月随 llama.cpp 合入,全称 GPT-Generated Unified Format,统合了这条演化线:它是一个自描述的单文件容器,把元数据、tokenizer、张量清单和量化后的权重全部装进一个文件,读文件的人不需要任何外部 config 就能完整还原模型。
格式本身解决“怎么打包”;真正决定模型文件长什么样、跑起来多快的是其中的块量化方案 k-quants。本站此前拆解过的 AWQ、GPTQ、SmoothQuant、QuaRot 都在算法层面回答“如何用 4 bit 存 16 bit 才不掉点”,它们输出的量化矩阵最终也要落盘成某种存储格式——在 llama.cpp 生态里,这个落盘格式就是 k-quants 定义的低比特块编码。两者是正交的两层:算法决定“哪些权重、用什么粒度、怎么训练式调整”,格式决定“比特按什么顺序排、解压 kernel 怎么读”。GGUF 的价值还在于把这份位布局写成了跨语言契约:ggml C++ 内核、Python 的 gguf-py、各语言社区移植端都按同一份块结构读写,端口实现能不能 bit-exact 复现参考实现就是这个契约是否被遵守的检验标准。
这篇文章按“文件容器格式 → 块量化位布局 → 两者合起来的工程含义”三层展开。所有结构细节均以 llama.cpp 仓库 gguf-py/gguf/ 目录下当前源码(gguf_reader.py、constants.py、quants.py)与 GGUF 版本历史为准,文末给出对应链接。
容器层:头部、元数据字典、张量清单与数据区
头部:四字魔数加三个计数
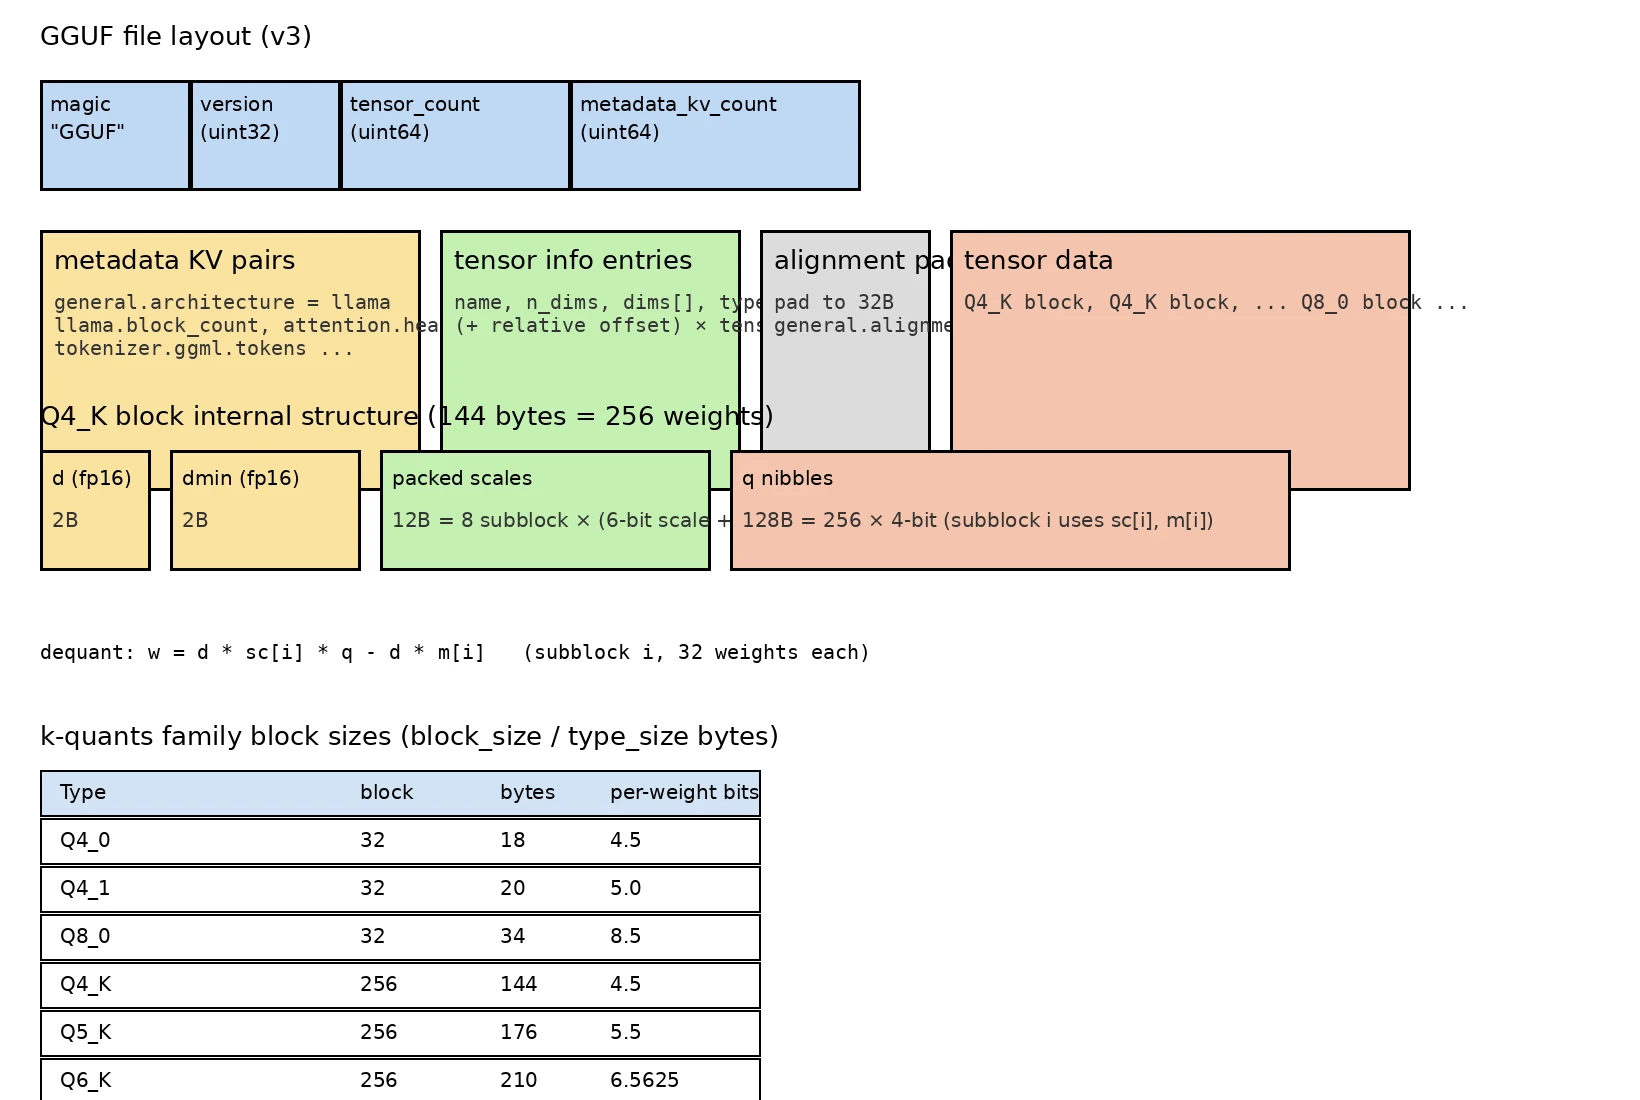
GGUF v3 的文件头只有四个字段,按序排列:
| 字段 | 类型 | 含义 |
|---|---|---|
| magic | uint32 | 魔数 0x46554747,即小端写入的 ASCII “GGUF” |
| version | uint32 | 格式版本号,当前规范为 3 |
| tensor_count | uint64 | 张量总数 |
| metadata_kv_count | uint64 | 元数据键值对总数 |
gguf_reader.py 的解析顺序与这张表完全一致:先读魔数、不匹配即抛 GGUF magic invalid;再读版本,并顺手处理一个容易被忽略的细节——字节序探测。如果读出的 version 低 16 位为 0,解析器翻转字节序重新解释整个文件,这意味着 GGUF 在格式层就定义了大端宿主机上的可用性,移植到 PowerPC 这类环境的读者不必自己做转换。
元数据字典:自描述性的来源
头部之后是 metadata_kv_count 个键值对,全部由三部分组成——(key, value_type, value)。key 是一个 GGUF 字符串(uint64 长度 + UTF-8 内容),value_type 是一个 uint32 枚举,覆盖从 uint8 到 float64 的全部标量类型、字符串、数组,以及一个特殊的 ARRAY 类型用于嵌套列表。这套设计意味着 GGUF 的元数据是一张类型化字典而不是固定布局:加载端逐字段读、识别类型、组装,任何不认识的键照样向后兼容。
键名采用点分层次命名,规范中最重要的几个命名空间:
| 键空间 | 例子 | 作用 |
|---|---|---|
general.* | general.architecture、general.file_type、general.size_label | 谁造的、什么架构、多大、什么量化 |
{arch}.* | llama.block_count、llama.embedding_length、llama.attention.head_count_kv | 该架构的结构参数,加载端据此重建计算图 |
tokenizer.* | tokenizer.ggml.tokens、tokenizer.ggml.scores、tokenizer.ggml.token_type | 词表本体、分数、类型,直接从权重文件加载分词 |
split.* | split.count、split.no | 分片模型中本片序号与总分片数 |
这张字典设计有一个非常工程化的后果:模型卡面上常见的配置信息完全被收编进权重文件。PyTorch 生态里“改 config 需要 config.json,GPTQ 量化需要 quantize_config.json”的分散式配置,在 GGUF 里合并为一个文件的键空间。社区版 llama.cpp 沿用 llama. 前缀架构键,新架构按自己的前缀扩展键空间——比如 MoE 模型用 {arch}.expert_feed_forward_length、{arch}.expert_count 扩展,gguf-py 的 constants.py 直接把这些键名写成常量,构成转换器与加载端共享的 API 表面。
注意,{arch} 前缀的键在 llama.cpp 里有两个互为补充的名字:.block_count(块数)、.embedding_length(隐藏维)、.attention.head_count(头数)、.attention.key_length 等。加载端用这些数字重建张量形状和注意力逻辑,因此这组键的键名拼写错误将直接导致权重加载失败,是转换器最容易踩坑的地方。
张量清单:每张权重的“目录条目”
元数据之后是 tensor_count 个张量条目,每个条目四段结构:名称字符串、维数 uint32、逐维尺寸的 uint64 数组、量化类型 uint32。与每个张量实际存储相关的是相对偏移——清单尾部的 offset_tensor 字段记录“这张张量在数据区的相对起点”,加载端把它加上统一的数据区基址就能直接寻址。
这个清单的关键作用是允许加载端随机访问任意权重而不必顺序解析。safetensors 用 JSON 头实现同样的功能,GGUF 把它编码进二进制段;配合 mmap,一张 7B 模型的 Q4_K 权重文件可以做到“打开即用、按需解压”:llama.cpp 启动时把整个文件 memmap 进地址空间,推理 kernel 用到哪张张量就解压哪一块,这就是端侧模型启动无需全量读盘的机制。
清单之后有一个对齐台阶:从清单结束位置到数据区起点之间必须补零,使数据区基址按对齐值取整,对齐值由元数据键 general.alignment 给出,默认 32 字节,且必须是非零二次幂。这个设计让每张权重在数据区都落在自己的对齐边界上,内存映射后的 SIMD 访存不需要再处理不对齐尾块——它是 k-quants 全部量化 kernel 成立的物理前提。
数据区:按对齐排布、按 offset 定位
数据区就是所有张量数据的物理堆放。加载端只做一件事:对每张张量计算 n_bytes = n_elems × type_size ÷ block_size,把 data_offset + offset_tensor 到 +n_bytes 的字节段交给该张量量化类型的解码器。同一张文件里不同张量可以有不同的量化类型——比如 tok_embeddings.weight 用 F16 而 attention 用 Q4_K——这是 GGUF 逐张量 type 字段换来的设计自由度,也是 llama.cpp 默认转换策略存在“敏感层保留高精度”的格式基础。
块量化层:k-quants 的物理位布局
块、缩放因子与分组维度
GGML 一族量化把权重沿内存连续维度切分成固定大小的块,每块配备自己的压缩元数据:一个标量缩放因子(以及 Q4_0 之后的多数类型再加一个零点偏移),加上该块所有权重的低比特定量值。解码一个权重只需要 scale × q + offset 这种整数乘加;每个块的 scale 本身是 fp16,占据块头部。
constants.py 给出整套类型的 (block_size, type_size) 表,摘录推理中常见条目:
| 类型 | block_size | type_size | 有效位数 | 备注 |
|---|---|---|---|---|
| F32 | 1 | 4 | 32 | 基准 |
| F16 | 1 | 2 | 16 | 半精度基准 |
| Q8_0 | 32 | 34 | 8.5 | 32 个 int8 + fp16 scale |
| Q4_0 | 32 | 18 | 4.5 | 16 字节装 32 个 nibble + fp16 scale |
| Q5_K | 256 | 176 | 5.5 | k-quants 系,5 bit |
| Q4_K | 256 | 144 | 4.5 | 主力中档精度 |
| Q6_K | 256 | 210 | 6.5625 | 大权重层常用上限 |
| IQ4_XS | 256 | 136 | 4.25 | i-quants 簇,码本查找 |
| MXFP4 | 32 | 17 | 4.25 | 2025 新增,开源 MXFP4 标准 |
这个表是 GGUF 端到端推理的“位宽地形图”,决定一张 7B 模型在不同量化下分别占多大磁盘、多大显存。所有 k-quants(带 K 后缀)的 block_size 统一为 256(常量 QK_K),所有旧类型(Q4_0 至 Q8_1)block_size 为 32;这是两代方案的第一个分水岭。
k-quants 原始 PR 给出的核心论据是一张困惑度—体积曲线:wikitext 困惑度对模型体积作图,x 轴取对数。曲线上每个圆点都是一种 k-quants 混合方案,同体积下点的位置越低,说明这套块布局把每一个字节用得越划算:
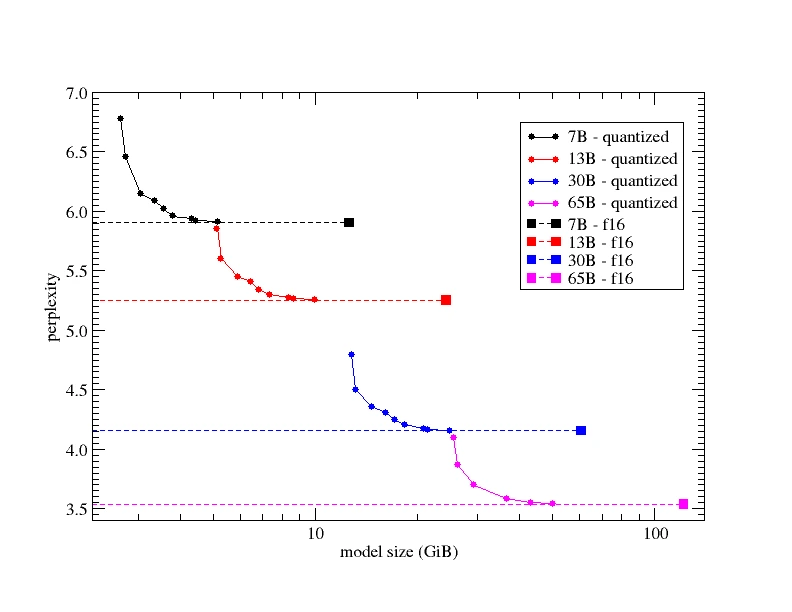
PR 正文记录的实测数字同样直观:7B 模型 fp16 为 13.0 GB、困惑度 5.9066;Q4_K_M 压到 3.80 GB,困惑度 5.9601,只上升 0.9%;13B 模型 Q6_K 为 9.95 GB,困惑度 5.2568,与 fp16 的 5.2543 几乎持平。体积接近十分之一,困惑度偏差不到百分之一,这是块布局交出的第一份成绩单。
Q4_0:最朴素的单尺度 nibble 块
(block_size=32、type_size=18)的 Q4_0 块布局是理解全部位布局的起点:
Q4_0 块(18 字节, 对应 32 个权重):+--------------+--------------------------------+| fp16 scale | 32 个 4-bit 权重(紧凑 nibble) || 2 字节 | 16 字节 |+--------------+--------------------------------+量化时取块内绝对值最大权重除以 -8 得到 scale(注意负号:nibble 存的是有符号补码值的低 4 位,以 +8 为零点),权重乘 1/scale 加 8.5 后截断到 [0, 15];解压即 weight = scale × (nibble - 8)。这种“单尺度 + 相对零点”的做法在块内权重分布均匀时已经够用。
Q4_K:双层缩放与 8 子块的分层结构(block=256)
到了 256 元素的 k-quants 块,设计立刻复杂一层。Q4_K 的块内布局:
Q4_K 块(144 字节, 对应 256 个权重):+-------------+--------------+------------------------+---------------------+| fp16 d | fp16 dmin | 12 字节 packed scales | 32x4 nibble 权重 || 2 字节 | 2 字节 | (8 子块 scale+min) | 每字节 2 个 nibble |+-------------+--------------+------------------------+---------------------+d 是块级缩放,dmin 是块级最小值缩放。中间的 12 字节是这条格式最精巧的部分——8 个 32 元素子块,每子块各有一个 6-bit scale 和一个 6-bit min,共 96 bit,紧凑地揉进 12 字节。quants.py 中 Q4_K.get_scale_min 的注释逐字节画出了这 96 位的编排:前 8 字节按 EEAAAAAA 的方式各装一个 0–3 位的低 6 位,后 4 字节交错补齐高 2 位。解包后第 个子块的权重还原公式为:
是子块内权重, 是 nibble 定量值, 与 分别是该子块解包出的 6-bit scale 与 min,均在 0–63 之间;两个子块修正值分别还要乘上块级的 与 。
为什么 256 元素块需要两层缩放?原因可以从有效位预算推出来。一个 fp16 scale 只有 2 字节,若由它单独承担 256 个权重的动态范围,块内离群权重会让 scale 急剧膨胀,其他权重就被压进 4 bit 表示的死区;把 256 切成 8 个 32 子块、每子块独立的 scale/min,相当于把“局部动态范围匹配”从 fp16 的一个自由度升级成“fp16 全局尺度 + 每子块两级 6-bit 修正”,等于在 4-bit 整数固定前提下多出 8 组自由度,这正是 Q4_K 与 Q4_0 在困惑度上拉开差距的来源。这个两层缩放思想是全部 k-quants 的共同骨架,Q5_K 在此之上把 nibble 加一位提升到 5 bit,Q6_K 改为“6-bit 定点 + 每 16 权重一个 int8 scale”,变的是分辨率分配方式,不变的是分层匹配动态范围的设计逻辑。
把每个点按“量化模型体积占 fp16 体积的比例”归一化后重画,就是上图中那条曲线的另一种读法——y 轴换成相对困惑度增量,横轴换成体积比:
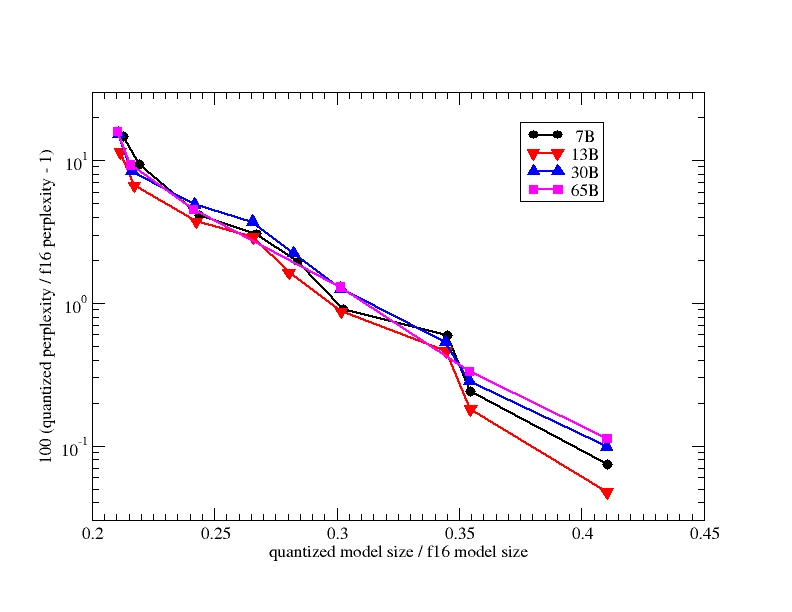
这条曲线的价值在于可比性:2B、7B、13B、30B、65B 五个规模的模型画在同一条带上,说明块布局的误差水平几乎不随模型规模变化——PR 作者特别指出这个观察与“模型越大、权重越冗余、量化误差应该越小”的直觉相反。同一套 144 字节或 176 字节的块结构,从 2B 到 65B 都维持相近的相对误差,说明误差由块内的缩放结构而非权重本身的统计性质主导。
Q5_K 与 Q6_K:位宽扩展的两种实现
Q5_K(176 字节,256 权重)在 Q4_K 基础上额外拉出 32 字节的 qh(QK_K/8),每个字节 8 位对应 8 个权重的第 5 位,与低 4 位 nibble 组合出 5-bit 定量;它的 packed scales 同样是 12 字节 8 子块双 6-bit 结构。Q6_K 则换成另一种实现:去掉逐子块 scale 数组,权重存 6-bit 定量(ql 与 qh 两段组合),每 16 个权重共享一个 int8 scale,再乘一个块级 fp16 d。对比可见设计空间的两个方向——子块数 vs 内部位宽,不同类型在“块级 fp16 + 子块修正”的公共框架下选不同的分配点。
Q8_0 与 Q8_K:解压路径上的中间精度
Q8_0(34 字节,32 权重)把每个权重直接存成 int8,加一个 fp16 scale;它是所有量化格式的解压缩目标之一——llama.cpp 的很多 kernel 会先把低比特块解压成 Q8_0 再做矩阵乘,或者让 Q8_K 承担这个中间角色(256 元素块的布局为 float 缩放 4 字节 + 256 个 int8 + 每 16 个量值求和的 16 个 int16 部分和,共 292 字节)。理解 Q8_0 的位置有助于读 kernel 源码:量化推理的整个链路是“低比特落盘 → 加载时按块解到中间精度 → 中间精度做 SIMD 矩阵乘”,Q8_0 是这条链路默认的通用中间货币。
i-quants 簇:把 4-bit 整数推广成码本查找
IQ 系列是 k-quants 的最近一次大更新。IQ4_XS 用一个 16 元素非均匀码本替代直接 nibble 编码,IQ2/Q3 系列进一步把权重聚类后按码本索引存储,IQ1_S 甚至把权重压到 1–2 bit、代价是激活极值需要额外处理。与 Q 系列的关键差别是 IQ 系列把量化从“找 scale”变成“近似一个码本”,理论上更接近 k-means 的极限;工程代价是 kernel 端需要码本查找表,位布局的位操作也要复杂一档。GGUF 在格式层为它们保留独立的类型枚举,加载端按类型选 kernel,格式契约不变。
工程含义:容器与块布局如何共同决定部署体验
为什么 144 字节的 Q4_K 块比 4.5 有效位更重要
从部署视角看 k-quants 的分层设计,真正被买断的是块内动态范围匹配而非纸面位数。一个 8 层缩放的 Q4_K 块与一个单尺度的 Q4_0 块都是 4.5 有效位,但在真实权重分布下前者的重建误差更接近 k-means 最优。本站此前拆解的 QuaRot 从算法侧用 Hadamard 旋转解决离群值,SmoothQuant 用数学等价迁移离群值;在 llama.cpp 侧同一问题的格式侧答案是“块够小、自由度够多”。两层机制并不冲突:一个 QuaRot 处理过的模型落成 GGUF 时,k-quants 的小块结构依然在发挥自己的作用。
启动开销与 mmap:GGUF 为何能被端侧设备欢迎
元数据字典 + 张量清单 + 对齐数据区的三层结构,让“打开一个文件 = 打开一个模型的全部”在 mmap 下变得极快:llama.cpp 启动时只需要读头部和清单两次顺序 I/O,之后的任何权重访问都是按需页调入。对比动辄数 GB 的 fp16 权重需要先整段读入再解压的方案,这是“手机起一个 7B Q4 模型只要几百毫秒”的格式层根源。
逐张量混合精度与“敏感层保留”的格式基础
GGUF 把量化类型作为每张张量的独立字段,直接催生了 llama.cpp 社区的混合量化传统:imatrix 校准的重要层用 Q6_K/Q8_0,其余层用 Q4_K/Q5_K,同名张量在不同量化输出里各自落位。这类“哪层多花几个 bit”的决策算法上属于量化范畴,但它能落地的前提是容器允许逐张量声明类型,这也是 GGUF 作为容器格式在工程上的独特贡献。
参考资料
- GGUF 格式规范(llama.cpp 仓库 gguf-py 的 README 与示例脚本)
- gguf-py/gguf/constants.py——魔数、版本、GGML_QUANT_SIZES 表与元数据键定义
- gguf-py/gguf/gguf_reader.py——头部解析、元数据与张量条目结构
- gguf-py/gguf/quants.py——k-quants 各类型的参考量化/反量化实现
- GGML 库源码——block_q4_K 等块结构定义(ggml-common.h)与 k-quants kernel
- k-quants 原始 PR(ikawrakow,2023 年 6 月合入,含全部困惑度实测数据与两张原始曲线图)
- Hugging Face GGUF 文档——格式概览与转换工作流
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


