


扩散模型从零讲起(十四):图像编辑与反演——SDEdit、DDIM 反演与整流流编辑,如何在「不改结构」的前提下换掉细节
写在前面:编辑比生成多了一个约束
生成模型的输入是一句提示词,输出是一张图;编辑模型的输入是一句提示词加一张已经存在的图,输出是”这张图按提示词改过之后的样子”。多出来的那张图,把问题从”从噪声里采样一个样本”变成了”在一个样本附近采样,但不能跑太远”。
这个差别看似只是多了一个条件,实际却改变了整个推理路径。文生图的采样可以看作在数据分布上自由落体:模型每一步只需要满足提示词,不需要对任何具体像素负责。编辑必须同时满足两个互相拉扯的目标:
- 保真度(fidelity):输出要保留原图的身份、构图、几何结构、背景纹理。改一张人像的头发颜色,脸不能变;改一张室内照片的墙面材质,窗框和家具位置不能挪。
- 真实感(realism):输出必须仍然落在模型学到的数据流形上,不能因为强行保留原图像素而出现糊边、拼接痕、颜色撕裂。
这两个目标在数学上并不总能同时满足,因为”保留原图”意味着输出要靠近一个特定的点,而”看起来真实”意味着输出要靠近整个数据流形。原图本身可能就在流形上,但”改过之后仍然真实”的那个点,未必能从原图直接走过去。扩散模型处理这个矛盾的整套技术,统称为反演(inversion)与编辑(editing)。
这一篇讲的是扩散模型最基础的一层编辑能力:不训练新模型、不引入额外控制网络,只靠采样器本身完成”改内容、保结构”。它上承第六篇的采样器推导(DDIM、Heun、DPM-Solver 的离散化方式决定反演精度),也承接第十二篇的连续时间 SDE 视角(反演本质上是把概率流 ODE 反向积分)。理解这一层之后,ControlNet 一类条件控制、以及 2025 年之后的指令式编辑模型,才知道它们各自绕开了什么。
按这个思路,本篇分八层推进:
- SDEdit:最朴素的办法,把原图加噪到中间时刻,再从那里去噪;
- DDIM 反演:把采样器反过来跑,把图像映射回噪声;
- 反演误差的来源与量级:为什么”反过来跑”不等于”精确求逆”;
- null-text 反演与 EDICT:用优化或双变量耦合补上可逆性;
- 交叉注意力注入:反演给出起点,注意力替换与掩码决定”改哪里”;
- 整流流(Rectified Flow)时代的反演:FLUX 类模型为什么换了一套做法;
- 编辑的推理账本:每种路线要跑多少次前向、显存占用多少、适合什么场景;
- 现代编辑模型为什么绕开反演:InstructPix2Pix、Kontext 与局部重绘的分工。
最后再回答一个现实问题:既然反演这么麻烦,为什么 2025 年之后的主流编辑模型(Flux Kontext、Step1X-Edit、OmniGen 一类)干脆不做反演了?答案不在数学里,而在训练目标里。
一、图像编辑到底在要求什么
先把”编辑”拆成几种可计算的形式,后面的所有方法都是在解其中某一种。
三种入口:加噪、反演、条件
给定原图 、源提示词 、目标提示词 ,一次编辑通常要求输出 满足:
- 结构一致: 与原图在深度、边缘、布局上接近;
- 语义改变: 描述的新属性出现在输出里, 描述的被替换掉的部分消失;
- 分布合法: 像一个真实样本,而不是两张图拼起来的。
围绕这三个要求,出现过三条完全不同的技术路线。
第一条是”从中间时刻重新出发”,代表是 SDEdit。它不试图把原图映射回纯噪声,只在原图上加一部分噪声,让模型从半噪声状态重新去噪。加多少噪声,就是编辑强度的旋钮。
第二条是”先把原图映射回噪声,再用新提示词走回来”,代表是 DDIM inversion、null-text inversion、EDICT、RF-Inversion。这条路要求存在一条从图像到噪声的可逆轨迹,编辑发生在轨迹的终点:同一张噪声、不同的提示词,走出来就是两张”同源不同命”的图。
第三条是”把编辑当成条件生成”,代表是 InstructPix2Pix、Flux Kontext。模型在训练时见过大量”原图 + 编辑指令 → 结果图”三元组,于是编辑指令本身成了条件,反演这一步被训练数据吸收了。
前两条属于”推理时技巧”(training-free),第三条属于”训练时吸收”(training-based)。本篇重点在前两条,因为它们把扩散采样的数学性质暴露得最清楚;第三条放在最后作为对照。
潜空间编辑的一个额外麻烦
现代文生图模型几乎都在 VAE 的潜空间里做扩散(第四篇讲过 latent diffusion 的分工)。这意味着编辑发生在 上,而不是像素上。VAE 的编码器是有损且非单射的:两张肉眼不同的图可能编码到相近的 ,同一个 解码出来也会有细微差异。
这带来两个后果。其一,即使反演在潜空间里完全精确,解码回像素时也会有一次重建误差;其二,“保留原图细节”这件事在潜空间里没有像素级对应物,模型只能保留它认为重要的语义与结构。因此潜空间编辑的评价指标通常不是 PSNR,而是 LPIPS、CLIP 相似度、结构距离一类更宽松的度量。
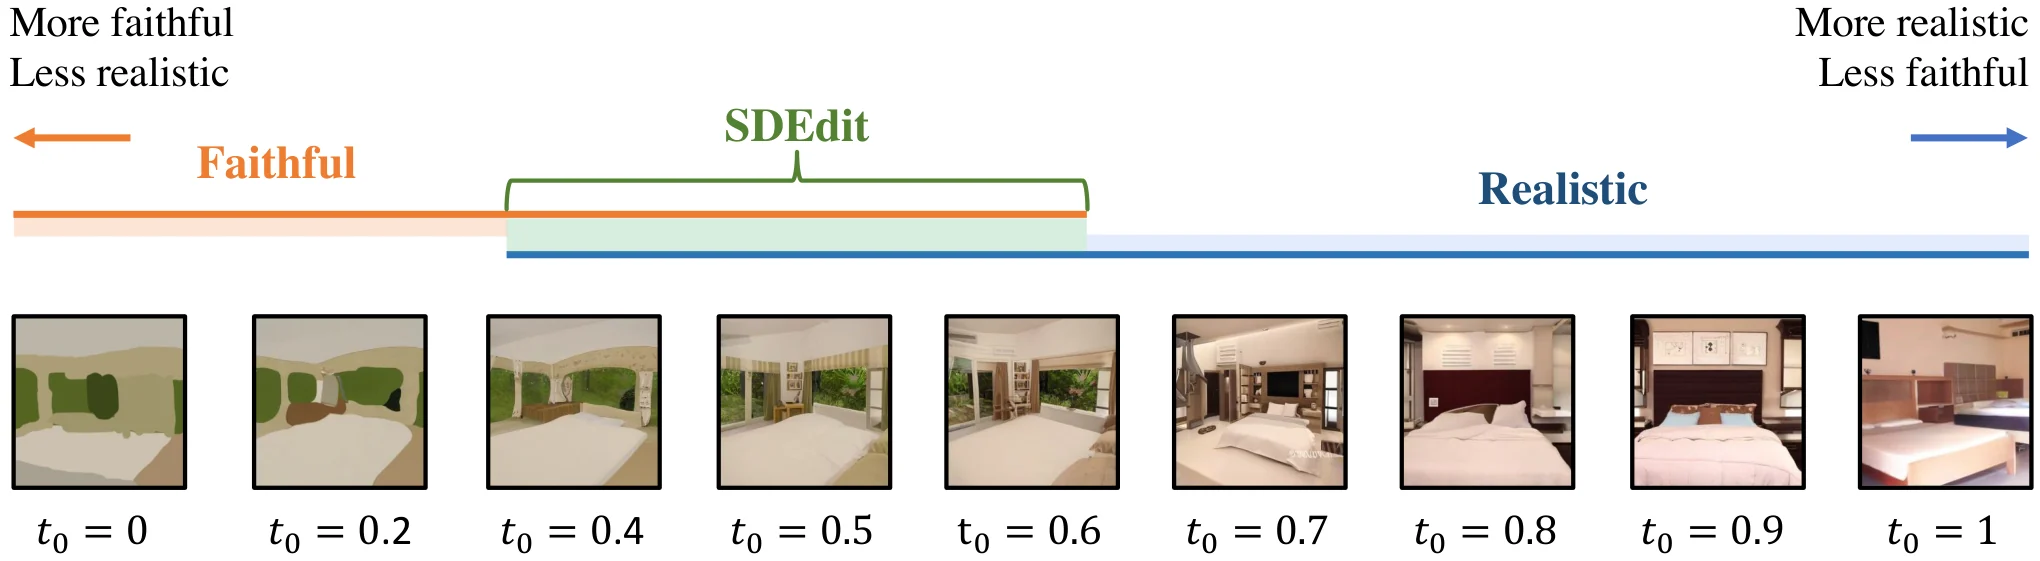
上图来自 SDEdit 原论文(Meng et al., ICLR 2022)。横轴是加噪起点 的取值,纵轴的两个方向分别代表”更忠实于引导图”与”更真实”。可以看到 很小时输出紧贴原图但边缘出现明显伪影; 增大后画面变干净,但与原图的结构对应逐渐松散。这张图基本上是整篇文章的提纲:编辑的第一个工程决策,永远是在哪个噪声水平上介入。
二、SDEdit:从中间噪声起步,让先验抹掉细节
SDEdit 全称 “Guided Image Synthesis and Editing with Stochastic Differential Equations”,2021 年由 Meng 等人提出、发表于 ICLR 2022。它的做法简单到可以用三行伪代码写完,但背后的权衡值得展开。
算法:加噪到 ,再去噪
给定引导图 (可以是手绘草图、色块图、另一张照片),选定起点 :
- 采样噪声 ;
- 按前向过程的闭式采样公式,把引导图加到 时刻:
- 从 开始,用任意反向采样器(DDPM、DDIM、SDE)跑到 ,条件用目标提示词(或不用条件)。
第一步用的正是第一篇推导过的”一步到位”性质: 是高斯,均值为 、方差为 。所以不需要真的迭代加噪 次,一次采样就够。
第三步只跑 这一段,因此计算量是完整生成的 倍( 越接近 ,即加噪越多,需要跑的步数越多)。
为什么”加噪再去噪”能编辑
直觉是:前向加噪在破坏信息,而且破坏是有顺序的。低频、全局的结构(人脸轮廓、物体位置、大色块)在高噪声水平下仍然可辨;高频、局部的细节(发丝、纹理、笔触)先被抹掉。
把图加到 ,相当于”保留到第 级的信息粒度”。反向去噪时,模型会用它学到的先验去补全被抹掉的部分。补全的结果既服从引导图残留的结构,又服从模型对”这类图应该长什么样”的知识。于是手绘色块会变成照片,粗糙草图会变成细节丰富的画,而构图大体不变。
用分数视角说更准确。反向采样的每一步都在沿着 走,也就是往”当前噪声水平下高概率的区域”走。 由引导图加噪得到,它本身未必在高概率区域;反向过程会把它拉向流形,拉动的幅度取决于它离流形有多远。加噪越多, 离原图越远、离”纯噪声的典型样本”越近,模型可发挥的自由度越大;加噪越少, 越贴着原图,模型只能在很小的邻域里修正。
的选择:一个被工程化的连续旋钮
在 Stable Diffusion 一类实现里, 被包装成 img2img 的 strength 参数:strength 是实际执行的去噪步数占总步数的比例,等价于把原图加噪到 的水平。strength 越大,起点噪声越高、改动越大;strength 越小,越接近原图。读源码时最好对着”实际跑了多少步、起始时间步是多少”来确认,而不是只看参数名,因为不同框架对 strength 的定义与截断方式并不完全一致。
的选择没有通用最优值,它取决于编辑类型:
- 换风格、换材质、把草图变照片: 取中等偏大,让模型有足够自由度重绘高频细节;
- 换颜色、换表情、局部改物体属性: 取中等偏小,保住几何;
- 只想做轻微降噪或超分: 很小,几乎等价于”以原图为条件的去噪”。
太大时会出问题: 已经接近纯噪声,引导图的信息被淹没,输出基本等于重新生成,与原图失去对应。 太小时也会出问题: 对模型来说是分布外的点(它带着原图的高频结构,而模型在这个噪声水平上从没见过”加噪的图像”这种精确形态),反向第一步的预测就会偏,输出容易出现过度锐化、色偏或”贴图感”。SDEdit 论文里把这两个失效方向分别称为”不够真实”和”不够忠实”,就是第一张图纵轴的两端。
与 CFG 的叠加
SDEdit 本身不规定条件形式。实际使用时几乎总会叠加 classifier-free guidance(第十三篇):每步跑两次前向(条件分支与无条件分支),再线性外推:
这带来两个后果。计算上,SDEdit 的成本从 次前向(只跑 这一段)变成 次;行为上, 越大,模型越激进地把输出拉向提示词,越容易破坏原图结构。所以在 img2img 工作流里,strength 与 guidance_scale 是一对需要联合调的参数:想保结构就压 、降 strength(即降 );想强遵循就抬 、抬 strength,并接受结构漂移。
SDEdit 的局限
SDEdit 只解决了”从哪个噪声水平介入”,没有解决”如何精确回到原图”。它有两个结构性局限:
其一,不可复现的对应关系。同一个 、同一个种子、同一张图,改动提示词后输出的差异并不受控;你无法指定”只改这一块,其他像素完全不动”。因为整个潜变量都在被重新采样,模型没有”局部冻结”的机制。
其二,编辑与重建不可分离。如果目的是”用同一个提示词重建原图”,SDEdit 做不到近似恒等:只要 ,加噪就丢了信息,去噪补回来的是模型的猜测而不是原像素。要做”改一点、其余完全保留”,就必须先能把原图精确映射到噪声、再精确映射回来——这就是反演要解决的问题。
三、DDIM 反演:把采样器反过来跑
反演(inversion)的目标是找到一个噪声 ,使得从 出发、用源提示词采样,能重建出原图 。如果这件事能做到,编辑就变成:同一个 ,换目标提示词再采样一次。
DDIM 是第一代被广泛用于反演的采样器,原因是它确定性:给定 和条件,采样轨迹唯一,不依赖随机数。确定性是反演的前提——如果采样本身带随机性,同一个 会走出不同轨迹,“找到能重建原图的 “就没有唯一解。
回顾 DDIM 的更新式
第一篇推导过,DDIM 从 到 的更新为:
其中 是由当前噪声估计反推的”干净图预测”:
把 代回,得到只含 与 的形式:
整理系数后可以看到,DDIM 的每一步本质上是”把 分解成信号方向与噪声方向,按两个时刻的 SNR 重新配比”。这个配比是可逆的代数关系,只要知道 就能从 反解 。
反演式:把下标倒过来
把上面的更新式当作方程,已知 求 ,得到:
这就是 DDIM inversion 的标准形式。注意它与前向更新式长得几乎一样,区别只有两处:
- 时间下标整体后移一位:用 时刻的模型输出重建 时刻的变量;
- 的输入是 ,而不是 。
这两处区别正是全部误差的来源。真正的逆应该用 ,但反演时 正是要求的未知量,只能退而求其次用已知的 处的预测代替。
一次反演 + 一次生成的流程
完整的 DDIM 反演编辑分四步:
- 反演:从真实图像 出发,按上面的反演式逐步从 推到 。注意反演式在 接近 0 时数值上很敏感(,信号项与噪声项量级接近),实现上通常从 起算,或者先用闭式前向公式把 加噪到一个很小的 再开始;
- 可选替换:得到潜噪声 ;
- 生成:从 出发,用目标提示词 按正常 DDIM 采样跑回 ;
- 解码:。
反演时用哪个提示词是一个关键设计点。Prompt-to-Prompt(Hertz et al., ICLR 2023)在处理真实图像编辑时,用源提示词做反演、用目标提示词做生成(它同时还有一条不依赖反演、只做注意力注入的路线,见第六节)。这样反演轨迹贴合原图的语义,保证 是”原图在源提示词条件下的噪声坐标”;生成时换条件,相当于在同一个坐标上改变条件方向。
如果反演时也用目标提示词,会发生什么?反演式里的 会试图把原图往目标语义上解释,得到的 不再是原图的忠实坐标,而是”原图在目标提示词下的一个近似解释”。这会让编辑更激进、结构漂移更大。工程上偶尔有人故意这么做来换更强的编辑力度,但这就退化成了一种昂贵的 SDEdit。
为什么反演比 SDEdit 强
SDEdit 的加噪是前向过程:它按固定方差的马尔可夫链把原图推向噪声,模型不参与。DDIM 反演是反向过程的逆:每一步都用模型预测的噪声方向来构造,模型实际上在”解释”这张图。
这个区别决定了保真度上限。SDEdit 加噪到 时, 的具体取值由随机噪声 决定,与模型无关;去噪时模型看到的点,是”原图加了一个随机扰动”,它不知道这个扰动对应什么语义。DDIM 反演得到的 则经过模型逐级解释,落在模型认为”这张图应该来自哪里”的位置上,因此从它出发重建,重建结果更接近原图。
代价是计算量:反演要跑 步,生成再跑 步,总共 次前向;如果开 CFG,则是 次(反演与生成各两次分支)。相比之下 SDEdit 在 时只要 次前向(开 CFG 为 )。
四、反演误差从哪来:一阶近似的可逆性缺口
DDIM 反演在文献里最常被诟病的一点是”反演不精确”:反演得到 ,再用同一提示词生成回来,得到的图与原图有明显差异。这个差异不是实现 bug,而是离散化与模型非线性共同造成的,可以拆成三项。
误差项一:噪声预测的取值点错位
真实的 DDIM 更新定义了一个映射 。反演想要的是 。但 依赖 ,而 需要的是 在未知的 处的值。反演式用 替代,相当于假设:
这是把噪声预测沿轨迹做了一步”平移”。在轨迹光滑、步长很小的时候这个近似成立;步长变大或模型对 敏感时,两项可以差很多。
把 在 处做一阶展开,可以估计误差的量级。设 ,则
反演式只保留了零阶项,丢掉的两个一阶项都与步长成正比。所以反演误差是一阶的:步数加倍,单步误差减半,但步数也加倍,总误差的量级大致不变或缓慢下降,不像 ODE 高阶求解器那样能快速收敛。这是 DDIM 反演精度对步数不敏感、却对轨迹曲率很敏感的根本原因。
误差项二:轨迹曲率与步数
DDIM 的确定性采样可以看成概率流 ODE 的一种离散化。若把 DDIM 更新写成 的形式,它就是一阶 Euler 格式。Euler 格式的全局误差是 ,反演再引入一次同阶误差,两者叠加。
对于曲率大的轨迹(提示词复杂、图像细节多、CFG 强度高),Euler 的切线近似很快失效,反演与生成走的是两条不同的折线。结果就是”反演过去的点,走不回来”。
第六篇讲过 DPM-Solver 与 Heun 这类高阶采样器能把生成步数压到 20 步以内;但高阶采样器不一定有配套的高阶反演。Heun 是二阶方法,理论上有可逆的二阶格式,实践中多数编辑流水线仍然用 DDIM 反演,因为它的代数形式简单、显存开销小,且误差可以用后续手段补偿。
误差项三:CFG 放大了非线性
开 CFG 后,用于更新的噪声预测是 。这是一次线性外推,但外推的输入是两个非线性网络的输出, 又把两者的差放大。 从 1 增到 7.5 时, 对 的 Jacobian 范数大致也按 的量级增长,于是同一个步长下 Taylor 展开的余项更大。
这解释了一个常见现象:CFG 强度越高,DDIM 反演越不稳。用 反演、 生成,轨迹会明显偏离;两边都用 也不解决问题,因为高 下反演本身就不准。
误差的可见形态
反演误差在输出上的表现有几种典型形态,工程上可以直接用来判断问题出在哪:
- 整体色偏或亮度漂移:通常来自反演终点 没有落在正确的噪声尺度上,重建时模型的均值预测有系统偏差;
- 结构轻微错位(人脸五官偏移几像素、物体边缘重影):一阶项误差累积,轨迹回不到原点;
- 局部细节被”重绘”(纹理改变但语义没变):高频信息在反演中被模型当作噪声抹掉,重建时补了新的;
- 提示词换了但画面几乎没变:反演过度拟合源提示词, 已经包含了源语义的强约束,目标条件无法覆盖。
这四种形态分别对应不同的调参方向,而不是简单地”加步数”。加步数只能缓解第二、三种,对第一、四种基本无效。
一个实用的诊断方法
判断反演质量最直接的办法是做恒等重建测试:用源提示词反演,再用同一个源提示词生成,比较输出与原图。如果重建误差已经很大,那么任何编辑结果都不可信,因为误差不是编辑带来的。
这个测试在工程上应该作为流水线的第一步。它还能顺带校准两个参数:反演步数与 CFG 强度。通常的做法是固定生成侧参数,扫反演步数与反演侧 ,找重建 LPIPS 最低的组合;然后再用这组参数做实际编辑。注意反演侧与生成侧的 可以不同,很多实现允许分开设置。
五、null-text 与提示词嵌入的可学习反演
既然误差的根源是”反演式只能拿到错位一步的噪声预测”,一个自然的想法是:把误差吸收到一个可学习的变量里,让反演轨迹重新闭合。null-text inversion 就是这条思路最著名的实现。
核心观察:误差可以集中到空条件上
Null-text inversion(Mokady et al., CVPR 2023)处理的是带 CFG 的 Stable Diffusion。它注意到:CFG 的更新式里有两个分支,条件分支携带提示词语义,无条件分支(null-text embedding,即空字符串的文本嵌入)只提供”无条件的基准”。
如果反演不精确,误差会同时污染两个分支。但编辑时真正需要保持干净的是条件分支——它决定语义。于是可以把误差全部推给无条件分支:固定条件嵌入,优化每一步的无条件嵌入,使得反演轨迹能够精确重建原图。
具体地,对每个时间步 ,引入一个可优化的空嵌入 ,反演式变为:
优化目标是让反演轨迹与”真实的前向轨迹”一致。真实轨迹由 DDIM 采样定义:从 出发,用目标条件一步步生成到 ,这条轨迹记为 。然后优化:
这里 是真实轨迹上的点, 是用当前空嵌入从 走一步的结果。每一步只优化一个向量(空嵌入,长度等于文本编码器的嵌入维度,通常 768 或 1024),优化变量很小,但步数多。
为什么优化空嵌入而不是条件嵌入
两个原因。第一,空嵌入在语义上没有内容,改动它不会改变提示词的含义,只改变 CFG 的基准线;第二,空嵌入在所有时间步上本来就可以不同(实现里通常每步存一份),自由度足够吸收轨迹误差。
如果改条件嵌入,等于在改提示词,编辑的语义就不受控了。这是 null-text 设计与 prompt-tuning 类方法的本质区别:前者把模型当作固定函数,只调一个”无意义”的输入;后者改的是语义表示。
成本:从 到
null-text 的推理成本很重。设总步数 、每步优化迭代 次、每次迭代一次前向。反演本身要 步(每步一次前向,CFG 下两次),优化过程每步 次前向,生成再 步。总量约为:
典型配置 、,就是 600 次前向,比普通 DDIM 反演贵一个数量级。这也是 null-text 主要出现在”单图精修”场景、而不出现在批量编辑服务里的原因。
一个更轻的变体:只用一次优化
后续工作提出过多种降本方式:只优化前若干步的空嵌入、用低秩适配器参数化 、或用一次前向的梯度近似代替完整优化。它们的共同思路是承认”误差主要集中在轨迹前段(高噪声)“,把优化预算花在少数关键步上。
这条线走到极致就是免优化的补偿:不优化嵌入,而是在反演时对噪声预测做一个解析的修正项,把一阶 Taylor 项补回去。这类方法(如 BDIA、负提示词反演)成本接近普通 DDIM,但收益也更有限。
EDICT:用两个变量换精确可逆
另一条完全不同的思路是改采样器本身,让它代数上精确可逆。EDICT(Wallace et al., ICML 2023)维护两份潜变量 与 ,交替用对方作为条件做 DDIM 更新:
反演时把这两步倒着执行。由于每一步的输入都显式保存在另一个变量里,整个变换是精确可逆的——不需要近似,误差只有浮点舍入。
代价有三点。其一,计算量翻倍:每步两次 DDIM 更新,反演加生成共 次前向,CFG 下 。其二,两份变量的均值才是最终输出,单份变量会有偏差,混合系数需要调。其三,交替更新改变了采样动力学,输出分布与标准 DDIM 不完全一致,可能出现对比度或细节上的差异。
EDICT 的意义更多是理论上的:它证明了”精确可逆”在扩散采样器里是可达的,代价是维度与计算。后续的 BDIA、双向积分方法都可以看作在”可逆性”与”成本”之间找不同折中点。
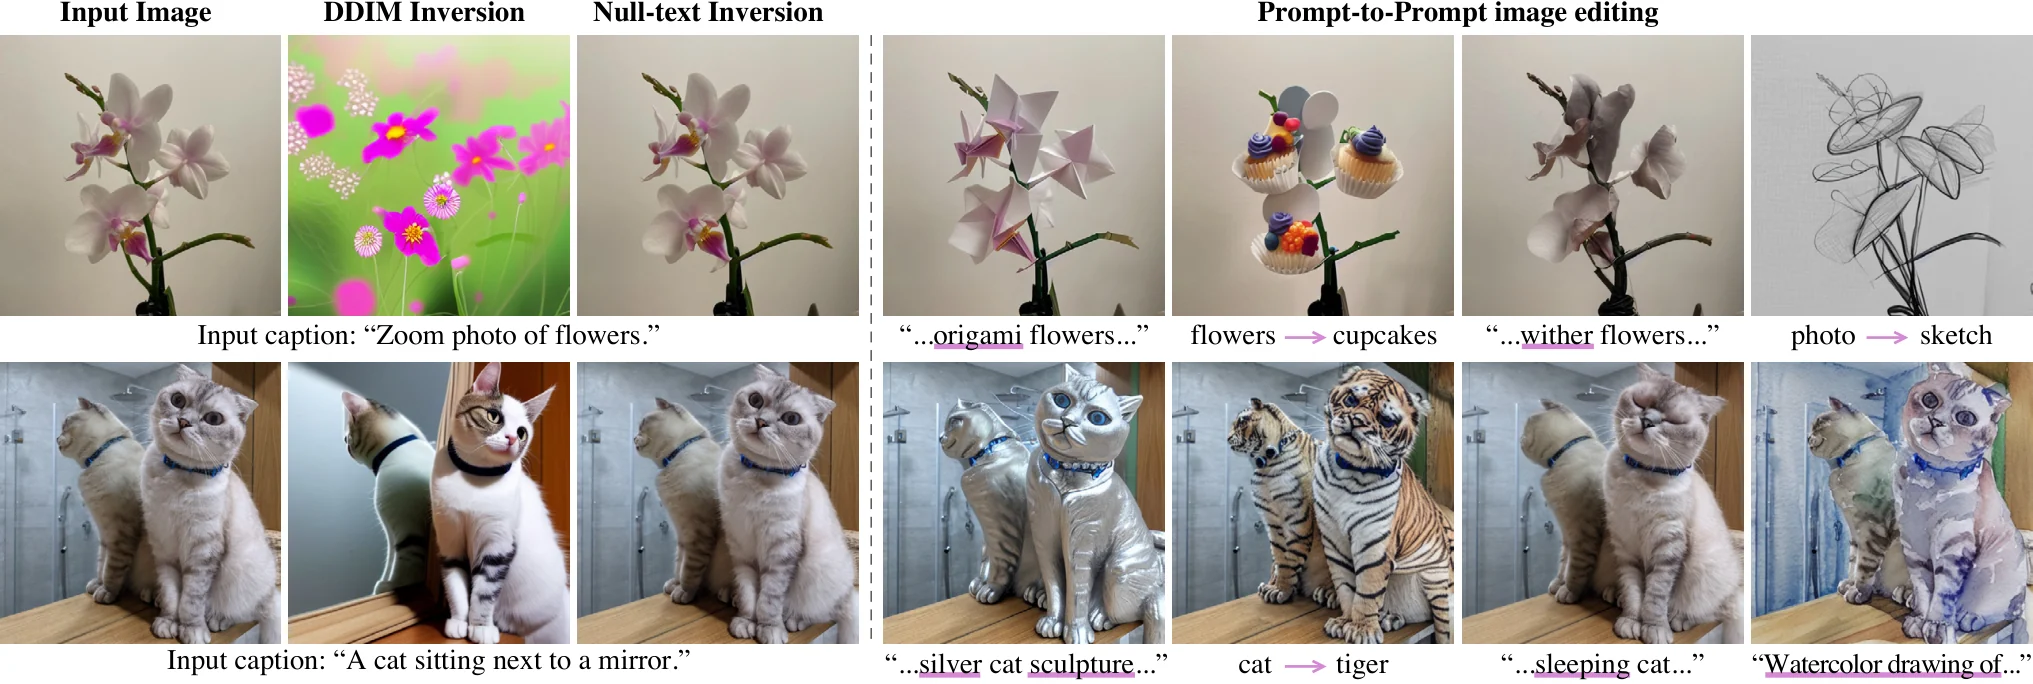
上图来自 null-text inversion 原论文(Mokady et al., CVPR 2023)。每一列从上到下依次是输入图、DDIM 反演编辑结果、null-text 反演结果,以及用同一噪声做的 Prompt-to-Prompt 编辑。可以看到 DDIM 反演那一行的结构虽然大体保留,但原图身份细节已经漂移(花朵的形态、猫的姿态都变了),而 null-text 这一行能在改语义的同时把物体形态基本锁住。这就是”把误差吸收进可学习变量”带来的直接收益。
与 SDEdit 的关系
null-text 与 EDICT 都属于”精确重建”路线,目标是让反演—生成对构成近似恒等映射。它们与 SDEdit 的关系是互补而非替代:
- SDEdit 解决”编辑强度”问题,给出一个连续的控制旋钮;
- 反演类方法解决”重建保真”问题,让改动精确可控;
- 实际流水线常常两者叠加:先用反演建立精确对应,再在选定的噪声水平上替换条件、叠加引导。
六、交叉注意力注入:为什么”换提示词”还不够
反演解决的是”从哪里出发”,但决定”改哪些像素”的,是文本条件在扩散过程中的注入方式。理解这一层,才知道为什么同一个反演噪声配上不同提示词,有时会得到”整体都变了”而不是”只改了目标区域”。
文本是如何进入 U-Net 的
第四篇讲过,latent diffusion 的主干是 U-Net 或 transformer,文本先经编码器变成 token 序列 ,再通过交叉注意力注入到每个网络块:
其中 来自图像特征。注意力矩阵 的每一列对应一个文本 token,每一行对应一个图像位置。 可以理解为”图像位置 有多依赖文本 token ”。
这个矩阵就是编辑的”空间旋钮”。Prompt-to-Prompt 的观察是:同一个句子里改一个词,改动应当集中在那个词对应的注意力列上。如果原句中”a cat”的 token 主要作用于画面中间区域,那么把”cat”换成”tiger”时,只要把新 token 的注意力”投影”到原 token 的注意力分布上,改动就会被限制在猫所在的区域。
注意力替换与权重缩放
Prompt-to-Prompt 给出两种最常用的操作:
注意力替换(attention injection):生成时保留目标提示词的注意力矩阵 ,但把源提示词中某个 token 对应的列换成源矩阵里的列 。这样新 token 的语义被写入,但空间作用范围跟随源 token。
这里有一个维度对齐问题:新旧句子的 token 数往往不同(“a cat”两个 token,“tiger”一个 token),实现上需要按对齐规则把源列映射到目标列,或者对源列做池化再广播。常见的简化是按词的位置对应,复杂实现会做最优传输一类的匹配。
权重缩放(attention re-weighting):不替换,而是把某些 token 的注意力列乘以系数 ( 增强、 抑制),并重新归一化:
这套操作在推理时逐层逐步执行,不需要训练,也不增加前向次数——只多出一点注意力矩阵的读写开销。它回答的是一个 SDEdit 与反演都没回答的问题:编辑应该在空间上落在哪里。
为什么注意力列可以当作”区域”
这背后有一个经验假设:扩散模型的交叉注意力在中层(分辨率适中、语义足够抽象)学到的 attention map,与物体的空间位置有较强对应关系。高层的注意力更偏全局,低层更偏局部纹理,所以多数编辑实现只在中层注入、或者在全部层上按注意力熵做加权。
这个假设并非普遍成立。当句子结构复杂、物体有遮挡、或者同一物体出现多次时,注意力列的空间对应会变得模糊,“只管改这一块”的约束就会失效。工程上常见的补救是把注意力注入与掩码结合:外部给出一个二值掩码,在反向过程的每一步把掩码外的潜变量替换为反演轨迹的值,强制”掩码外不动”。
掩码约束的两种实现
潜空间硬替换:每一步先正常计算 ,再执行
其中 是反演轨迹上的对应点。这个做法简单直接,但硬替换把两个分布外拼接的潜变量送进下一步,模型会看到不自然的边界,输出容易出现接缝。
软约束:在损失或采样里加一项,让掩码外的区域与源轨迹的偏差按权重惩罚,或者像 RePaint 那样用重采样让边界逐步融合。软约束需要多次前向,但接缝明显更少。
两种实现都要求源轨迹 已经算好,因此掩码编辑几乎总是站在反演之上:没有精确轨迹,“掩码外不动”就无从谈起。这也是局部编辑服务通常按”反演 + 掩码 + 重采样”三段来做延迟预算的原因。
这解释了为什么”局部编辑”在推理侧一直是个系统工程问题:反演给出精确起点,注意力注入给出粗略区域,掩码给出硬边界,三者必须配合,单用任何一种都不足以稳定地产出”只改该改的地方”。
七、整流流与 FLUX 时代的反演编辑
2023 年之后,文生图主干模型从”DDPM/DDIM 噪声预测”逐渐转向整流流(Rectified Flow)与 flow matching。这个转向对编辑的影响很大,因为 DDIM 反演依赖的代数可逆性在新采样器里不再天然成立。
整流流采样的结构
第一篇讲过,整流流训练一个速度场 ,采样是从 的噪声积分到 的数据:
实践中用固定步数的 Euler 或高阶 ODE 求解器离散化:每步 ,时间方向从噪声到数据。整流流论文(Liu et al., ICLR 2023)的核心主张是:把直线轨迹”reflow”之后,路径更接近直线,Euler 的离散误差更小,少数几步就能走完。
这与 DDIM 的结构性差异在于:DDIM 每步的更新系数是按 的解析公式算的,轨迹形式被强约束在”信号与噪声按 SNR 配比”的族里;整流流的速度场由网络自由输出,没有这个约束。前者的可逆性来自公式对称,后者的可逆性是轨迹本身的属性。
直接”倒着积分”为什么不够
一个自然的反演想法是:把 ODE 的时间方向反过来,从数据点 积分回 ,得到噪声 ,再用新条件正向积分回来。这就是 RF-Inversion(Rout et al., 2024)所讨论的”vanilla”做法。
问题在于 Euler 离散化不是精确可逆的。正向积分用 ,反向整数时在 处求速度场,得到的是 ,两者相差一个 的项。这与第四节的 DDIM 一阶误差同源,只是发生在新采样器上。对直线性强的轨迹,误差小;对弯曲轨迹(提示词复杂、模型规模大、步数少),误差会累积成肉眼可见的结构漂移。
步数越少,这个误差越大——而整流流模型的设计目标恰恰是”少步采样”。于是出现一个尴尬的取舍:用 20 步采样很常见,但 20 步的 Euler 正向/反向误差已经足够让编辑结果偏离原图。
可逆求解器与不动点修正
RF-Inversion 给出的解法思路分两层。
第一层,用可逆的 ODE 求解器。如果在正向积分时同时计算速度场的雅可比(或者用可逆积分格式记录必要信息),理论上可以精确地反向积分。但雅可比的维数是潜空间维度平方,对 的潜变量来说代价过高。
第二层,更实用的做法是不动点修正(fixed-point correction)。反向积分得到 之后,再正向积分一次,比较重建结果 与原数据点 ,两者之差可以在反向积分时提前补偿:
这个迭代在”误差沿轨迹近似线性传递”的假设下收敛很快,一两轮就能把重建误差压下去。它本质上是用有限次前向把反演的误差显式测出来再扣掉,而不是靠解析公式保证精确。
时间步移位与编辑强度
整流流编辑还有一个与 SDEdit 对应的旋钮:在反演终点提前截断。完整做法是从 反演到 ,然后从 正向生成;如果想保留更多原图信息,可以反演到 (),再从 继续生成。
但要小心:整流流的时间步与噪声水平并非线性对应。许多模型在训练时用了时间步移位(time shift),把采样网格向高噪声端或低噪声端偏置。FLUX 一类模型引入的 shift 参数,目的就是让采样器在噪声高、信噪比低的阶段分配更多步数,避免低噪声阶段浪费步数。编辑时如果忽略 shift、按均匀网格截断,截断点对应的实际噪声水平就与预期不符,同一个”截断比例”在不同模型上给出的编辑强度可以差很多。
这是整流流编辑比 DDIM 编辑更难调的直接原因:DDIM 里 strength 与 的对应是解析的,整流流里要靠采样网格的 shift 规则来换算,不同实现口径不同。
为什么 FLUX 类模型更依赖训练式编辑
整流流反演的这些复杂性,解释了为什么 FLUX 生态里的编辑能力主要交给训练式的方法:FLUX.1 Kontext(2025)在训练时就把”输入图 + 上下文 token”当作条件,模型直接学会”在原图上按指令改”;RF-Inversion 这类免训练反演更多是研究工具,而不是生产流水线的主路径。
对推理系统的意义在于:免训练编辑不需要为编辑单独训练模型,但每次请求要跑反演加生成的多次前向,且精度受求解器限制;训练式编辑把反演的负担前移到了训练数据,推理时只需要一次条件前向,成本结构完全不同。
八、编辑的账本:前向次数、保真度与结构一致性
把前面几节的路线画成一张成本表,是工程选型时最实用的部分。设采样步数为 、开 CFG(两分支)、图像尺寸对应的潜空间前向时间为 。
各类路线的前向次数
- SDEdit:加噪 1 次(闭式,几乎免费)+ 从 生成到 的 步。CFG 下 次前向。反演部分成本为零。
- DDIM 反演编辑:反演 步 + 生成 步,CFG 下 次前向。
- null-text:在 DDIM 基础上,每步优化 次,约 次前向(反演侧与生成侧各开 CFG 时更高)。
- EDICT:每步两次更新,反演 + 生成共 ,CFG 下 。
- RF-Inversion:反演 步 + 生成 步,可逆求解器或不动点修正再加 ( 为修正轮数)。
以 、开 CFG、 估算:SDEdit 约 60 次,DDIM 反演约 120 次,null-text 约 300 次,EDICT 约 240 次。这个数量级解释了线上的编辑服务为什么普遍采用 SDEdit 型 img2img,而不是反演类方法:延迟差一倍以上,且反演对步数与 CFG 的调参成本更高。
保真度与结构一致性
前向次数只反映成本,效果要分开看两个维度:
- 结构一致性:输出与原图在布局、几何上的接近程度,可以用结构相似度或边缘距离衡量;
- 身份保真:输出是否保留了原图的”是谁、是什么”,通常用 LPIPS 或语义特征距离衡量。
SDEdit 的结构一致性由 控制,二者单调相关;反演类方法的结构一致性由反演精度决定,调参空间更小但上限更高。null-text 在身份保真上通常明显优于 DDIM 反演,代价是前向次数多一个数量级。
显存与批处理
反演类方法的显存开销也更高:DDIM 反演需要同时保存反演轨迹(反向生成时要用),EDICT 需要两份潜变量,null-text 需要每个时间步一份空嵌入并保存优化状态。批处理时这些额外状态会成倍放大。
对于批量编辑服务,“每张图一条独立的高精度反演”很难扩展;更现实的方案是把编辑请求当作短时任务,用较小的批、较高的并发调度,或者改用训练式编辑模型把反演代价前移。
九、现代编辑模型为什么绕开反演
2022 到 2025 年,编辑技术的主流路线明显从”推理时反演”转向”训练时条件”。理解这个转向的逻辑,比记住某几个模型名字更重要。
InstructPix2Pix:把编辑指令变成训练数据
InstructPix2Pix(Brooks et al., CVPR 2023)的思路是:既然反演的目的是”让模型知道原图长什么样”,那就直接把原图喂给模型。它用 GPT-3 生成”描述原文 → 改写描述”的文本对,再用 Prompt-to-Prompt 与文生图模型把这些文本对落地成”原图 → 编辑后图”的图像对,然后用这些三元组微调一个以图像为条件的扩散模型。
推理时只需要一次条件生成:输入原图(经 VAE 编码)+ 编辑指令文本,直接输出结果。没有反演,没有恒等重建测试,成本与普通文生图相当。
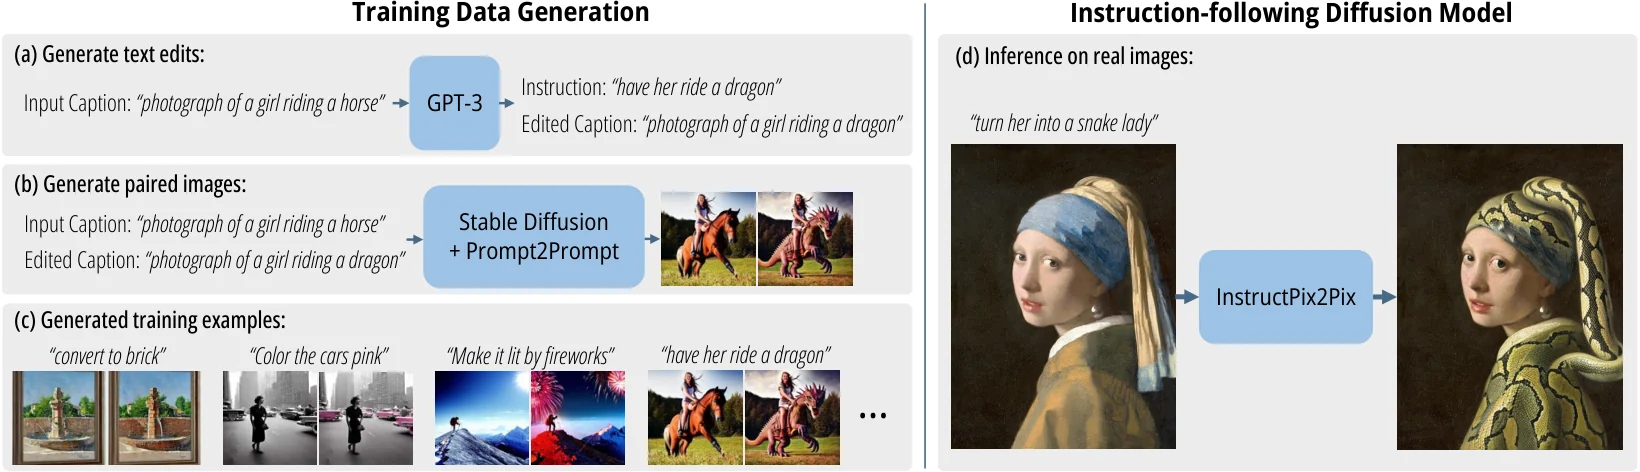
上图来自 InstructPix2Pix 原论文。左侧是训练数据的三步构造:用语言模型改写标题得到文本编辑指令,再用 P2P 与 Stable Diffusion 把指令做成成对图像;右侧是推理时把真实图像与指令一起送进微调后的模型。整条训练流程的关键在于”用编辑方法生产编辑数据”——反演在这里只出现在数据生产阶段,不出现在推理阶段。
图像条件与交叉注意力的分工
训练式编辑模型之所以能绕开反演,核心是在架构里引入了”图像条件”这一路输入。常见做法有两类:
- 参考图作为额外序列:把原图编码成 token 序列,拼到目标序列前面,用自注意力让两者交互。FLUX.1 Kontext、OmniGen、Step1X-Edit 都属于这一类”上下文生成”(in-context generation)思路——编辑就是”给定图与指令,续写出结果”。
- 独立编码器 + 交叉注意力:用 CLIP 类编码器把原图压成语义向量,通过交叉注意力注入主干。这种做法信息量有限,通常只能保留语义而不保留像素结构。
第一类保真更强,但序列变长、注意力成本上升;第二类更轻,但结构一致性较弱。这个权衡是编辑模型规模化的核心工程问题之一。
绕开反演并不意味着反演无意义
训练式编辑解决的是”通用指令编辑”的端到端体验,但在以下场景反演仍然是基础:
- 需要像素级精确控制:例如只改指定区域、其他区域严格不变时,局部重绘(inpainting)配合反演或分区条件仍是最可控的做法;
- 要在已有工作流中插入一处修改:设计稿局部调整、人像修图,往往需要”其余部分完全保留”;
- 研究新的采样器或编辑算子:反演是理解采样可逆性的最直接实验台;
- 没有训练资源时:免训练方法仍然是低成本落地的首选。
局部重绘里最有代表性的是 RePaint(Lugmayr et al., CVPR 2022)。它的做法不是反演,而是重采样(resampling):每次按正常 DDPM 反向走一步得到 ,再把已知区域替换回”真图按前向过程加噪到 的值”,然后额外做几次反向—前向的往返,让未知区域在每一步都重新对齐已知区域的统计。
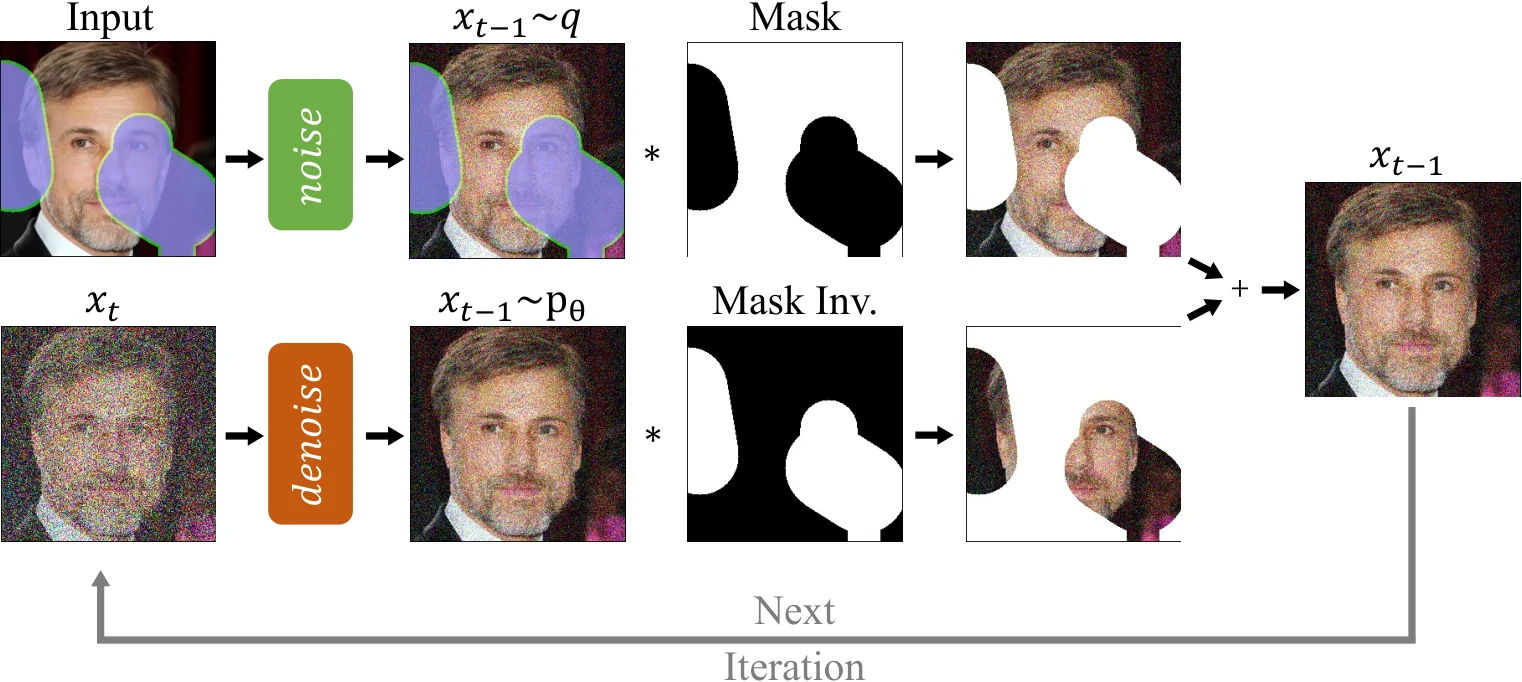
上图来自 RePaint 原论文。流程里 由模型生成, 表示用原始图像前向加噪得到的已知区域,两者相加后再进入下一步。右侧的往返箭头表示 resampling:为了让未知区域与已知区域的颜色与纹理接上,需要额外做几次”退一步、再走两步”的迭代。它要的前向次数是 ( 为 resampling 次数),比反演类方法的恒等重建更直观地控制”哪里必须保留”。
一条正在收窄的边界
免训练编辑与训练式编辑的边界正在收窄。训练式模型开始支持”参考图 + 局部区域”这类更精细的条件;免训练方法则在整流流、可逆求解器上继续推进。对推理系统来说,真正稳定的是那条”成本与保真随反演精度与步数增长”的曲线:任何声称”零成本精确编辑”的方案,都要问清楚它的精确性从哪来——是训练数据、是可逆求解器,还是只覆盖了很小的一类改动。
小结
本篇从”编辑比生成多了一个约束”出发,把扩散模型最基础的图像编辑机制拆成六层。
- 编辑要同时满足保真与真实感,原图像素与数据流形之间的张力决定了所有方法的结构。
- SDEdit 用”加噪到中间时刻再去噪”实现编辑, 是唯一旋钮,成本低但无法精确回到原图。
- DDIM 反演把采样器反过来跑,用源提示词反演出噪声、用目标提示词生成回来,保真上限更高,代价是 次前向。
- DDIM 反演误差是一阶的:噪声预测的取值点错位、轨迹曲率、CFG 放大非线性,三者叠加。恒等重建测试是判断反演质量最直接的方法。
- null-text 把误差吸收到可学习的空嵌入里,EDICT 用两个变量换精确可逆,二者都证明了”有代价的可逆”是可行的。
- 反演只回答”从哪出发”,交叉注意力的替换与缩放回答”改哪里”;注意力列的空间对应不总是可靠,掩码约束需要用软约束或重采样来避免接缝。
- 整流流时代反演不再天然可逆,需要可逆求解器或不动点修正;时间步移位让编辑强度的口径变得更复杂。
- 训练式编辑把反演负担前移到训练数据,推理时只需一次条件前向。但局部精确控制、已有工作流插入与免训练落地这三个场景,反演仍然是绕不开的基础。
这条线往下的延伸在站内另有几篇:第一篇的 DDPM 推导是本节所有反演式的来源,第六篇的采样器离散化解释了为什么步数与精度不成线性关系,第十二篇的连续时间 SDE 视角把反演写成概率流 ODE 的反向积分,第十三篇的引导机制解释了为什么 CFG 会放大反演误差;dLLM 推理系统一文的缓存与并行解码问题,可以看作把”编辑”的对象从图像换成了 token 序列之后要面对的同类约束。ControlNet 一类条件控制与视频扩散的编辑一致性,则是从”保结构”走向”保时序”的下一层问题。
参考资料
- Meng et al., SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations, ICLR 2022. arXiv:2108.01073
- Song et al., Denoising Diffusion Implicit Models, ICLR 2021. arXiv:2010.02502
- Hertz et al., Prompt-to-Prompt Image Editing with Cross Attention Control, ICLR 2023. arXiv:2208.01626
- Mokady et al., Null-text Inversion for Editing Real Images using Guided Diffusion Models, CVPR 2023. arXiv:2211.09794
- Wallace et al., EDICT: Exact Diffusion Inversion via Coupled Transformations, ICML 2023. arXiv:2211.12446
- Liu et al., Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow, ICLR 2023. arXiv:2209.03003
- Rout et al., Semantic Image Inversion and Editing using Rectified Stochastic Differential Equations, 2024. arXiv:2410.10792
- Brooks et al., InstructPix2Pix: Learning to Follow Image Editing Instructions, CVPR 2023. arXiv:2211.09800
- Lugmayr et al., RePaint: Inpainting using Denoising Diffusion Probabilistic Models, CVPR 2022. arXiv:2201.09865
- Wu et al., Step1X-Edit: A Practical Framework for General Image Editing, 2025. arXiv:2504.17761
- FLUX.1 Kontext 技术报告, Flow Matching for In-Context Image Generation and Editing in Latent Space, 2025. arXiv:2506.15742
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



