


系统级摩尔定律:未来五年集成电路技术发展趋势研判
问题的边界:衡量“先进”的尺子已经变了
讨论未来五年集成电路技术趋势,不能只问“2 nm 之后还有没有 1.4 nm”。这个问法默认集成电路是单一平面上的晶体管密度竞赛,而 2026 年的产业现实早已不是这个样子:先进逻辑继续缩小,存储带宽成为 AI 系统的中心约束,先进封装从配套工艺上升为系统架构本身,EDA 从画版图的工具转向多物理场系统优化平台,制造环节则同时被设备、材料、良率、能耗、地缘安全和资本开支约束。
更合适的判断框架是把传统的 PPAC(performance、power、area、cost)扩展为系统级 PPAC:四个指标不再只在单个 die 内闭合,而是在晶体管、片上互连、背面供电、HBM、硅中介层、chiplet、封装基板、散热、软件栈与供应链之间共同闭合。
链条的两端都在给出信号。需求侧,WSTS 在 2026 年 6 月的春季预测中把 2026 年全球半导体市场规模大幅上调到 1.51 万亿美元,同比增长约 90%,其中存储约 8,039 亿美元、逻辑约 4,114 亿美元,并预计 2027 年进一步增长到 1.91 万亿美元——这是半导体历史上第一次出现万亿美元量级的年度市场。供给侧,SEMI 在 2026 年 9 月发布的 WWSEMS 数据显示,2026 年第二季度全球半导体设备销售额达到 405.3 亿美元,同比增长 23%、环比增长 11%,连续第二个季度刷新历史纪录,且增量集中在先进逻辑、先进封装、存储与量测环节。
需要给这两个数字加上限定条件:它们衡量的是市场规模,不是技术能力,而且预测口径本身波动极大——同一机构在 2025 年秋季给出的 2026 年预测仅为 9,750 亿美元。真正值得注意的不是曲线的高度,而是曲线的形状:增长的绝大部分来自 AI 基础设施对算力、存储和互连的拉动,而不是手机、PC 等传统终端的需求复苏。这意味着未来五年的技术选择不会只由实验室可行性决定,还会被资本开支节奏、存储周期和区域供应链政策共同塑形。
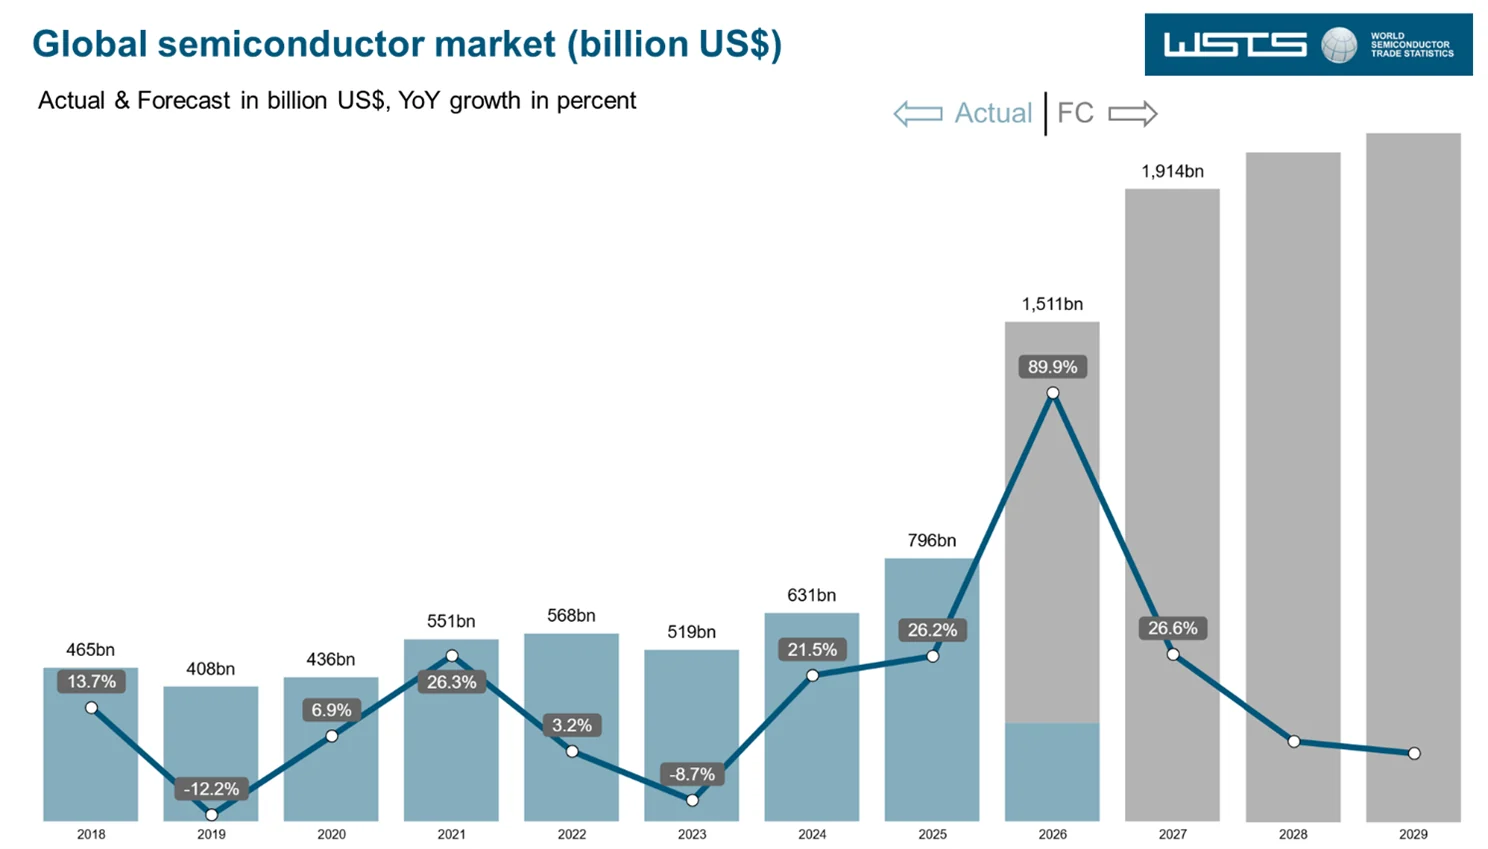
图源:WSTS 2026 年 6 月春季预测新闻稿配图。WSTS 将 2026 年增速上调至约 90%,并预计 2027 年达到 1.91 万亿美元。曲线陡峭的主因是存储与 AI 相关逻辑器件的需求重估,而不是消费电子的全面复苏;这类预测在周期转折点上经常被大幅修正,更稳妥的读法是把它当作“AI 正在吃掉增量资本”的证据,而不是精确的路线图。
本文的核心判断是:2026-2031 年集成电路技术将从传统的“器件几何微缩”进入系统级摩尔定律阶段。它不是摩尔定律消失,而是有效算力的提升——按单位成本、单位能耗、单位封装体积、单位系统复杂度衡量——将由器件、互连、封装、存储、EDA、软件和制造组织共同决定。如果把未来五年的进展画成一张图,它更像多条并行推进且互相牵引的技术栈,而不是一条单轴曲线。
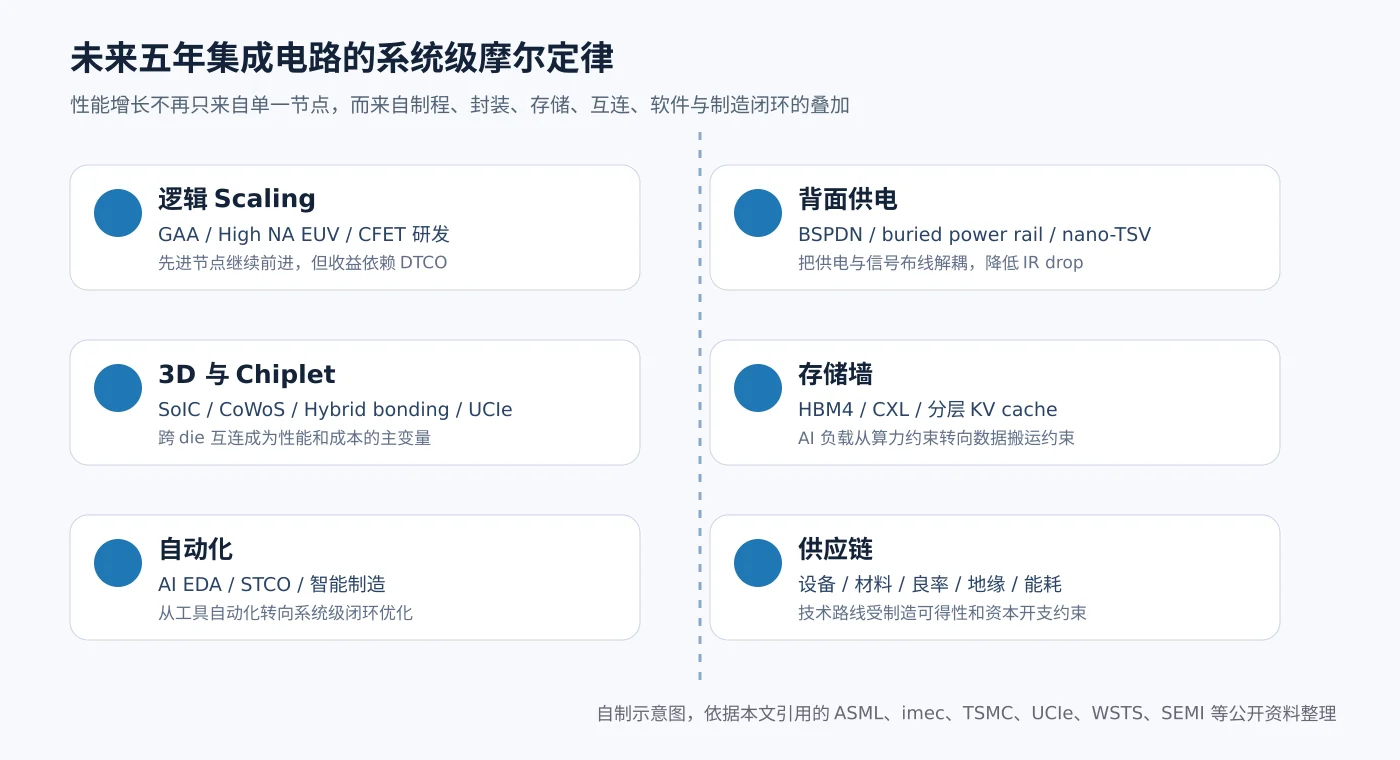
图源:本站自制示意图,依据本文引用的 ASML、imec、TSMC、UCIe、Micron、WSTS 与 SEMI 等公开资料整理。图中的六个方向并非并列清单,而是互相牵制:先进节点决定计算密度上限,背面供电决定这些晶体管能否被喂饱电,3D 封装决定系统能堆多大,存储与互连决定数据搬运成本,自动化与供应链决定上述方案能否被设计出来并量产出来。任何一项落后,都可能抵消其他环节的进步。
具体而言,2026-2031 年集成电路技术会沿着七条主线同时推进。
第一条是几何 scaling 的延续与变形:收益来源从“单纯缩短栅长”转向 GAA、CFET、背面供电、低电阻互连和计算光刻共同支撑的综合密度提升,器件结构本身开始进入三维化。
第二条是 3D 堆叠与先进封装成为性能 scaling 的主战场:在 AI 加速器与高带宽存储系统中,chiplet 化、多 die 集成、混合键合与高密度互连会替代大单片 die 的一部分角色。
第三条是存储与互连从外围约束变成体系结构的第一变量:HBM4、近存计算、CXL、光互连和 co-packaged optics 的进展会直接决定芯片形态,而不再只是配套选项。
第四条是 AI 同时改造芯片的需求侧与设计制造侧:一方面 AI 负载要求更高带宽、更高能效、更低延迟;另一方面 EDA、DTCO、STCO、工艺控制、缺陷检测和 fab 调度会越来越多地引入机器学习与生成式方法。
第五条是先进制程不再独立决定产品竞争力:制程、封装、架构、软件、编译器、散热和供电必须联合设计,系统技术协同优化成为核心能力。
第六条是自动化从设计自动化扩展到制造、封装与测试自动化:芯片复杂度继续上升,但人力、验证和良率不能按同样速度增长,工具链必须承担更多工程决策。
第七条是技术路线明显分层:最先进 AI/HPC 芯片追求最密集的逻辑和封装;汽车、工业、功率、射频和传感器更重视成熟节点、可靠性、长期供货和异构集成。“先进”不再只有一个方向。
需求侧:AI 如何改写芯片设计的目标函数
AI 对集成电路的影响不能只理解为 GPU 出货增长。更本质的变化是,AI 负载改写了芯片设计的目标函数。
传统高性能数字芯片大多围绕峰值算力、通用吞吐、缓存层次和软件生态展开。大模型推理把问题改写为:在给定功耗、封装面积、HBM 容量、互连带宽和服务延迟约束下,如何以最低成本完成尽可能多的 token、图像、视频、机器人轨迹或检索任务。在这个目标函数里,“算力”不再是唯一稀缺资源——内存带宽、KV cache 容量、跨 GPU 通信、集群网络、供电、散热和封装良率常常才是真正的瓶颈。站内关于长上下文推理内存墙的讨论可参考 HotChip/FMS 内存墙(一):HBM scaling、3D-DRAM、PIM 与 CXL-PNM,它解释了为什么推理芯片不能只堆峰值 TFLOPS。
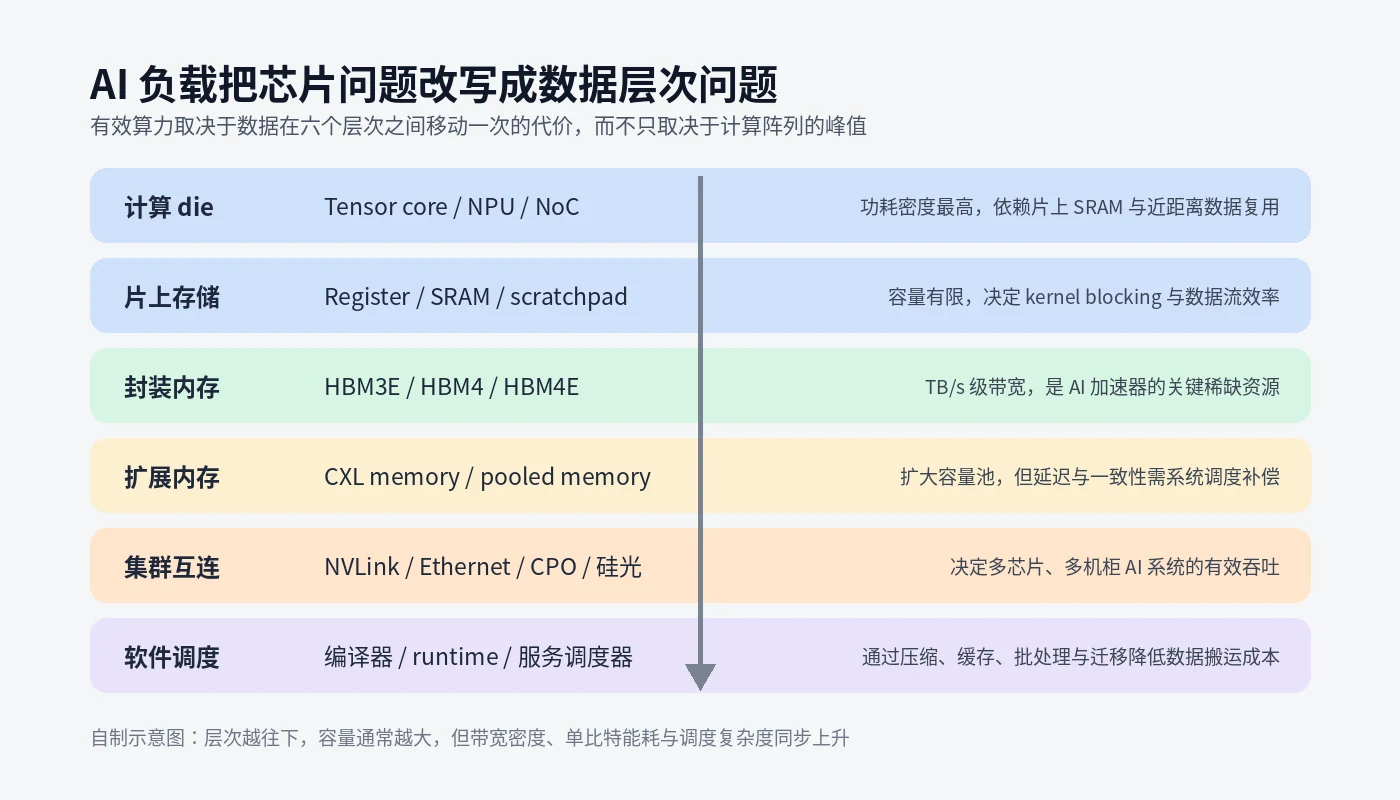
图源:本站自制示意图。计算 die 内部的 SRAM、封装内的 HBM、CXL 扩展内存、机柜互连和服务调度共同决定单位 token 成本。层次越往下容量越大,但带宽密度、单比特能耗与调度复杂度同步上升,因此“把数据放在哪一层、以什么代价搬运”本身就是架构决策,而不是实现细节。
先进逻辑的需求来自这张图的顶部。 矩阵乘、注意力、MoE、视频生成、机器人策略网络和科学计算都要求更高能效的计算阵列。先进节点能带来更高晶体管密度和更低开关能耗,但收益已经远不如 Dennard scaling 时代那样线性:电压不能持续等比例下降,互连 RC 延迟和漏电功耗占比上升,SRAM 缩放明显慢于逻辑,而片上数据搬运的能耗常常超过算术运算本身。未来五年先进逻辑的价值,不在于把更多晶体管塞进同一面积,而在于为更复杂的张量核、片上网络、缓存、压缩/解压单元、低精度算术和安全隔离提供设计空间。
高带宽存储的需求来自这张图的中间两层。 Micron 的 HBM4 页面显示,其 HBM4 采用 2048-pin bus,速率超过 11.0 Gbps,单栈带宽超过 2.8 TB/s,并明确面向长上下文、多模态、AI agent 和 HPC 场景。这个数字的含义很直接:单个封装内的内存系统已经进入 TB/s 量级,芯片性能越来越受限于封装里能放多少 HBM、HBM 与逻辑 die 之间能以多低的能耗传输数据、系统能否把热量和电流稳定送走。HBM 不再只是“显存”,而是 AI 加速器架构的组成部分。
先进封装的需求则来自整张图的代价结构。 大模型加速器往往需要多个计算 die、多组 HBM、I/O die、SerDes,甚至封装内光学接口。单片 reticle 限制、良率成本和设计复用需求共同推动 chiplet 化:一个大 die 面积越大,随机缺陷造成的良率损失越严重;拆成多个 chiplet 后,不同功能模块可以用不同节点制造,IP 复用也更灵活。但 chiplet 并不免费,它把问题转移到 die-to-die 带宽、延迟、一致性协议、封装热应力、测试覆盖率和供应链协同上。因此 AI 芯片的竞争,本质上是“架构 + 制程 + 封装 + 存储 + 软件”的系统竞争。
AI 还反向改造了芯片的设计与制造过程。SEMI 对 EDA 增长与 AI 影响的访谈中提到,EDA、半导体 IP 和服务收入已经连续多年增长,AI 功能正在从独立产品逐步嵌入传统 EDA 工具。技术逻辑并不复杂:先进芯片的状态空间已经超出纯人工调参能力。布局布线、时序收敛、功耗优化、版图热点修复、验证覆盖、良率预测、缺陷分类、设备维护和 fab 调度,都可以被看成高维约束优化问题。机器学习未必替代工程师,但会改变工程师处理问题的粒度——从手工移动局部单元,转向定义约束、审查候选方案、验证模型建议、处理跨域 trade-off。
产品定义方式也随之变化。过去芯片以规格表作为交付中心:核心数、频率、缓存、接口、功耗、面积、封装尺寸。AI 时代的旗舰芯片更像系统部件,它必须同时回答训练集群规模、推理服务延迟、token 成本、HBM 供给、机柜功耗、液冷条件、软件栈成熟度、模型并行策略和供应链可复制性。评价函数于是从局部 PPA 变成系统 TCO:一个方案即使在单 die 上更优,若导致封装面积过大、HBM 配比失衡、网络通信过重或良率不可控,也可能不是最优产品。
这种牵引还会继续分化。通用 GPU 与 AI 加速器服务最大规模模型,边缘 AI、汽车、机器人、可穿戴和工业控制则需要更低功耗、更低成本、更高可靠性的专用芯片;前者强调 HBM、先进节点和高速互连,后者强调嵌入式 NVM、模拟/混合信号、传感融合、低功耗 always-on 计算和功能安全。具身智能是后一条路线最典型的场景,站内 具身智能完全入门:从会聊天的 AI 到会干活的机器人 从机器人侧描述了这类芯片的真实约束。未来五年,“AI 芯片”不是单一品类,而是一组由应用约束定义的芯片族。
经济性:继续缩小不再自动等于继续变好
摩尔定律的原始表述是单位面积上的晶体管数量定期翻倍,但产业真正依赖的是它的推论:每一代新工艺都会让单位晶体管的成本下降。这个推论在过去十年逐渐失效,而它失效的方式,直接决定了未来五年技术路线的形状。
第一条证据来自成本模型。分析师 Ben Bajarin 在 2026 年 4 月发布的前端成本模型显示,制造十亿个晶体管所需的成本从 N5 时代的约 5.4 美元上升到 A16 时代的约 11 美元;同一模型给出的资本强度也从 N5 时代每 5 万片/月产能约 160 亿美元投入,上升到 N2/A16 时代的 280-300 亿美元。先进产能的入场费几乎翻倍,而产出效率没有同步提升——这正是“每晶体管成本不再下降”在财务上的具体形态。
第二条证据来自晶圆报价。按多数分析师估计,N5 晶圆约 1.5-1.6 万美元一片,N3 约 1.8-2 万美元;据韩国媒体转述并经 TrendForce 转载,N2 报价约 3 万美元,比 N3 高出约 50%。最后这一档数字需要谨慎对待:TSMC 从未确认任何报价,其管理层还公开否认过因缺货大幅涨价,另有一些分析师给出的 N2 涨幅估计只有 20-25%。口径分歧本身就是结论的一部分——先进节点的定价高到让外界持续争论“值不值”,这在 28 nm 时代是不可想象的。
成本上升的另一面是设计门槛。IBS 的估计显示,一颗复杂 SoC 的设计成本从 28 nm 时代的约 4,800 万美元,升到 5 nm 的 4.49 亿美元、3 nm 的 5.81 亿美元、2 nm 的 7.25 亿美元,其中验证占四成以上(这一口径被部分机构认为偏高,但趋势方向分歧不大)。当一次流片的代价逼近十亿美元量级,能进入最先进节点的客户就只剩少数几家超大厂商——TSMC 的先进产能被报道已排到 2028 年,NVIDIA 的首代 Rubin 甚至据报留在 N3P 而非直接跳到 N2。
把这些数字放在一起,就能理解产业为什么不再把几何微缩当作唯一的进步路径:如果单位晶体管成本不再下降,那么继续缩小晶体管的意义就必须由别的东西兑现——更高的能效、更大的封装、更近的存储、更低的通信开销、更好的系统协同。这正是系统级摩尔定律的成因。
需要补充一个反向限定:放缓的是单位晶体管的制造成本,不是系统的性价比。Epoch AI 的统计显示,按 AI 芯片采购价格折算的每美元性能仍以年均约 49% 的速度增长。原因在于,性能提升的很大一部分来自架构、封装、存储层次和软件,而不再只来自晶体管本身。
逻辑 scaling:从栅长微缩到器件三维化
先进逻辑 scaling 仍然存在,但“继续 scaling”已经不等于“继续把栅长缩小”。光刻、晶体管结构、互连、供电和系统封装必须一起演进。
光刻分辨率的基本关系由 ASML 解释的 Rayleigh 判据给出:
其中, 是 critical dimension(关键尺寸),即能印刷的最小特征尺寸; 是曝光光源波长; 是光学系统数值孔径; 是与工艺、掩模、照明、光刻胶和计算光刻相关的综合系数。要缩小 ,可以减小波长、增大数值孔径,或把 压到更接近物理极限。EUV 已经把波长推进到 13.5 nm,High NA EUV 则把 NA 从 0.33 提升到 0.55,ASML 的 EXE 平台据此给出 8 nm 分辨率,并支持从 2 nm 级逻辑向后续节点导入。
这个公式同时说明了光刻 scaling 为什么越来越贵。压低 依赖计算光刻、多重图形化、OPC、严格 overlay 控制和更复杂的工艺窗口;提高 NA 会带来景深下降、半场曝光、掩模和设备复杂度上升;再加上 EUV 光源、反射镜、真空系统、光刻胶随机缺陷和量测工具,成本层层叠加。2026 年的产业状态也印证了这种复杂性:Intel 宣布 High NA 已在 18A 的部分层与部分 Panther Lake 产品上进入高量产,同时 ASML 预期 High NA 要到 2027-2028 年才会广泛放量,TSMC 明确表示至少到 2029 年的 A14 节点不需要 High NA,Samsung 的 High NA 机台仍主要服务研发线。也就是说,High NA 会推动先进节点继续前进,但产业没有回到“换一代光刻机就自然获得巨大收益”的时代。
图源:ASML。High NA EUV 是未来五年先进逻辑 scaling 的关键设备之一,却不是节点进展的唯一决定因素。它需要与光刻胶、掩模、计算光刻、量测、overlay 控制和工艺集成共同工作,而 0.55 NA 带来的半场曝光限制还会反过来约束版图与拼接方案的设计自由度。
晶体管结构方面,FinFET 已经难以继续提供足够的静电控制,GAA nanosheet 正在成为 2 nm 级节点的主流方向。GAA 的优势在于栅极从多个方向包围沟道,提高短沟道控制能力,并允许通过 nanosheet 宽度调节驱动电流。Intel 18A 公开材料把 RibbonFET 描述为 gate-all-around 架构,并与 PowerVia 背面供电并列作为该节点的标志性技术。TSMC、Samsung 和 Intel 的命名不同,方向却一致:在 FinFET 之后,晶体管必须通过更强的栅控和更灵活的沟道几何维持性能与漏电的平衡。
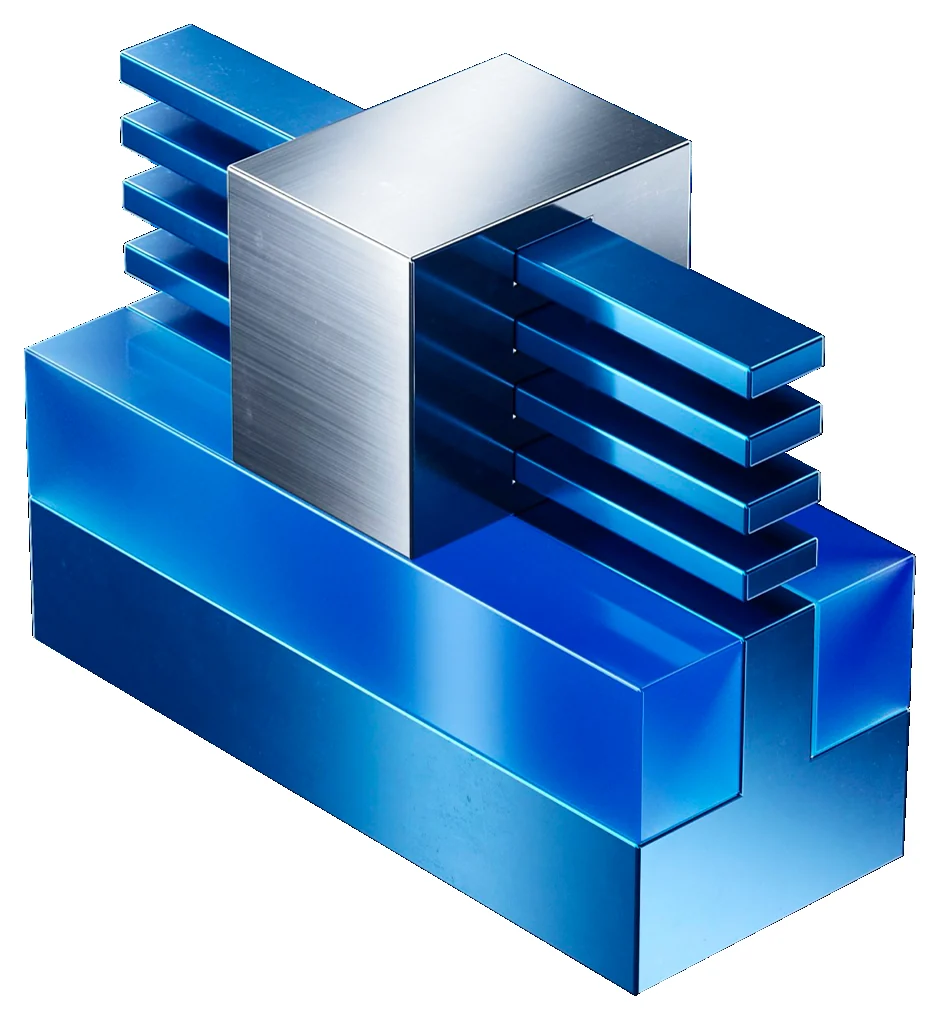
图源:Intel 官方渲染图。RibbonFET 用多层堆叠的纳米片(ribbon)作为沟道,栅极从四周包围,因此沟道宽度可以按层数和片宽调节,而不像 FinFET 那样受鳍高与鳍距的固定比例约束。这种“宽度可调”的特性对 AI 芯片尤其重要:不同计算单元对驱动电流与漏电的偏好并不相同,器件层的可调维度越多,DTCO 的优化空间越大。
继续往后,imec 的路线图把 forksheet 与 CFET 视为维持标准单元面积缩放的候选。从器件剖面可以看到,这实际上是一条标准单元高度(cell height)不断压缩的路径:finFET 时代标准单元高度超过 150 nm,nanosheet 降到 132-115 nm,forksheet 约 90 nm,CFET 则压到 70 nm 以下。
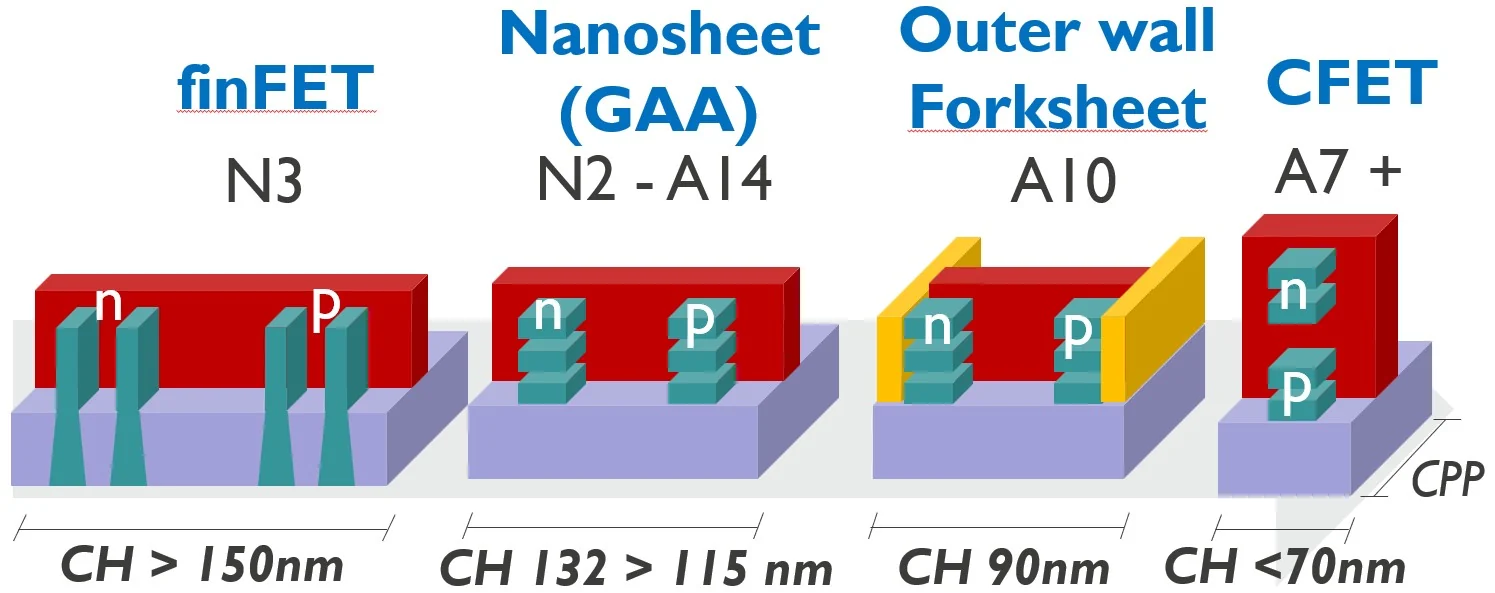
图源:imec。图中标注的 CH 为标准单元高度,CPP 为接触栅间距。器件演进的实质是让 nFET 与 pFET 的排布方式不断让出面积:finFET 并排、nanosheet 并排、forksheet 用介质墙隔开、CFET 直接把两者垂直堆叠。每一次结构变化都以更复杂的工艺换更小的单元面积。
CFET 的基本思想是把 nFET 与 pFET 垂直堆叠,而不是并排放置,从而把互补晶体管从二维平面布局推进到三维器件结构。imec 给出的剖面方案里,从 A14 节点的 5T nanosheet、A7 节点的 5T forksheet,到单片 CFET 与顺序集成 CFET 的多个版本,沟道间距、接触方案与电源轨位置都在持续压缩。
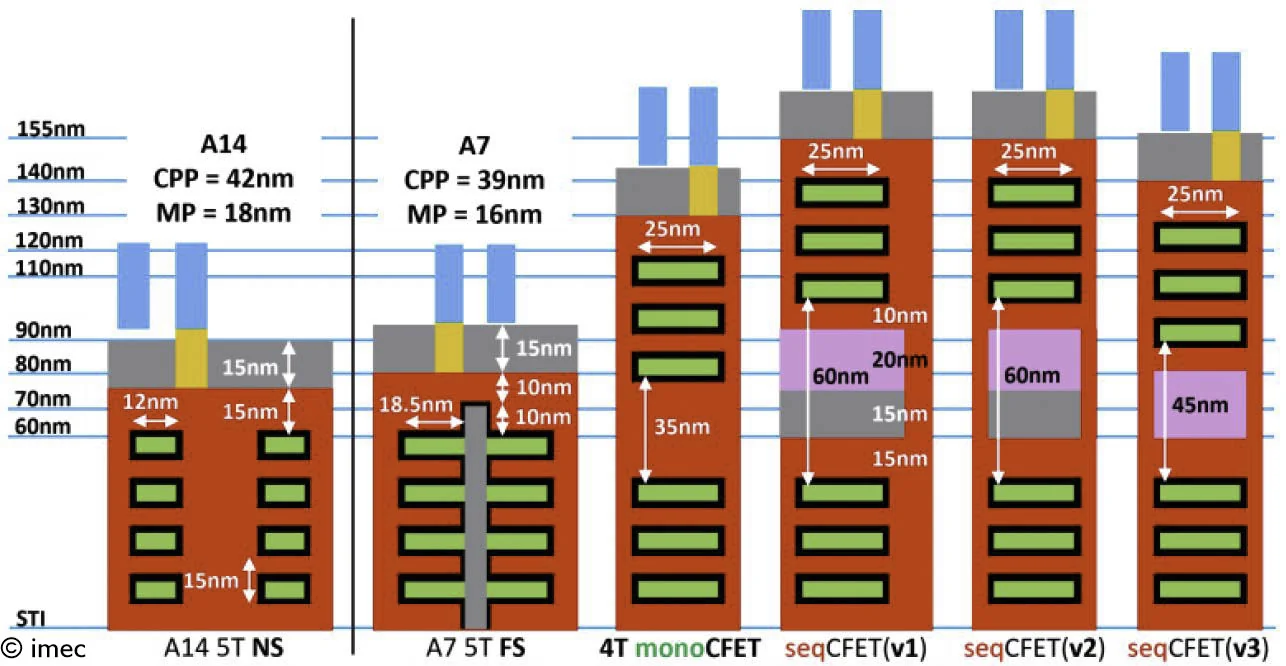
图源:imec。剖面依次为 A14 5T nanosheet、A7 5T forksheet、4T 单片 CFET 以及三个版本的顺序集成 CFET,图中数字为关键尺寸(单位 nm)。越往右侧,上下器件的间距、接触占位和电源轨方案越激进,工艺顺序与热预算的约束也越严格。
但 CFET 的集成难度极高:上下器件的材料、热预算、接触电阻、寄生电容、工艺顺序和良率都会变得更难控制。imec 自己的路线图把 CFET 排到 A7 之后的世代,产业界普遍预期其大规模商业化要等到 2031 年之后;IRDS 等路线图的口径同样把 CFET 视为下一个十年的选项,而不是本个五年的量产技术。它在本个五年的战略意义,是明确告诉产业:长期 scaling 已经必须进入器件三维化,而三维化的代价会以工艺复杂度和良率的形式体现出来。
三维化之外,长期路线图还保留着几条备选出口。二维沟道材料是其中之一:过渡金属硫化物等二维半导体可以在极薄沟道下维持迁移率与栅控,从而绕开硅沟道继续减薄时的短沟道问题,imec 已把二维材料器件纳入其逻辑缩放路线图的评估范围。单片 3D 逻辑(monolithic 3D)是另一条:它在垂直方向上重复利用已经成熟的器件层,用层间互连而非更小的晶体管换取密度。这些方向的共同点是仍处于材料与集成工艺的基础研究阶段,未来五年不会进入量产,但会被持续投入——它们代表的是几何微缩走到尽头之后的备用出口,而不是可以随时启用的替代方案。
互连是这条路径上的另一个硬约束。晶体管缩小后,局部互连线宽变窄,电阻上升,电容与串扰问题更突出,芯片延迟越来越多地由线而不是门决定——逻辑门可以继续变小,但信号和电源必须穿过越来越拥挤的金属层。这个关系可以用一个简化式子表示:
其中, 是互连延迟, 是金属线电阻, 是互连电容。线宽缩小会推高 ,线距缩小会增加耦合电容与串扰风险,二者相乘意味着互连延迟的恶化速度远快于器件延迟的改善速度。低电阻金属、新 barrier/liner 材料、air gap、semi-damascene、背面供电和 3D 互连因此都会成为 scaling 的组成部分,先进节点的竞争也从晶体管单点竞争变成器件、互连、供电、版图和封装的联合竞争。
背面供电:把电源网络搬到硅片背面
背面供电网络(backside power delivery network,BSPDN)是未来五年最确定的结构性变化之一。它的价值来自一个朴素事实:传统芯片正面同时承载信号布线和电源布线,而在先进节点下二者都越来越拥挤。电源网络需要宽而低阻的金属降低 IR drop,信号网络需要密而复杂的布线连接逻辑单元,两者争夺同一批金属层,造成面积浪费、压降、噪声和时序问题。
背面供电的思路是把电源配送从正面 BEOL 中移出,通过晶圆背面金属、buried power rail(BPR,埋入式电源轨)和 nano-TSV 把电源送到标准单元附近。imec 的解释指出,背面供电让电源网络与信号网络解耦,可以用更宽、更低阻的背面金属直接送电,缩短电流穿越复杂 BEOL 的路径。其与 Arm 的合作研究给出的量化结果是:BPR 加传统正面供电可把 IR drop 降低约 1.7 倍,而 BPR 加背面供电可降低 7 倍;在 memory-on-logic 的 3D-SOC 分区设计中,背面供电让底层 die 的平均与峰值 IR drop 分别降低 81% 和 77%。
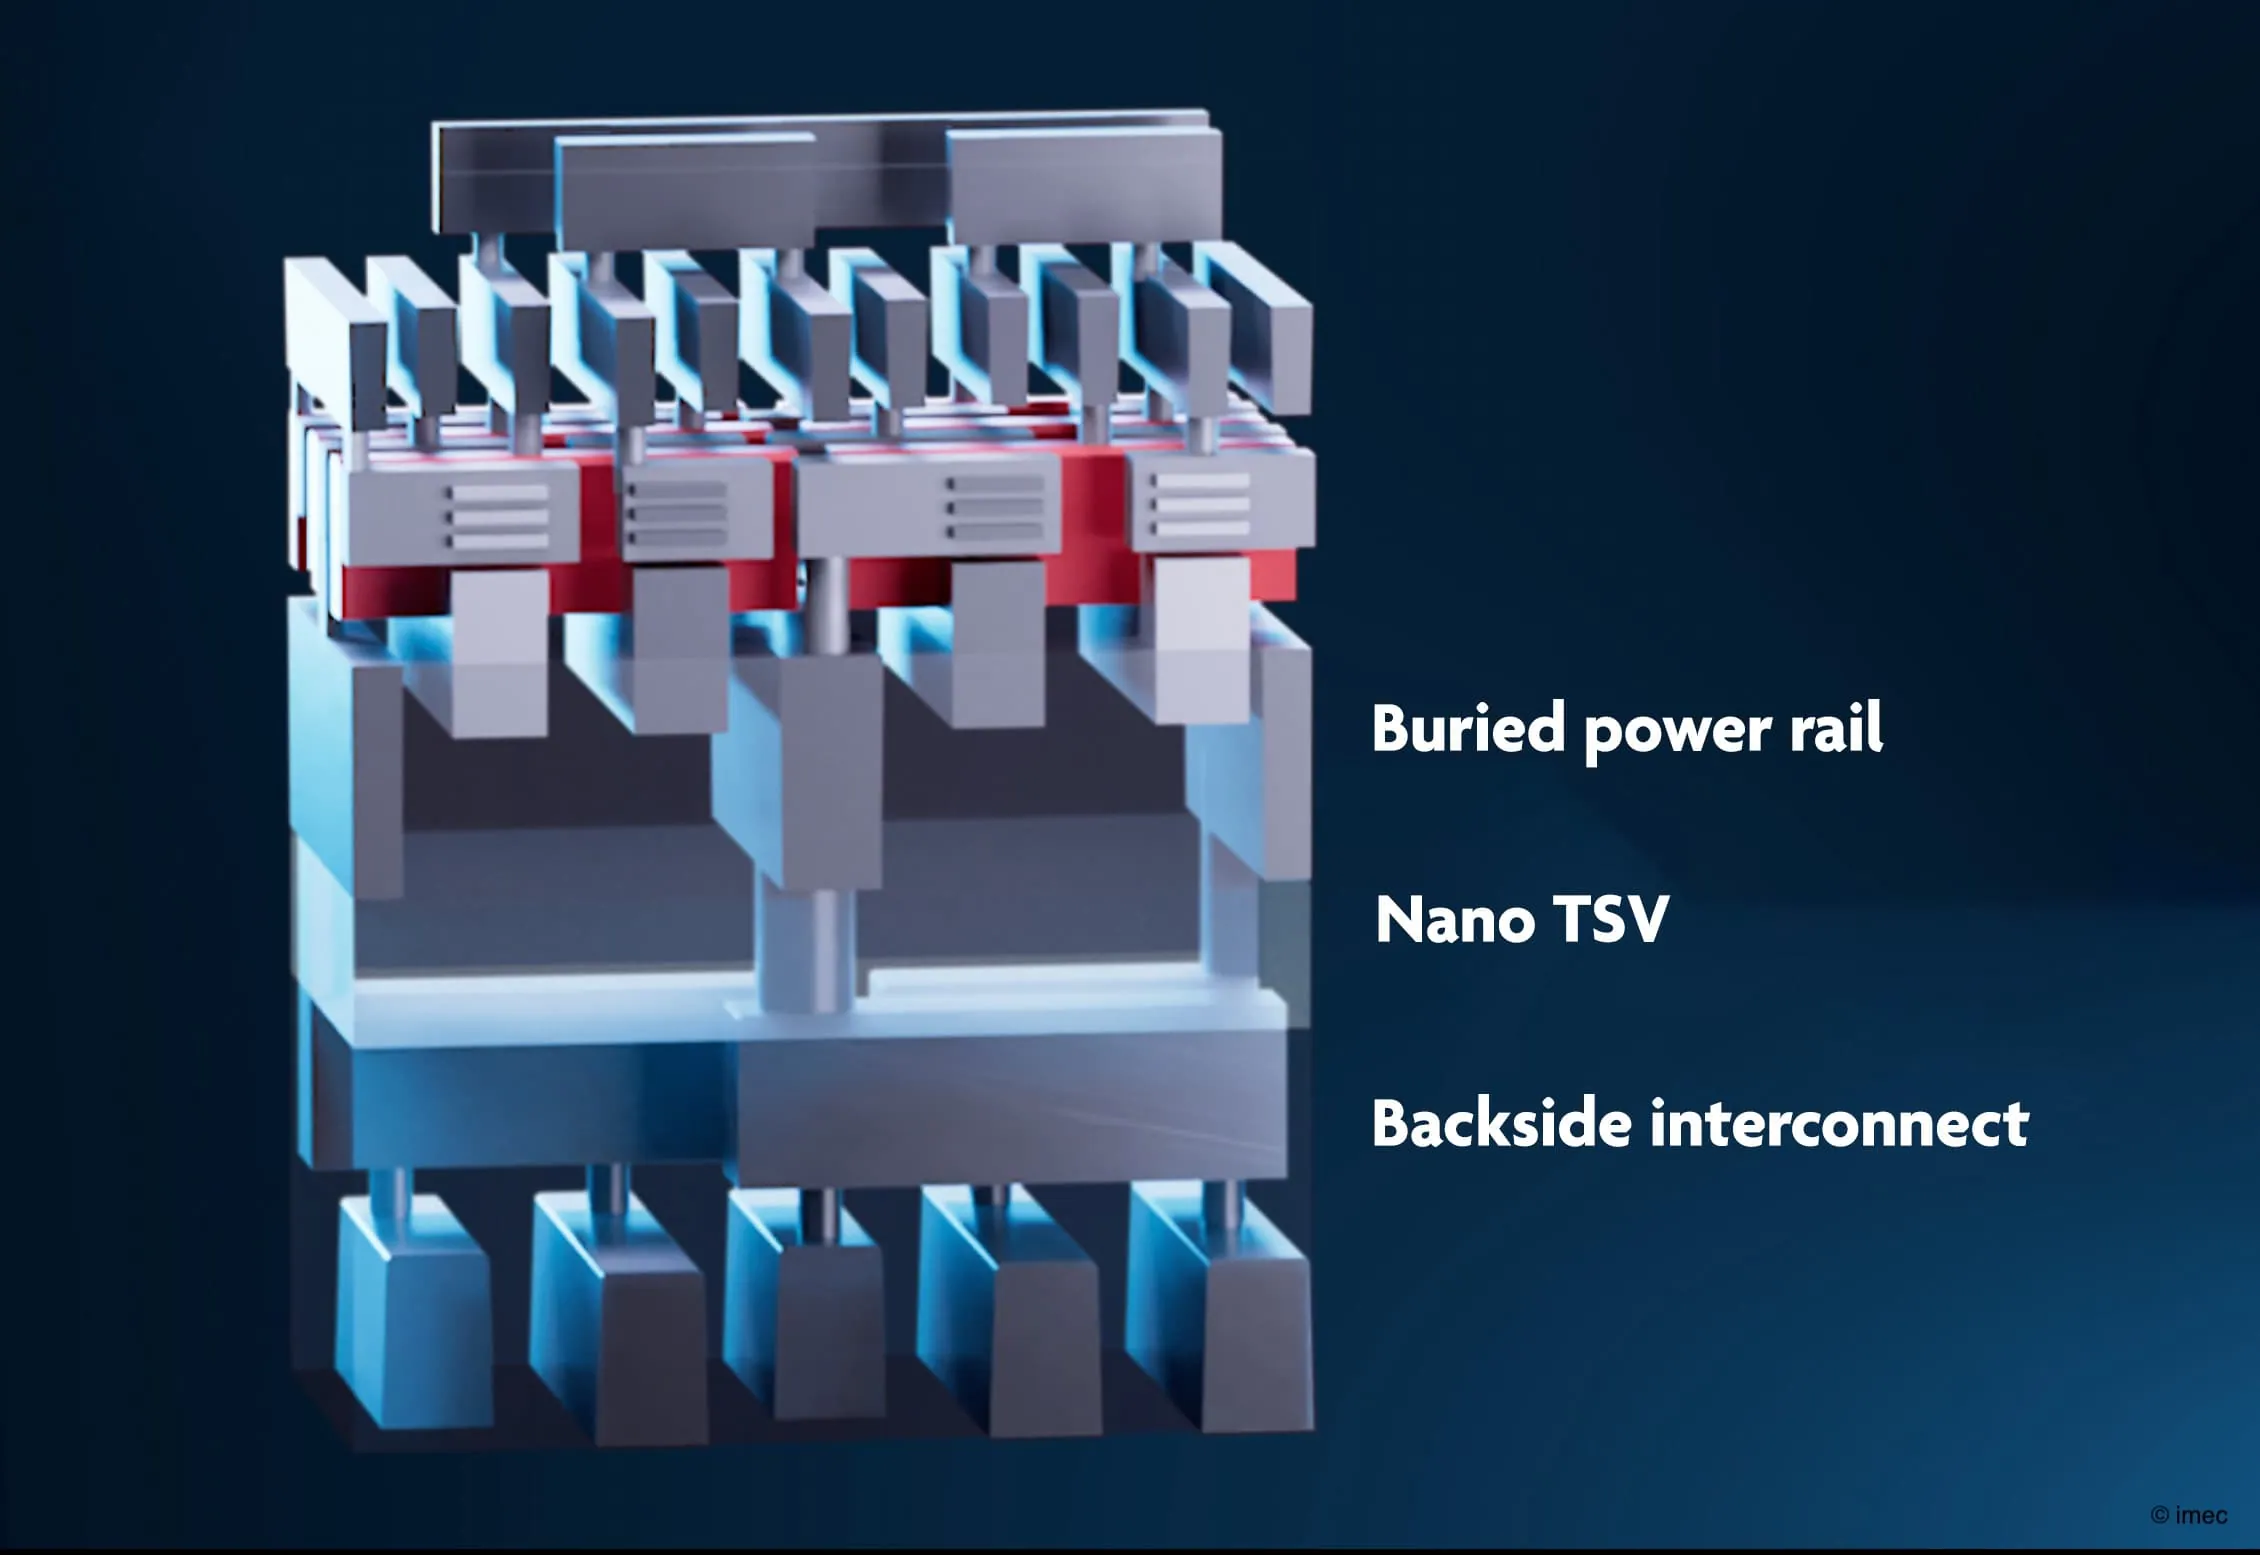
图源:imec。图中 buried power rail、nano TSV 和 backside interconnect 共同构成从晶圆背面向前端器件送电的路径。电源从背面直接抵达器件层,正面金属层则可以全部让给信号布线。
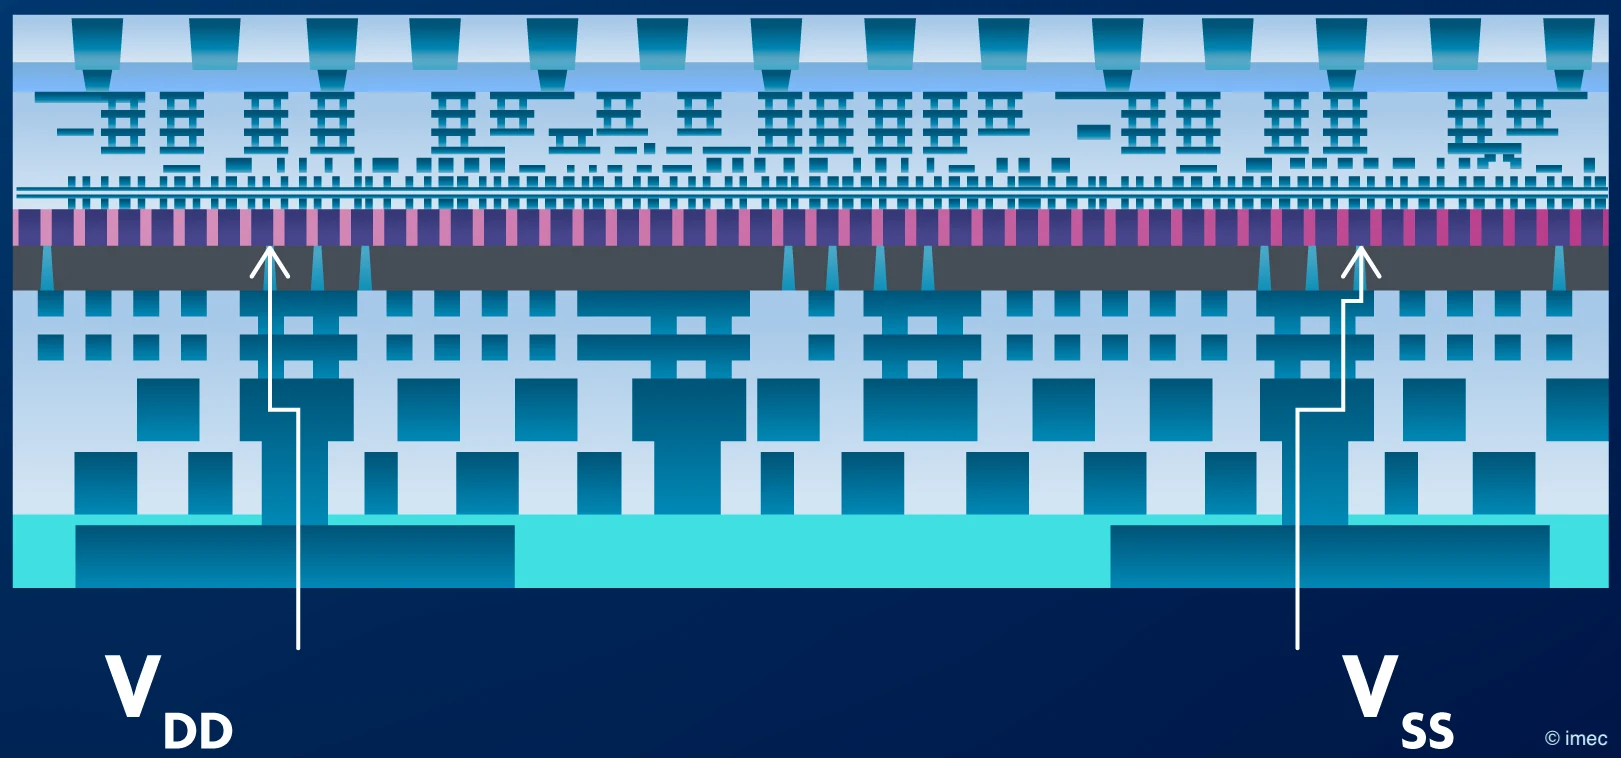
图源:imec。横截面视角下,正面上方是密集的 BEOL 信号布线,背面则由 VDD/VSS 电源网络经 nano-TSV 上行供电。这种“正面走信号、背面走电源”的分工是背面供电最直观的价值:两类网络不再抢同一层金属。
具体收益可以拆成三层。
第一层是电气收益。 IR drop 降低意味着晶体管实际获得的电源电压更稳定,同等目标频率下可以放宽电压裕量,或者在相同电压下提升性能;电源网络移到背面后,正面金属释放给信号布线,缓解 routing congestion。这对高频 CPU、AI 加速器控制逻辑、NoC 和 SRAM 周边电路都有直接意义。
第二层是面积收益。 标准单元高度是先进节点的关键指标之一,电源轨占据的正面资源越多,单元高度越难下降。背面供电配合埋入式电源轨,有机会把标准单元推向更少的轨道数,从而提高逻辑密度。但面积收益不是自动获得的:nano-TSV、背面工艺、对准精度和新的设计规则都会引入限制,实际收益取决于 PDK 与标准单元库的成熟度。
第三层是 3D 系统收益。 当逻辑与 SRAM、逻辑与存储、逻辑与 I/O 进入三维堆叠后,正反两面都可能承载功能,背面不再是“空白承载面”,而是电源、I/O、去耦电容、信号通路甚至局部器件的潜在承载层。下面这张 3D-SOC 示意图把这种关系画得很清楚:SRAM、Logic、BS-PDN 与 I/O 构成垂直系统,供电网络本身成为堆叠结构的一部分。
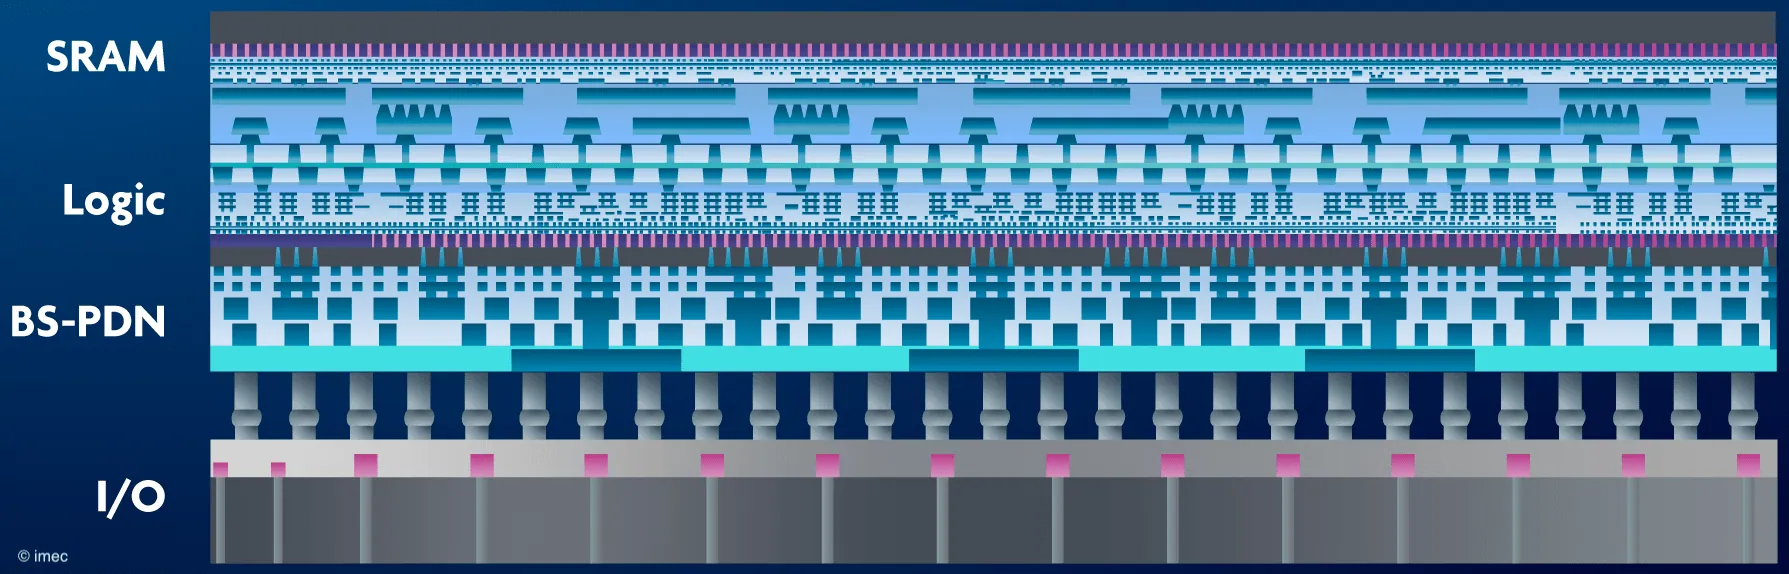
图源:imec。3D-SOC 中逻辑、存储、供电与 I/O 的边界不再由单一平面定义。背面供电在这里不只是供电方案,而是把“哪一面承担什么功能”变成一项架构选择。
产业时间表在 2026 年已经相对清晰。Intel 是最先量产的厂商,18A 节点与 PowerVia 随 Panther Lake 进入量产;TSMC 的 A16 节点采用 Super Power Rail 方案,目标在 2026 年第四季度量产;Samsung 的 SF2/SF2P 不带背面供电,BSPDN 被排在 2027 年的 SF2Z,其 SF1.4 节点时间表则从 2027 年推迟到 2029 年。三代厂商的节奏差说明一件事:背面供电不是一次普通的工艺模块升级,而是决定节点竞争力排序的结构性能力。
代价同样明确。背面供电要求晶圆减薄、背面对准、nano-TSV 制作、热预算控制、可靠性验证和 EDA 支持,设计工具必须理解正面信号网络与背面电源网络的耦合,时序、功耗、热和机械应力分析都要更新。换言之,它不是单个工艺模块,而是从 PDK 到标准单元库、从版图到封装都要配合的一次体系变更——这也是先量产者能拿到差异化窗口的原因。
先进封装:从“封装芯片”到“封装即系统”
先进封装在未来五年会从制造后段配套能力,转变为系统架构创新的中心。原因很直接:单片 die 的 scaling 同时受到 reticle 尺寸、良率、成本、功耗密度和设计周期限制,而 AI/HPC 系统又需要更多计算单元、更大内存、更宽 I/O 和更复杂互连。把所有功能放在一个 die 上并不总是最优,chiplet 与 3D 集成提供了更灵活的分解方式。
TSMC 3DFabric 把其先进封装体系分为前端与后端两类技术:前端是 TSMC-SoIC,负责晶圆级 3D 堆叠;后端包括 CoWoS 与 InFO,其中 CoWoS 是高性能 2.5D 集成的主力形态,常用于把逻辑 die 与多颗 HBM 放在硅中介层或 RDL 中介层上,InFO 更适合扇出型封装与移动场景。Intel、Samsung、ASE、Amkor、SK hynix、Micron 等厂商也都在强化异构集成能力。封装不再是把芯片接到 PCB 的外壳,而是决定带宽、延迟、功耗、良率和成本的系统平台。
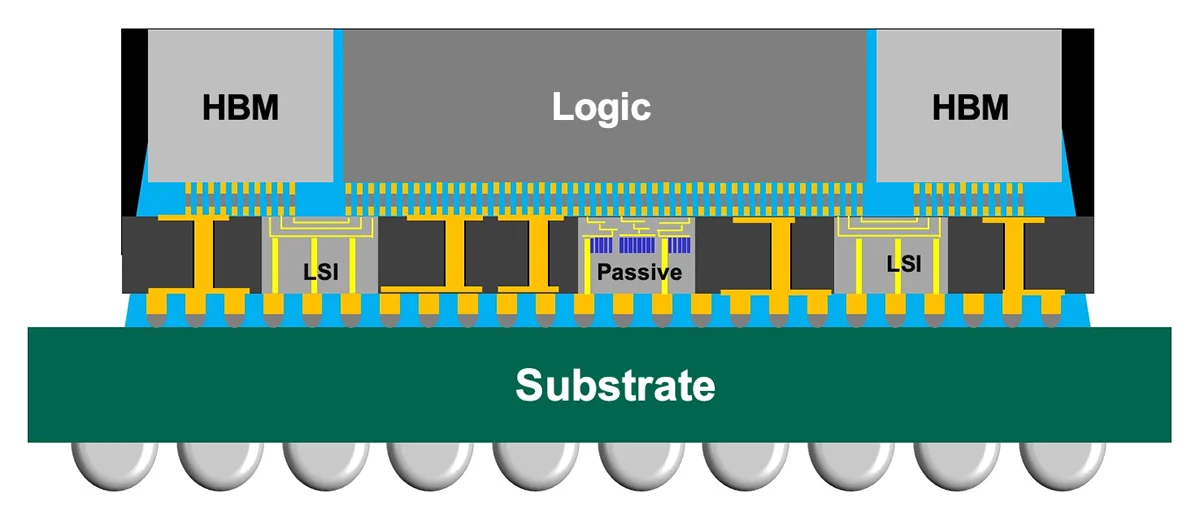
图源:TSMC 3DFabric。CoWoS-L 用 RDL 中介层配合 LSI(局部硅互连)桥接芯片,把逻辑 die 与两侧 HBM 连接在同一个封装体上,下方经基板与 BGA 引出。选择 L 而非全硅中介层,本质是在互连密度、封装尺寸与成本之间取平衡:硅中介层能提供最高密度,但面积越大良率与成本压力越大。
这条赛道的紧张程度可以用产能数字衡量。TrendForce 在 2026 年 8 月的统计显示,TSMC 的 CoWoS 月产能从 2025 年约 7 万片提升到 2026 年底的 13-14 万片,其中 NVIDIA 一家预订了 2026 年 80-85 万片,占全年产能的一半以上;即便如此,2026 年的供需缺口仍约为 20%,2027 年的月产能预计进一步扩到 17 万片左右。先进封装产能之所以成为 AI 芯片实际出货量的天花板,正是因为封装环节的扩产周期并不比晶圆厂短。
封装内部互连密度的演进方向,则由 imec 的 3D 互连路线图给出:从 BGA、CSP、flip-chip、micro-bump,到 die stacking hybrid bonding、wafer-to-wafer hybrid bonding,再到 W2W dielectric bonding 与 nano-TSV,互连 pitch 逐级缩小、密度逐级提高,不同应用层次对应不同档位。
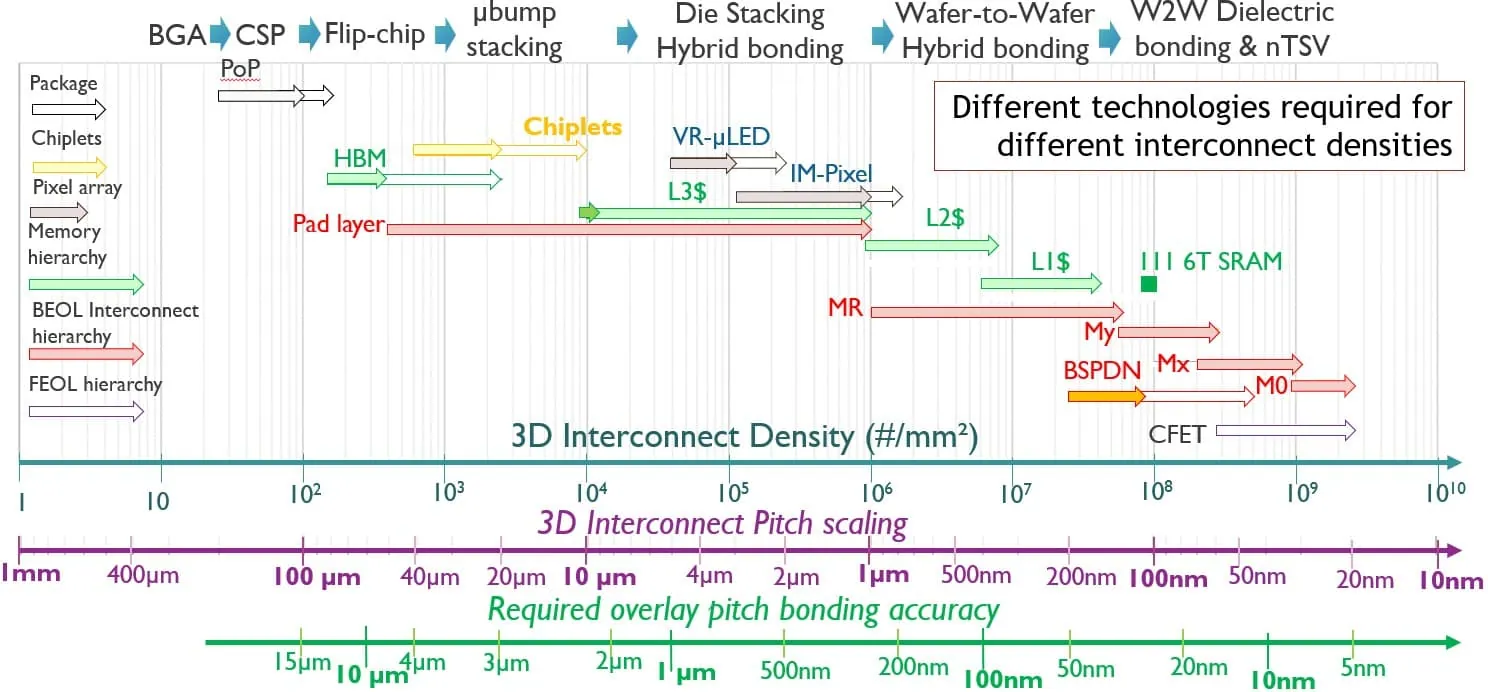
图源:imec。不同应用层次需要不同的互连 pitch 和密度:器件级堆叠追求最小 pitch,封装级互连更看重成本与可测试性。这张图的实用价值在于,它把“3D 集成”拆成了若干可分别评估的档位,而不是一个笼统的方向。
pitch 的缩小不是数字游戏,它直接决定单位面积能塞进多少个连接。SK hynix 给出的对比是:焊球(solder bump)pitch 约 100 µm,微凸点(micro bump)约 20 µm,铜-铜混合键合(Cu-Cu hybrid bonding)可以做到 2 µm 量级。
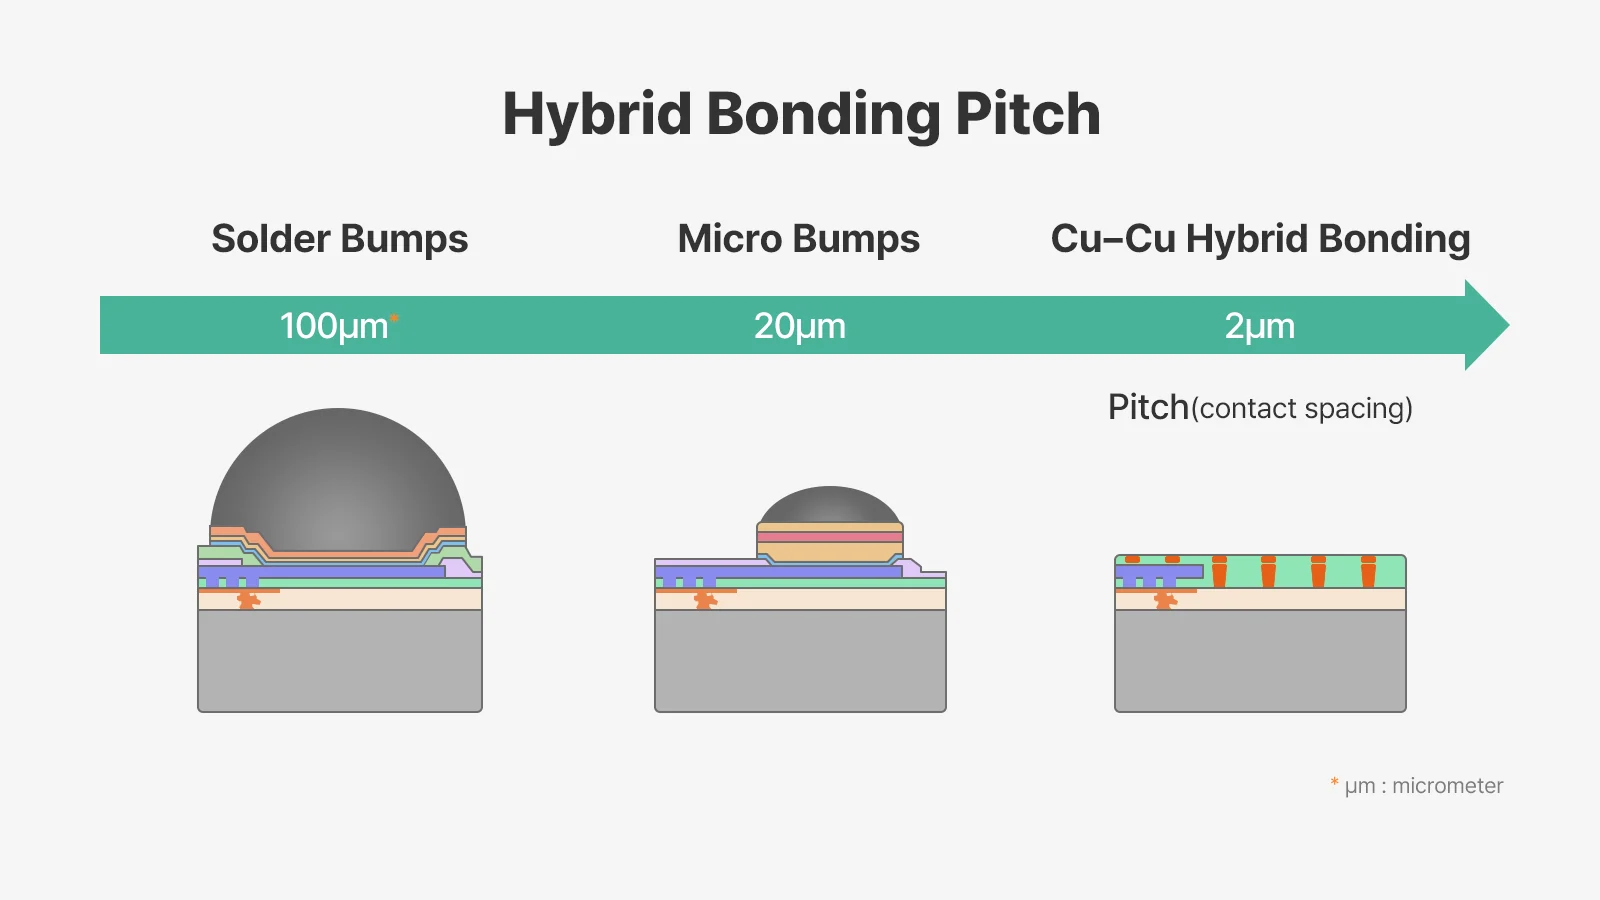
图源:SK hynix Newsroom。从焊球到微凸点再到铜-铜直接键合,互连 pitch 缩小了约 50 倍,单位面积可用连接数随之提升两到三个数量级。混合键合的意义正在于此:它不只是让堆叠更薄,而是让“跨 die 的带宽密度”接近片上互连的水平。
判断一项 3D 集成方案是否成立,需要同时看四个指标。
带宽密度决定计算 die 与 HBM、相邻 chiplet、I/O die 之间能传输多少数据。传统 PCB 走线无法提供足够密度和能效,硅中介层、RDL、混合键合与 UCIe 等 die-to-die 标准因此变得重要。
能耗决定 chiplet 化的经济性。跨 die 传输的每比特能耗必须足够低,否则拆分节省的制造成本会被通信功耗吃掉。距离越短、互连电容越小、协议越轻,能耗越低,这也是混合键合在高带宽低延迟场景中不可替代的原因。
良率与成本决定方案能否量产。拆分 chiplet 可以提高单个 die 的良率,并允许不同模块使用不同节点——计算 tile 用先进节点、I/O die 用成熟节点、模拟/电源/SerDes 用专用工艺、存储用 DRAM 工艺。但封装良率、已知良品 die 测试、封装后测试和返修成本也会上升,系统成本必须通过产品规模、复用率和封装良率共同摊薄。
热与机械可靠性决定方案的寿命。3D 堆叠提高功耗密度,散热路径被上层 die、underfill、interposer 和封装材料影响,逻辑堆逻辑比逻辑堆 SRAM 或 HBM 更难散热;热膨胀系数差异还会引入翘曲与应力,影响互连可靠性。真正能量产的 3D 方案,必须把热设计和机械设计纳入架构早期,而不是在版图完成后再补救。
未来五年先进封装会明显分层:最高端 AI/HPC 产品采用 CoWoS 类 2.5D 集成、多 HBM、更大 interposer 和更复杂的供电散热方案;移动与边缘设备更重视低厚度、低功耗和成本;汽车与工业要求长期可靠性和可追溯;存储产品则把混合键合作为提升 HBM 堆叠密度和带宽的关键。不同场景不会共享同一条封装路线。
存储墙:HBM4 只是开始,容量层次会继续外扩
AI 让存储技术重新成为集成电路产业的中心。过去十多年,逻辑制程和 GPU 算力常处于叙事中心,存储被视为配套。大模型推理与训练使这一关系反转:算力阵列如果等不到数据,就是昂贵的空转硅片。
芯片内部的矛盾首先是 SRAM。先进节点中 SRAM 单元面积的下降速度低于逻辑,漏电和稳定性约束更严,而 AI 加速器需要大量片上缓存来复用激活、权重、KV cache 或中间特征。片上 SRAM 无法无限增长,系统因此必须在寄存器、SRAM、HBM、CXL 内存、SSD 和网络存储之间建立更复杂的层次。
封装内的主角是 HBM。它通过 TSV 垂直堆叠 DRAM die,并用宽 I/O 与逻辑 die 相连,以较低频率换取极高总带宽。Micron HBM4 的公开参数是 2048-pin bus、超过 11.0 Gbps 的速率、单栈超过 2.8 TB/s 的带宽(12-hi 单栈 36 GB),方向在未来五年会继续推进。
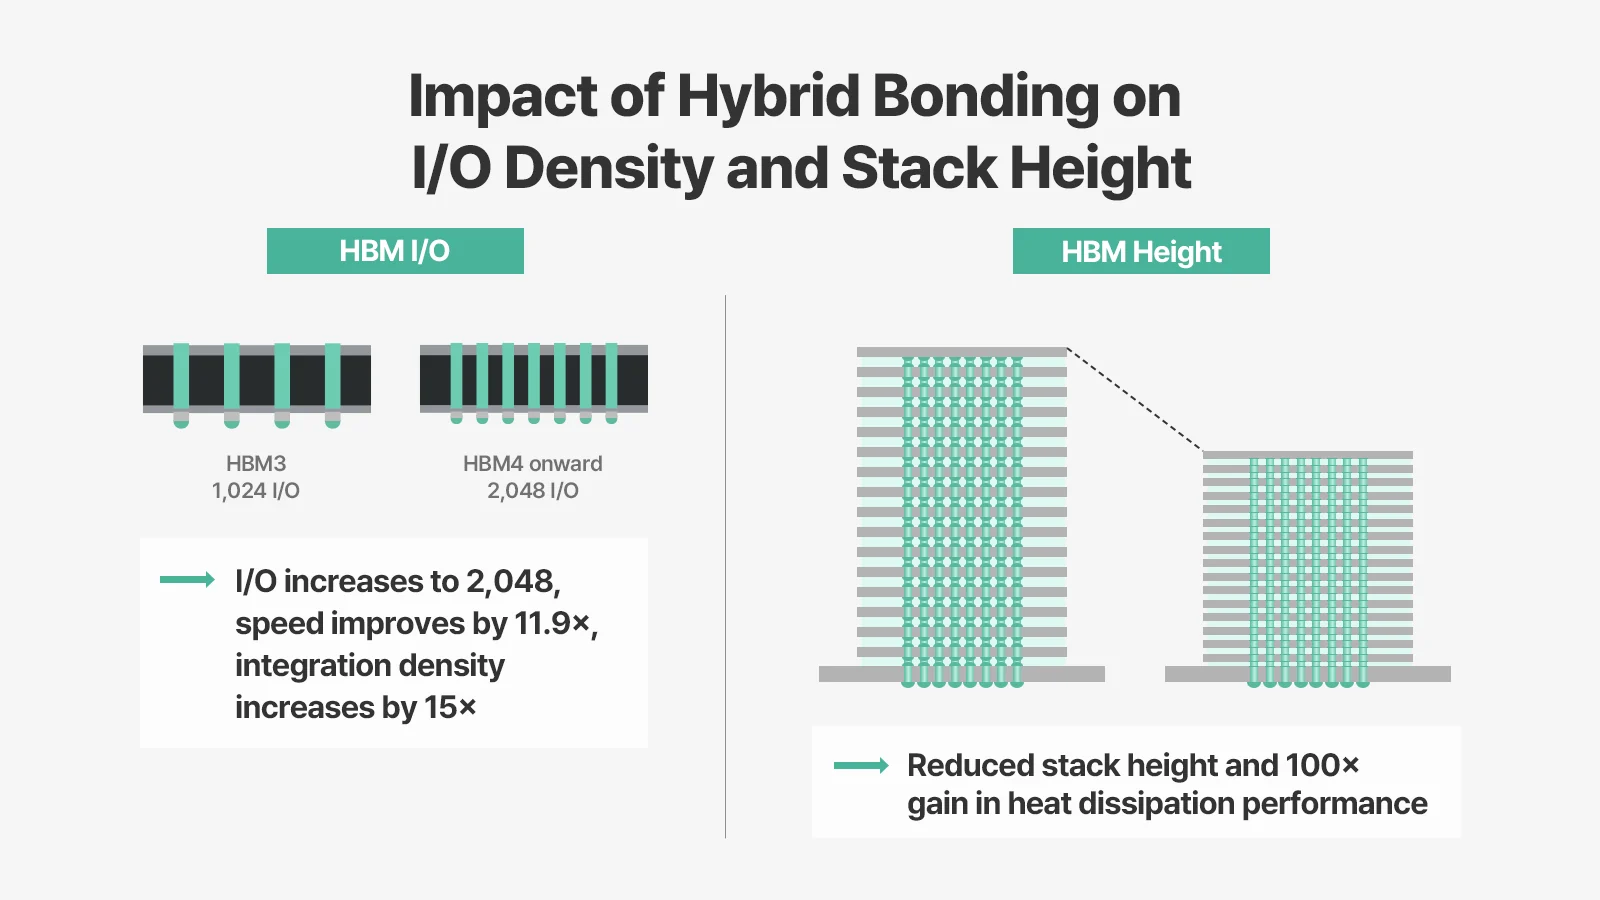
图源:SK hynix Newsroom。从 HBM3 的 1,024 I/O 到 HBM4 的 2,048 I/O,I/O 数量翻倍带来的是速度与集成密度的同步跃升,同时混合键合让堆叠高度下降、散热性能改善。这类改进的方向很明确:在不增加封装高度的前提下继续提高带宽。
存储的地位变化可以直接从成本结构上看出来。Epoch AI 在 2026 年 5 月给出的估算是:AI 芯片的元件成本中,HBM 的占比已从 2024 年第一季度的 52% 上升到 2025 年第四季度的 63%,同期先进封装占比从 19% 降到 15%,逻辑 die 稳定在约 13%。也就是说,在今天的旗舰 AI 加速器里,最贵的部分已经不是计算逻辑,而是给它喂数据的存储。这解释了为什么存储厂商会深度介入封装方案、为什么 HBM 的产能分配会直接影响 AI 芯片的出货节奏。
量产节奏能说明这项技术的难度。2026 年被普遍视为 HBM4 的量产元年,但三家供应商的认证与放量节奏几经调整,不同来源的报道也存在冲突:Samsung 的认证出货、SK hynix 的 16-hi 48 GB 产品、Micron 面向 NVIDIA Rubin 平台的 12-hi 产品,各自的时间点并不一致。这种反复本身是重要信息——HBM4 不是一个“设计完成即可放量”的器件,它同时受 DRAM 工艺、base die 逻辑工艺、封装良率和客户验证节奏约束。之后的 HBM4E 则进一步把单 pin 速率推到 16 Gbps 量级、能效提升约 20%。
存储墙的另一半在封装之外。KV cache、检索增强、多模态上下文、agent 记忆和批量服务会把容量需求推到 HBM 之外,CXL 内存池、近存计算、SSD KV cache、HBF(high bandwidth flash)等路线都在尝试解决“热数据放 HBM、温数据放扩展内存、冷数据放存储”的层次化问题。站内 HotChip/FMS 内存墙(二):HBF、OCP HBF Spec 与 HBF-Compass 讨论了容量层标准化的进展,H³ 完全拆解:HBM 与高带宽闪存(HBF)混合架构 则给出了 HBM 与 HBF 混合架构的具体设计。这里的关键不只是容量,而是调度策略:哪些数据值得留在 HBM,哪些可以压缩,哪些可以重算,哪些可以跨请求复用——这些问题的答案会直接反馈到芯片的内存管理、DMA、压缩与安全隔离设计上。
综合下来,存储墙的技术演进可能呈现三种形态。其一,高端 AI 加速器继续扩大 HBM 带宽和容量,通过更大封装、更高供电能力和更强散热维持性能,代价是极高的成本与供给集中度。其二,更多产品采用“适度 HBM + 大容量外部内存/存储”的混合层次,用 prefix cache、KV 压缩、稀疏注意力、投机解码和调度优化降低 HBM 压力,此时芯片必须暴露更好的内存管理与压缩能力。其三,存储与计算进一步贴近,近存计算、PIM、3D SRAM、logic-on-memory、CPO 和光互连都属于这一方向——它们未必在五年内全部成为主流,但会持续改变系统架构的设计空间。
自动化:EDA、DTCO/STCO 与智能制造合流
自动化是未来五年集成电路技术发展的另一条主线,但它指的不是多写一些脚本,而是设计、工艺、封装、制造、测试和供应链之间的闭环自动化。
先进芯片的复杂度已经让传统分工承压。架构团队定义计算单元和 NoC,前端团队写 RTL,验证团队构造测试,后端团队做综合、布局布线和时序收敛,工艺团队提供 PDK,封装团队处理互连和热,软件团队做编译器和运行时。过去这些环节可以相对串行,未来五年必须更早协同,因为一个局部决策就可能改变全局可行性:chiplet 切分方式影响封装走线和一致性协议,背面供电影响标准单元库和 PDN 分析,HBM 数量影响 interposer 面积和散热,AI kernel 的数据流影响片上 SRAM 容量和 NoC 拓扑。
DTCO(design-technology co-optimization,设计与工艺协同优化)和 STCO(system-technology co-optimization,系统与工艺协同优化)正是在回应这种耦合。DTCO 强调设计与工艺共同探索,STCO 进一步把封装、系统和软件纳入优化范围。未来五年,它们不会停留在论文术语层面,而会成为先进芯片产品化的组织方式——工艺节点、标准单元、SRAM macro、I/O、封装、散热和编译器需要在项目早期共同探索。缺少 STCO 能力的团队,即使拿到先进节点,也很难把 PPA 优势转化为系统性能。
AI 会加速这一趋势,但边界同样清晰。机器学习可用于版图热点预测、寄生参数估计、时序路径筛选、功耗回归、IR drop 预测、工艺窗口建模、缺陷分类和设备维护;生成式模型可辅助规格解析、RTL 生成、验证用例生成、约束文件检查和脚本编写。然而芯片设计不同于普通软件生成:错误代价极高,物理约束严密,验证闭环复杂,模型输出必须接受形式验证、仿真、静态时序分析、DRC/LVS、等价检查和硅后测试。因此 AI 在 EDA 中的合理角色不是“自动生成可流片芯片”,而是在可验证闭环中扩大搜索空间、减少人工试错、提前暴露风险。
制造端的自动化同样重要。先进 fab 的设备数量、传感器数据、工艺步骤和质量控制复杂度极高,TSMC 在先进封装服务说明中提到,其智能封装厂使用深度学习和图像识别优化制造、缩短 cycle time,并建立质量防线与缺陷预防系统。这类应用会继续扩展到晶圆制造、封装、测试和供应链。fab 于是不只是物理工厂,也是数据密集型系统:设备状态、工艺参数、缺陷图、量测数据、良率分布和订单排程共同构成优化对象。
自动化还会改变人才结构。产业仍然需要器件、工艺、版图、验证、封装和测试专家,但这些专家会越来越多地与数据科学、控制系统、优化算法和软件工程交叉。真正稀缺的不是会调用工具的人,而是能理解物理约束、把问题形式化、并让自动化工具在正确目标函数下工作的工程师。
互连与光:电互连仍是主力,系统边界在移动
随着 AI 集群规模扩大,互连问题从芯片内延伸到封装内、板级、机柜级和数据中心级。单芯片算力提升如果不能被内存和网络喂饱,系统效率会迅速下降。
芯片内互连面对 RC 延迟、拥塞、功耗和同步问题,NoC 拓扑、缓存一致性、低精度数据路径和局部性优化会继续演进。封装内互连面对 die-to-die 带宽、协议开销、测试和可靠性问题,UCIe 之类的开放标准因此重要:UCIe 3.0 规范于 2025 年 9 月发布,把单通道速率推进到 48/64 GT/s,并保持向后兼容,其意义在于降低多厂商 chiplet 协同的成本。不过开放标准与高端定制并不矛盾——顶级 AI 芯片仍可能在关键路径上使用私有互连以追求极致能效,同时在部分 I/O 或生态接口上采用标准。
板级与机柜级互连则撞上铜线的能耗和信号完整性限制。随着加速器之间通信量上升,co-packaged optics(CPO,共封装光学)与硅光受到关注:把光学 I/O 移近计算芯片,缩短高速电连接距离,从而降低能耗、提升带宽密度。
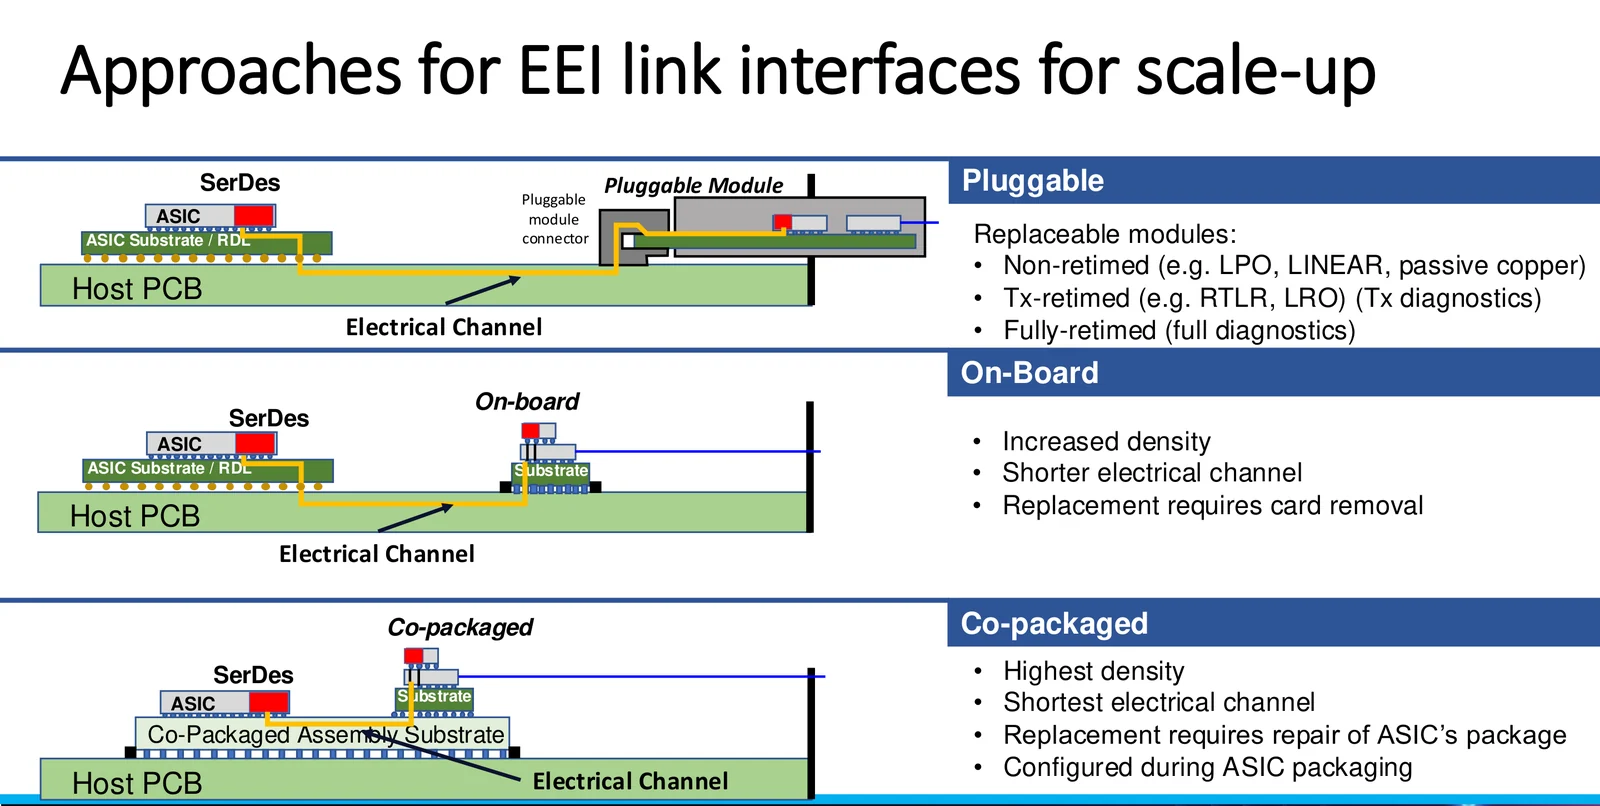
图源:OIF(OFC 2025, OIF EEI Interop)。从可插拔模块、板载光学到共封装光学,电通道长度依次缩短,密度依次提高,代价是可维护性依次下降:可插拔模块可以现场更换,共封装光学则需要维修 ASIC 的封装体。这张图的实用价值是把“为什么要 CPO”和“CPO 的代价是什么”放在同一张图上。
量化目标能说明这条路线要解决的问题有多大。OIF 给出的下一代电/光互连目标是:约 10 m 距离内单比特能耗低于 5 pJ/b,约 100 m 距离内低于 10 pJ/b,带宽密度达到 2-4 Tb/s/mm。SK hynix 2026 年发表在 Nature Electronics 上的 CPO 技术路线图则给出更高的目标:单节点超过 100 Tb/s、能耗低于 1 pJ/bit、延迟低于 10 ns,并把 AI 竞争的重心从“芯片”描述为“系统”。
但 CPO 量产仍面临激光源、封装、散热、测试、可维护性和标准化问题,五年内不会完全替代传统光模块。更可能的情形是:高端交换芯片、AI 集群互连和特定数据中心场景率先采用,随后与传统可插拔光模块长期并存。
从产业角度看,互连技术把集成电路的竞争范围扩展到了系统厂商。AI 集群的真实性能取决于芯片、NIC、交换机、光模块、线缆、电源、冷却和调度软件的协同,芯片公司若只交付单颗加速器,会越来越难解释实际 TCO;系统公司若不能理解底层封装和互连限制,也难以构建高效集群。未来五年,芯片产业与系统产业的边界会继续模糊。
制造与供应链:资本开支、设备瓶颈与地缘约束共同塑形
集成电路技术路线不能脱离制造与供应链。先进制程和先进封装都是资本密集型产业,技术是否可行还取决于设备交付、材料供应、良率爬坡、客户规模和政策环境。
SEMI 2026 年第二季度的设备数据是一个强信号:405.3 亿美元的季度销售额不仅意味着新 fab 建设,也意味着先进节点、先进封装、量测、测试和存储产线的同步升级。按地区拆分可以看到结构特征——中国大陆、中国台湾和韩国是前三大设备市场,其中中国台湾与韩国的增速明显受先进逻辑与存储扩产驱动。
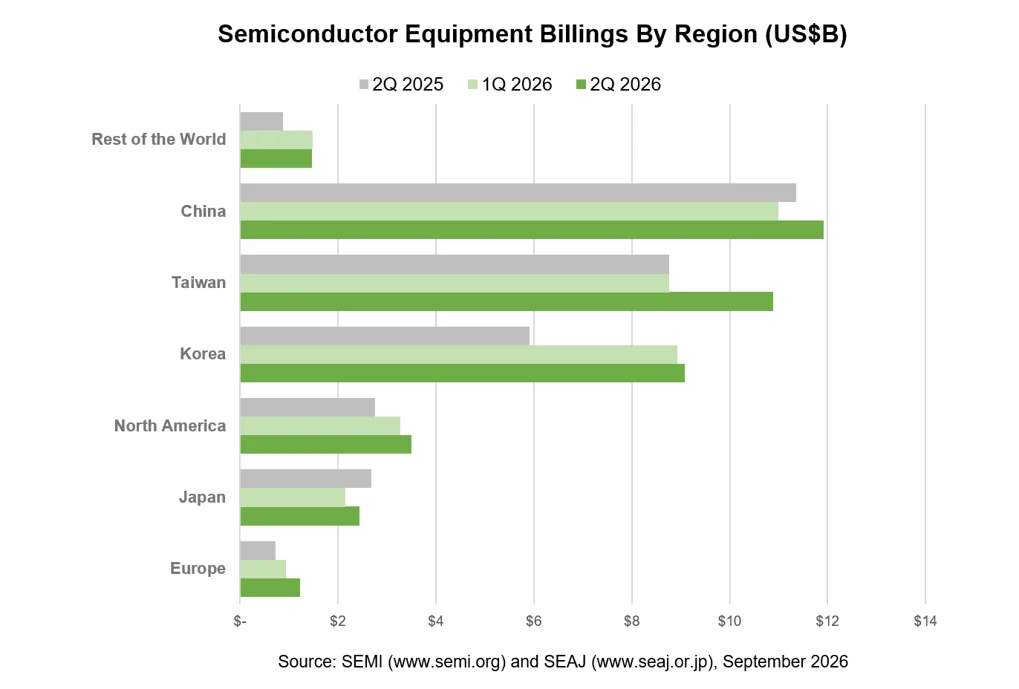
图源:SEMI 与 SEAJ,2026 年 9 月发布。柱状图按地区对比 2025 年第二季度、2026 年第一季度与 2026 年第二季度的设备销售额。区域结构的集中度本身就是一个风险指标:设备支出的高度集中意味着技术扩散的路径也高度集中。
资本开支的量级解释了这种扩张为什么难以减速。TrendForce 统计的九家主要云厂商 2026 年资本开支合计约 8,300 亿美元,同比增长约 79%;Dell’Oro 的口径更大,认为全球数据中心资本开支在 2026 年突破 1 万亿美元。供给一侧,TSMC 在 2026 年第二季度法说会上把全年资本开支指引上调到 600-640 亿美元,其中七到八成投向先进制程。需求端的资本以罕见速度转化为设备订单,这也是 SEMI 设备数据的宏观背景。
与此同时,设备、材料和子系统供应链高度集中。EUV 设备依赖 ASML 及其复杂供应网络;先进刻蚀、薄膜、量测、CMP、离子注入、清洗、封装键合和测试设备各有瓶颈;高纯材料、光刻胶、掩模、特种气体、石英、陶瓷和关键零部件也可能成为约束。先进封装的扩产经验已经说明,瓶颈往往不出现在最受关注的那一环——CoWoS 的产能爬坡受制于 interposer、基板、测试与散热等多个环节的协同,而不是单一工序。
地缘政治会持续影响技术扩散。出口管制、补贴政策、本地化制造、双供应链策略和关键材料安全都会影响企业路线选择。先进 AI 芯片受到更严格管制后,部分地区可能强化成熟节点、先进封装、专用加速器、存储、EDA 替代和设备材料国产化。全球产业不会简单脱钩,但“效率最高的全球分工”会被“效率、安全和政策约束折中”的结构取代。
制造端还面临能耗与可持续性压力。先进 fab 的用电、用水和化学品消耗巨大,AI 数据中心本身也在推高电力需求。芯片能效因此不只是产品卖点,也会成为产业扩张的限制条件:如果单位计算能耗的下降速度赶不上 AI 需求的增长,供电和散热就会从工程问题变成商业问题。集成电路技术因而必须同时追求芯片级能效和制造端低碳化。
分领域判断:七个方向的五年窗口
不同方向的成熟度、风险和产业影响差异明显,下面按领域给出更具体的判断。
逻辑制程方面,GAA 与背面供电进入关键量产窗口。2 nm 级节点会逐步扩散到高端手机、AI、HPC 和服务器 CPU/GPU,High NA EUV 服务更先进节点和关键层开发。需要关注的指标不是节点名称,而是 GAA 良率、SRAM 缩放速度、背面供电的设计生态成熟度、High NA 的成本摊销,以及先进节点客户的高度集中。
先进封装方面,CoWoS 类 2.5D、fan-out、高密度有机基板、混合键合和晶圆对晶圆键合都会增长,AI 对 HBM 的需求会持续推动封装产能扩张。瓶颈可能来自 interposer 尺寸、封装良率、HBM 供给、基板、测试和散热,封装厂、晶圆厂、存储厂与系统厂会形成更紧密的合作关系。
存储方面,HBM4 与后续 HBM4E 是高端 AI 的关键资源,DDR5/LPDDR5X/LPDDR6、CXL 内存、SSD 和新型非易失存储共同构成容量层次。存储产业的周期性依然存在,但 AI 提高了高端存储需求的结构性占比。真正的机会不只在 DRAM die 本身,而在“存储 + 封装 + 控制器 + 系统调度”的整套方案。
EDA 与 IP 方面,AI 辅助设计会从营销概念进入务实阶段,短期最可信的落点是验证、调试、版图热点、脚本生成、文档理解、约束检查和设计空间探索;端到端自动流片仍不现实,但局部效率提升会累积成显著竞争力。IP 侧,die-to-die PHY、HBM controller、CXL、PCIe、SerDes、安全 IP、RISC-V、NPU 和领域专用加速器 IP 的需求会继续增长。
功率与模拟方面,宽禁带半导体、汽车电动化、数据中心电源和可再生能源推动 SiC/GaN 持续发展。这个方向不追求最小节点,却对材料、可靠性、封装散热和制造一致性要求极高,AI 数据中心的供电链路升级会给功率器件带来间接但稳定的需求。
传感器与边缘方面,机器人、汽车、工业视觉、医疗设备和智能终端需要图像传感器、雷达、MEMS、模拟前端和边缘 AI 芯片。具身智能若继续发展,会推动低功耗传感融合、实时控制与安全可靠芯片的增长;但这类产品更依赖系统定义和场景落地,而不是先进制程。
光电融合方面,silicon photonics、CPO、光 I/O 和封装内光互连会加速研发和部分导入,商业化节奏取决于标准、测试、可靠性、可维护性与生态。短期最可能在数据中心网络和高端交换场景取得突破,中长期才可能更深入地进入计算封装。
成熟节点并不落后:分化才是真实结构
讨论集成电路技术,容易陷入一个误区:把“先进”等同于“最小工艺节点”。这个判断在 AI/HPC 旗舰芯片上大体成立,对整个产业却不成立。汽车、工业、功率、模拟、射频、传感器、MCU、安全芯片、显示驱动和电源管理等大量市场,不会因为 2 nm 或 1.4 nm 出现就迁移到最先进节点——它们的关键指标是可靠性、寿命、温度范围、成本、长期供货、认证周期、抗干扰能力和工艺稳定性。
这种分化不是保守,而是由物理与商业约束共同决定。模拟电路需要电压余量、匹配性和低噪声;功率器件需要击穿电压、导通电阻和热可靠性;车规芯片需要功能安全、长期一致性和供应可追溯;传感器需要光学、MEMS、射频或生物兼容工艺。这些问题不会因为晶体管更小而自动改善,有时反而会恶化。成熟节点和特色工艺因此会继续承载很大一部分增量价值。
功率半导体是典型例子。SiC 和 GaN 的核心竞争不是线宽,而是材料缺陷控制、外延质量、栅氧可靠性、封装热阻、驱动保护和系统级效率。电动车、光伏、储能、服务器电源和 AI 数据中心都在增加高效率功率转换需求;如果 AI 数据中心继续扩大,供电链路从电网、变压器、机柜电源、板级 VRM 到封装内供电都会承压,功率器件的技术进步会间接决定 AI 集群能否在可接受的能耗下扩张。
模拟与射频同样因边缘智能和通信需求保持重要性。毫米波雷达、车载以太网、卫星通信、Wi-Fi、蜂窝通信、工业传感和医疗设备需要高质量模拟前端。数字电路可以通过复制和缩放获得规模收益,模拟电路则高度依赖经验、版图细节和工艺特性。AI 或许能帮助模拟设计做拓扑搜索、版图匹配和寄生估计,但短期内不会消除模拟工程的专业壁垒。
传感器领域的趋势同样无法由节点大小解释。机器人和自动驾驶需要图像传感器、事件相机、激光雷达、毫米波雷达、惯性传感器、力觉/触觉传感器和低功耗边缘处理器;医疗和工业设备需要高可靠、高灵敏度、低噪声、可校准的感知链路。这里的“先进”往往是系统集成先进,而不是单个 CMOS 节点先进——把传感器、模拟前端、存储、AI 推理和安全模块封装在一起,可能比追逐更小节点更有价值。
因此未来五年会形成双层结构。第一层是面向 AI/HPC 的极限技术链:先进逻辑、HBM、CoWoS 类封装、CPO、液冷、EDA AI 和超大规模资本开支。第二层是面向广泛电子系统的韧性技术链:成熟节点、特色工艺、功率器件、MCU、传感器、模拟/射频、工业可靠性和区域供应链。前者决定技术天花板,后者决定产业底座;只看第一层会低估集成电路的广度,只看第二层又会低估 AI 对顶层技术路线的牵引。
产业组织:从单点领先转向生态协同
技术路线变化会重塑产业组织。先进节点时代,晶圆厂、EDA、IP、设计公司和封测厂已经高度分工;chiplet 与 3D 集成让这种分工更复杂。一个多 die 系统可能同时涉及先进逻辑晶圆厂、成熟节点 I/O die、存储厂 HBM、封装厂、基板厂、散热方案、die-to-die PHY、系统软件和云服务商,任何一环接口不清晰,都会放大项目风险。
这也是 UCIe 等标准重要的原因:开放 die-to-die 标准的意义不只是提升带宽,而是降低多厂商 chiplet 协作的成本。没有标准,chiplet 很容易退化为少数巨头内部的私有集成;有了标准,第三方 IP、测试、封装和设计服务才有机会形成生态。标准化当然也有边界——最高端产品仍会在关键路径上采用私有协议以换取极致能效和带宽密度,因此 chiplet 生态更可能呈现“开放接口 + 私有优化”并存,而不是完全开放或完全封闭。
EDA 厂商的角色会随之前移。过去 EDA 更像设计流程中的工具提供者,未来它会越来越接近系统架构的共同定义者:3D-IC、背面供电、热机械耦合、封装寄生、die-to-die 协议和制造良率都需要在早期被建模,如果等 RTL 完成、版图接近收敛后再考虑封装和热,返工代价会非常高。EDA 的价值会从“自动完成某一步”扩展为“让跨域 trade-off 可计算、可比较、可追溯”。
制造企业则会从纯制造服务向平台化服务扩展。先进封装、参考流程、标准单元库、IP 认证、3D 热模型、chiplet 测试方法和软件生态都会成为吸引客户的组成部分。对客户而言,选择节点不再只是比较 PPA 表格,而是比较一整套生态成熟度:设计工具是否支持、IP 是否可得、封装产能是否足够、HBM 能否配套、量产爬坡是否可预测、供应链是否稳定。
这种组织变化会提高行业门槛。顶级 AI 芯片公司需要同时掌握架构、软件、封装、供应链和系统销售;初创公司若只有单点微架构创新,很难独立承担先进节点和封装的成本。反过来,在成熟节点、专用场景、边缘 AI、模拟/功率/传感器、EDA 自动化和 chiplet IP 上,仍会存在更适合中小团队的机会。有生命力的创新往往会避开“与巨头在同一条成本曲线上硬拼”,转向更清晰的系统痛点。
五年节奏表:量产、导入与研发
为了避免把所有技术混在同一时间尺度上,有必要区分未来五年的成熟度。
| 技术方向 | 2026-2031 年判断 | 主要约束 |
|---|---|---|
| GAA nanosheet | 高端逻辑节点的主流量产方向 | 良率、标准单元库、SRAM 缩放、成本 |
| High NA EUV | 关键层量产已开始,广泛放量预计在 2027-2028 年 | 设备成本、半场曝光、掩模、光刻胶随机性 |
| 背面供电 | 高端节点的核心竞争力,2026-2027 年进入量产竞赛 | 晶圆减薄、背面对准、EDA/PDK 支持 |
| CFET | 以研发和早期 DTCO 为主,商业化更可能在 2031 年之后 | 工艺顺序、热预算、接触电阻、良率 |
| CoWoS/2.5D 封装 | AI/HPC 主流扩张方向,产能仍是瓶颈 | HBM 供给、interposer、基板、散热 |
| Hybrid bonding | 存储与部分 3D 集成加速导入 | 表面洁净、对准、测试、返修 |
| UCIe/chiplet 标准 | 生态逐步成熟,高端仍以私有方案为主 | 互操作、测试、商业模式 |
| HBM4/HBM4E | 高端 AI 的关键资源,量产节奏受验证约束 | 成本、产能、封装功耗、供应集中度 |
| CXL 内存池 | 服务器容量层次的重要补充 | 延迟、软件调度、一致性、安全隔离 |
| CPO/硅光 | 数据中心网络和高端交换率先采用 | 激光源、封装、测试、可维护性 |
| AI EDA | 验证、调试、DSE、脚本和版图热点先落地 | 可验证性、数据闭环、责任边界 |
| SiC/GaN | 电动车、数据中心电源、工业能源持续增长 | 材料缺陷、可靠性、成本、封装散热 |
这张表的核心含义是:未来五年的集成电路不会让所有前沿技术同时商业化,而是形成不同成熟度梯队。GAA、HBM、CoWoS、背面供电和 EDA AI 会在产业层面产生直接影响;CFET、2D 材料、单片 3D 逻辑和更激进的片上光互连仍以研发和局部试验为主。判断技术趋势时,必须区分“论文中可展示”“试验线可验证”“客户可设计”“大规模可盈利量产”这四个阶段——绝大多数误判都来自把前两个阶段当成后两个阶段。
风险与不确定性:技术路线不是线性外推
对前景保持乐观,并不意味着忽视风险。关键不确定性至少有六类。
第一,AI 需求可能波动。 当前先进制程、HBM 和封装扩张在很大程度上由 AI 投资驱动。如果 AI 商业化收入不及预期、推理成本下降、或模型效率提升改变了硬件需求结构,部分产能节奏就会调整。即便出现短期波动,AI 对算力、存储和互连架构的长期影响也已经形成。
第二,先进节点成本可能继续上升。 High NA EUV、背面供电、GAA、复杂量测和多重工艺会推高晶圆成本。如果只有少数超大客户能承担,先进节点生态会更集中,中小芯片公司会更多依赖 chiplet、成熟节点和专用架构。
第三,封装可能成为新瓶颈。 先进封装的产能、良率、测试和散热如果跟不上,逻辑 die 的 scaling 收益就无法释放。HBM 供给与 CoWoS 类产能已经在 AI 周期中多次成为焦点,未来五年仍可能反复出现。
第四,EDA 与验证复杂度可能限制创新速度。 chiplet、3D 集成、背面供电、多物理场耦合和安全需求会显著增加验证难度。如果工具链不能及时成熟,设计周期和风险会抵消一部分技术收益。
第五,供应链和政策约束可能改变最优路线。 出口管制、本地补贴、关键材料限制和区域市场差异会让不同地区采用不同的技术组合,全球最先进路线与区域可获得路线之间的差距可能扩大。
第六,能耗和散热可能成为硬边界。 AI 数据中心规模增长使供电和冷却成为系统级问题,芯片若只追求峰值算力而忽视能效,产品竞争力会下降,液冷、先进 TIM、背面散热、封装级热设计和动态功耗管理会越来越重要。
结语:下一个五年的竞争是系统能力
未来五年集成电路技术的关键词不是某一个节点、某一种封装或某一类 AI 芯片,而是系统级摩尔定律。传统摩尔定律强调单位面积的晶体管数量增长;系统级摩尔定律强调在单位成本、单位能耗、单位封装体积和单位系统复杂度下,可交付的有效计算能力持续增长。
这一增长会来自多条路径的叠加:GAA 与 High NA EUV 继续推动先进逻辑;背面供电与低电阻互连缓解电源和布线瓶颈;3D 堆叠与先进封装突破单片 die 的限制;HBM4、CXL 和分层存储应对 AI 的数据搬运需求;UCIe、CPO 和高速互连扩展系统边界;EDA AI、DTCO/STCO 与智能制造提高复杂系统的可设计性与可制造性。它们之间没有替代关系,只有互相解锁或互相拖累的关系。
因此,下一个五年最值得关注的不是“谁先喊出更小的纳米数字”,而是谁能把晶体管、封装、存储、互连、软件、制造和供应链组织成可量产、可验证、可盈利、可扩展的系统。AI 会继续提供需求牵引,也会迫使产业直面真实物理边界:电流如何送达,热量如何排出,数据如何移动,良率如何保证,成本如何闭合。这些问题的答案,决定了未来五年哪些技术路线能真正落到产品上。
附录:常用缩略语
| 缩略语 | 全称 | 在本语境中的含义 |
|---|---|---|
| GAA | gate-all-around | 栅极全环绕晶体管,nanosheet 是其主流实现 |
| CFET | complementary FET | 互补场效应晶体管,把 nFET 与 pFET 垂直堆叠 |
| BSPDN | backside power delivery network | 背面供电网络,电源从晶圆背面送入器件层 |
| BPR | buried power rail | 埋入式电源轨,为背面供电提供低位电源通路 |
| nano-TSV | nano through-silicon via | 纳米硅通孔,连接背面电源网络与正面器件 |
| HBM | high bandwidth memory | 高带宽存储,DRAM 经 TSV 垂直堆叠 |
| CXL | compute express link | 面向内存与加速器的缓存一致性互连协议 |
| HBF | high bandwidth flash | 高带宽闪存,面向容量层的存储层级方案 |
| UCIe | universal chiplet interconnect express | 开放 die-to-die 互连标准 |
| CPO | co-packaged optics | 共封装光学,把光引擎与交换/计算芯片封装在一起 |
| SoIC | system on integrated chips | TSMC 的前端 3D 堆叠技术 |
| CoWoS | chip on wafer on substrate | TSMC 的 2.5D 集成平台 |
| InFO | integrated fan-out | 扇出型封装技术 |
| DTCO | design-technology co-optimization | 设计与工艺协同优化 |
| STCO | system-technology co-optimization | 系统与工艺协同优化 |
| PDK | process design kit | 工艺设计套件,连接工艺与设计工具 |
| IR drop | — | 电源网络上的电压降,影响时序与可靠性 |
| PPAC | performance, power, area, cost | 芯片评价的四个基础维度 |
参考文献逐篇研读:从“列出处”走向“解释证据”
仅在文末罗列链接,不足以支撑一篇面向未来五年的技术研判。不同资料的性质并不相同:设备厂商页面能够说明已公开的产品能力,却不能单独证明客户会以何种速度采用;晶圆厂和存储厂的技术简报能够说明工艺目标,却仍需等待良率、客户验证和规模化成本检验;行业协会统计接近实际出货,但对未来的解释力有限;咨询机构预测能揭示资本和供需预期,却最容易受周期拐点影响。以下逐篇说明本文 35 项参考资料的核心内容、证据价值、局限性,以及它们如何共同支撑 2026-2031 年“系统级摩尔定律”的判断。
图:本文采用的证据分层。路线图回答“可能走向哪里”,产品资料回答“当前做到什么程度”,标准回答“生态如何互操作”,市场数据回答“谁在为这些技术付费”。四类证据互相校验,才能避免把实验室样品直接写成量产事实,也避免把短期景气直接外推成长期规律。
文献研读一:ASML《EUV Lithography Systems》——High NA 的价值不只在分辨率
ASML 的 EUV 产品总览给出了理解先进光刻最直接的一组基准:现有 NXE 平台采用 13.5 nm 波长与 0.33 NA,单次曝光分辨率约 13 nm;EXE High NA 平台把数值孔径提高到 0.55,目标分辨率推进到 8 nm。页面同时强调 DUV 与 EUV 将长期并用,因为一颗先进芯片只有最关键的若干层需要最高分辨率,其余层继续使用成熟、吞吐量更高且成本更低的设备。这一点很重要:未来五年不是所有图形层都被 High NA 接管,而是光刻资源按层级精细配置。
这份资料的第二个价值,在于揭示 EUV 不是一台“更短波长的相机”。锡滴每秒被激光击打数万次以产生 EUV 光,光路必须保持高真空,反射式多层膜光学系统代替普通透镜,晶圆台还要在极高速运动中保持亚纳米级定位。于是,EUV 的进步依赖光源功率、反射镜、掩模、光刻胶、缺陷检测、晶圆台、计算光刻和设备可用率共同提升。任何一个环节不足,都可能把理论分辨率的优势转化为较低吞吐或较高缺陷成本。
对 2026-2031 年的判断是,High NA 会从少数关键层和先行客户开始扩散,但不会形成“一夜换代”。其经济价值取决于它能否用一次曝光替代多重图形化、降低工艺步骤与 overlay 风险;若设备折旧、半场曝光、掩模拼接或随机缺陷成本过高,0.33 NA EUV 配合计算光刻仍会在一些节点和层级保持竞争力。因此,光刻路线的真实竞争单位不是标称分辨率,而是每个合格图形的综合成本。
文献研读二:ASML《The Rayleigh Criterion for Resolution》——把 scaling 写成可计算的约束
这篇基础说明给出了本文采用的光刻关系式 ,并指出传统投影光刻中 的物理下限约为 0.25。它把“线宽还能不能缩小”拆成三个可操作变量:减小波长、增大数值孔径、降低工艺因子 。EUV 把波长固定在 13.5 nm,High NA 继续提高 ,而 OPC、光源形状优化、掩模修正、计算光刻与工艺控制则共同压低有效 。
这个公式也能解释为什么节点名称越来越不能代表单一物理尺寸。即使 继续下降,芯片密度仍取决于接触、金属间距、标准单元高度、SRAM bitcell、设计规则和可接受的良率;同一标称节点上,不同库和不同产品的有效密度可能显著不同。未来五年的 scaling 因而是“光刻分辨率 + 器件结构 + 互连 + 设计规则”的联合结果,不应把某一个纳米数字误认为完整技术水平。
图:Rayleigh 判据背后的工程代价。分辨率不是孤立指标,每一种缩小 的方法都会把压力传导到设备、材料、掩模、量测和计算环节。
文献研读三:Intel Foundry《Intel 18A Process》——GAA 与背面供电首次同时进入产品平台
Intel 18A 页面把 RibbonFET 与 PowerVia 并列为节点的两个核心变化。RibbonFET 是 GAA nanosheet 的具体实现,栅极完整包围沟道,以增强短沟道控制并允许通过 ribbon 宽度调节驱动能力;PowerVia 则把粗间距电源金属和供电凸点移到晶圆背面,并通过纳米级硅通孔向标准单元送电。两者分别处理器件栅控与供电拥塞,说明先进节点的增益已经不能靠单一晶体管结构完成。
厂商页面还给出相对于 Intel 3 的目标数据,包括同功耗性能提升、同性能功耗下降、密度提升,以及最坏动态电压跌落改善和布局面积压缩。这些数字有参考价值,但属于同一厂商在特定测试结构、设计规则和比较基线下得到的结果,不能直接换算为任意商业芯片的整机收益。产品最终表现还要经过微架构、缓存、频率曲线、封装、良率和软件共同过滤。
18A 的行业意义大于某一项百分比:它证明 GAA 与背面供电能够在同一高量产平台上协同出现,并迫使 EDA、IP、标准单元、可靠性和测试流程一起更新。未来五年其他先进节点即使采用不同命名,也会面对相同问题:如何让器件获得足够稳定的电流,如何释放正面互连资源,以及如何把新工艺模块的收益转化为可设计、可验证的 PPA 改善。
文献研读四:Intel《18A Process Node Family Technology Brief》——节点正在变成面向场景的平台族
技术简报的价值在于,它不把 18A 描述成单一工艺点,而是把基础版本、性能增强版本和面向 3D 集成的版本组织成平台族。不同产品对低电压工作、高频、热阻、I/O、混合键合和直通 TSV 的权重不同,用一个固定器件和金属栈服务所有客户已不再经济。节点内部形成多个派生版本,是先进工艺应对成本上升与需求分化的必然结果。
其中面向 3D-IC 的 18A-PT 尤其值得关注:当 base die 同时承担背面供电、垂直 TSV 和混合键合接口时,所谓“制程节点”已经跨越 FEOL、BEOL 与封装边界。底层 die 不再只是被动承载体,而可以负责供电、信号穿越、缓存、I/O 或系统管理。这正是系统级摩尔定律的一个具体形式:通过垂直分工获得的带宽密度与能效,可能比把所有晶体管放在同一平面继续缩小更有价值。
阅读这类技术简报还应注意,平台“可供设计”不等于所有模块都已达到相同量产成熟度。PDK、IP 认证、外部客户流片、良率和封装供应能力通常分阶段完善。因此本文把它作为路线方向和工程能力的证据,而不是对外部代工规模的预测依据。
文献研读五:imec《How to Power Chips from the Backside》——背面供电是一条完整工艺链
imec 的文章从工艺流程解释了 BSPDN,而不只展示概念剖面。晶圆需要完成器件与正面互连、与载片键合、极薄化、背面纳米硅通孔加工,再把 nTSV 与埋入式电源轨连接。文章指出,对准误差必须进入 10 nm 以下量级,并讨论晶圆键合造成的形变、硅衬底变薄后的自热效应,以及背面金属对横向热扩散的潜在补偿作用。
这些细节揭示了背面供电的真实风险。把 VDD/VSS 从正面搬到背面,可以缩短供电路径、降低 IR drop、释放信号布线资源,并支持更矮的标准单元;但它同时增加晶圆键合、减薄、背面对准、缺陷检测和热机械可靠性步骤。收益与风险并非分属“设计”和“制造”两个阶段,而是从一开始就耦合在一起。
未来五年背面供电最可能先在高功耗、高布线拥塞的 CPU、GPU、AI 加速器和高性能 base die 中兑现价值。对低成本、低功耗或成熟节点产品,新增工艺步骤未必划算。这份文献因此支持本文的分层判断:BSPDN 会成为先进逻辑的重要能力,但不会在五年内无差别覆盖所有集成电路。
图:背面供电不是一层额外金属,而是一条改变晶圆处理顺序的制造链。每一步都会产生新的对准、污染、热预算或机械风险。
文献研读六:imec《A Path to High-density Front- and Backside Wafer Connectivity》——250 nm pitch 指向 CMOS 2.0
这篇资料把背面连接与晶圆对晶圆混合键合放在同一条 CMOS 2.0 路线上。imec 报告其晶圆级混合键合从工业上常见的约 1 µm pitch 向 400 nm、300 nm 乃至 250 nm 推进,并把 200 nm 作为更长期目标。互连间距缩小时,垂直连接可以提供更高带宽密度和更低单比特能耗,从而使逻辑层、存储层和功能层的细粒度拆分成为可能。
真正困难的指标是 overlay。文章给出的经验关系是,对准精度通常要达到 pitch 的约四分之一;当 pitch 缩到 200 nm 时,目标对准误差只有约 50 nm,而且必须在整片 300 mm 晶圆上维持高良率。imec 展示的 300 nm pitch 结果在 95% die 上实现小于 25 nm 的 overlay 误差,但也明确指出,250 nm 及以下若要达到产业良率,需要下一代键合设备、形变建模和预补偿设计。
这份文献对未来五年的启示是,3D 集成的边界将从“封装级堆 die”逐步向“晶圆级堆功能层”移动,但其成熟速度由对准、表面平坦度、洁净度和已知良品策略决定。互连 pitch 的实验室纪录不能自动转化为量产密度;只有当键合良率、测试覆盖和成本共同闭合时,CMOS 2.0 才会从路线图变成产品架构。
文献研读七:imec《Putting Complementary FET Logic Technology on the Roadmap》——CFET 是面积缩放,不是短期救火
CFET 把 nFET 与 pFET 从平面并排改为垂直堆叠,直接瞄准标准单元中互补器件占据的横向面积。imec 的路线比较了单片式与顺序式集成:前者在同一流程中形成上下器件,垂直间距更小;后者分别优化两层器件后再集成,材料自由度更高,却增加对准、键合和热预算难题。两种路线都说明,器件三维化已从“是否需要”转向“以何种工艺顺序实现”。
CFET 的潜在收益包括缩小标准单元高度、改善 SRAM 面积缩放,并在上下层采用不同沟道材料或器件参数。但代价同样集中:下层器件必须承受上层加工热预算,源漏与栅接触要在狭小空间引出,寄生电容、局部热积累和缺陷耦合会比 nanosheet 更严重。上下任一层失效都可能报废整个器件堆栈,良率乘法效应不可忽略。
因此本文把 CFET 放在“未来五年强化研发、窗口末期出现更完整试验线结果、广泛商业化更可能在 2031 年以后”的位置。它是后 GAA 时代最清晰的面积 scaling 路径之一,却不是能够在本轮产品周期里普遍替代 nanosheet 的成熟方案。
图:先进逻辑器件的演进不是单纯缩短栅长,而是持续改变沟道受控方式和 n/p 器件的空间排布。
文献研读八:imec《Introducing 2D-material Based Devices in the Logic Scaling Roadmap》——二维材料解决的是极薄沟道问题
二维半导体的吸引力来自其原子级厚度:沟道在极薄条件下仍可能维持良好静电控制,理论上适合栅长继续缩短后的器件。imec 讨论的 MX2 类过渡金属硫族化合物并不是“直接替代硅”的单一材料,而是一组需要在迁移率、接触电阻、晶圆级生长、缺陷密度、掺杂与 CMOS 工艺兼容性之间取舍的候选体系。
这篇文章最有价值的地方,是没有把理想器件纪录等同于产业路线。二维材料研究常能在小尺寸试验器件上展示良好栅控,但大面积均匀沉积、低电阻接触、可重复阈值电压、数十亿器件的一致性,以及与 300 mm 产线兼容,才决定它能否进入量产。imec 提出先让结构较简单、性能要求较低的平面二维器件较早进入探索,以降低一次跨越到复杂堆叠器件的集成风险。
因此,二维材料在 2026-2031 年更可能扮演研发平台和局部功能候选,而不是主流 CMOS 的全面替代者。它对产业的现实贡献,是提前建立材料沉积、接触、量测和设计模型,使其在硅 nanosheet 与 CFET 接近物理或经济边界时具备接续可能。
文献研读九:imec《Entering the Nanosheet Transistor Era》——为什么 GAA 能成为近期主流
imec 将 nanosheet 描述为 FinFET 的自然演进:沟道从竖直 fin 变为多层水平片,栅极从四周包围沟道,在更短沟道下提供更强的静电控制。与 fin 宽度受工艺量化限制不同,nanosheet 可以通过片宽和片数调节有效沟道宽度,使高性能单元、低功耗单元和面积优化单元在同一平台上获得更灵活的器件选项。
“自然演进”不代表工艺简单。牺牲层选择性去除、内侧 spacer、源漏外延、纳米片形貌控制、金属栅填充和片间距缩小都需要新的集成窗口;片宽增加会提高驱动电流,也可能增加寄生电容。器件团队必须与标准单元、布线和 SRAM 团队共同决定最优几何,这正是 DTCO 从可选项变为必需品的原因。
这篇资料解释了为何未来五年 GAA nanosheet 的确定性高于 CFET 与二维材料:它保留了相当多 FinFET 时代的工艺模块和设计知识,同时提供足够明显的栅控与宽度可调优势。换言之,产业选择的不一定是理论上最激进的器件,而往往是“收益足够大、迁移路径又足够连续”的器件。
文献研读十:TSMC《Advanced Packaging Services》——封装厂正在变成系统制造平台
TSMC 的先进封装服务页面把封装体系分为 CoWoS、InFO、SoIC 等不同层级,并强调从硅片、3D 集成、基板到供应链协同的 turnkey 服务。其核心信息不是某一个封装品牌,而是晶圆制造企业正在把服务边界向系统集成延伸。客户交付的不再只是 GDS 和晶圆订单,还包括 chiplet 划分、HBM 配置、封装互连、热机械约束、测试与物流协同。
页面对智能封装工厂的描述同样重要:自动化数据、深度学习和图像识别被用于缩短 cycle time、质量防线和缺陷预防。这说明“AI 对半导体的影响”存在第二条路径——AI 不仅制造算力需求,也进入封装生产本身。对于多 die 系统,封装缺陷的组合效应更强,只有把设备数据、图像、工艺参数和电测结果连成闭环,才可能在规模扩大时守住良率。
不过,厂商服务页面天然强调能力覆盖,不能据此判断每种工艺的真实产能、客户份额或成本。它适合证明先进封装已经平台化和数据化,却需要结合 CoWoS 具体规格、财报资本开支和第三方产能统计,才能评估五年内的扩张速度。
文献研读十一:TSMC 3DFabric《CoWoS》——2.5D 仍是 AI 系统的量产主轴
CoWoS 页面区分 CoWoS-S、CoWoS-R 与 CoWoS-L。CoWoS-S 采用硅中介层,互连密度高但超大面积硅的成本与制造难度上升;CoWoS-R 采用 RDL interposer,在成本、布线和封装尺寸之间取平衡;CoWoS-L 则以 RDL interposer 配合局部硅互连 LSI,在需要高密度 die-to-die 的位置使用硅桥,其余区域由 RDL 承担。三条路线并存,本质上是在“哪里值得使用昂贵的高密度互连”这个问题上给出不同答案。
官方资料显示 CoWoS-S 可覆盖约 3.3 倍 reticle 的中介层面积,更大的系统可转向 CoWoS-L 或 CoWoS-R;CoWoS-L 的 3.5 倍 reticle 产品已在 2024 年进入量产。封装面积突破单个光刻 reticle 后,系统能够并排放置多个 compute die 与更多 HBM,但基板翘曲、供电、散热、interposer 缺陷和封装测试难度也同步上升。
未来五年 CoWoS 类 2.5D 封装仍会是高端 AI/HPC 的主轴,因为它在带宽、散热路径、已知良品 die 和量产经验之间提供了相对稳健的折中。真正的 3D logic-on-logic 会增加,但不会立刻取代 2.5D;在数百瓦乃至更高功耗的系统里,把高热流密度 die 平铺通常比垂直叠放更容易冷却。
图:CoWoS 不是单一封装结构,而是一组针对互连密度、面积和成本的工程选择。
文献研读十二:TSMC 3DFabric《TSMC-SoIC in Depth》——无凸点键合把 3D 互连推进到前端尺度
SoIC 面向的是比传统封装更细的三维连接。通过铜与介质同时直接键合,die 之间不再依赖体积较大的焊料凸点,互连距离和寄生参数下降,连接密度上升。对 CPU cache、逻辑与 SRAM、图像传感器、加速器与 base die 等需要高带宽低延迟的组合,这种前端式 3D 集成可把跨 die 通信做得更接近片上互连。
SoIC 的价值还在于把“工艺分层”变成设计自由度。上层可使用适合计算的先进逻辑,下层可使用更适合 SRAM、I/O、模拟或供电的工艺;不同 die 分别制造并筛选后再键合,有机会提高复用率。与此同时,known-good-die 测试、键合前表面质量、上下层热预算、供电路径、层间 ESD 和封装后失效分析都会更复杂。
这份资料支持一个较为克制的判断:混合键合会在未来五年明显扩大应用,但其速度会因场景而异。图像传感器、缓存堆叠和部分高价值计算产品可以承受复杂度,成本敏感的大众 SoC 则未必需要如此激进的 pitch。技术可用性和商业必要性必须同时成立。
文献研读十三:TSMC《Quarterly Results》——从收入与资本开支验证技术需求
晶圆厂季度业绩不能直接回答某个器件结构是否先进,却能检验需求是否足以支持昂贵路线。TSMC 的季度资料持续拆分先进节点收入占比、HPC 与智能手机平台贡献、毛利率、资本开支和未来产能规划。把这些数据与技术路线对照,可以观察 N2、A16、CoWoS 等能力是否从发布会术语变为客户订单、折旧与现金流。
阅读财报时应区分三类时间:技术“研发完成”、客户“完成设计定案”、晶圆厂“形成收入”。三者常相隔多个季度甚至数年。资本开支上升也不等于全部投入某个节点,其中包含厂房、设备预付款、成熟工艺、先进封装和海外产能。本文因此不使用单季收入去证明某项技术必然成功,而把连续季度的 HPC 占比、先进节点放量和资本强度作为需求持续性的旁证。
它对未来五年的最大启示是,先进逻辑与先进封装已经在财务层面绑定。AI 客户需要的不只是先进晶圆,还需要 HBM 可得性、封装产能和交付节奏。晶圆厂若无法同时协调这些资源,即使拥有优秀晶体管,也难以完整承接系统级需求。
文献研读十四:UCIe Consortium《Specifications》——chiplet 生态首先需要可验证的接口
UCIe 规范体系覆盖 die-to-die 物理层、协议栈、封装形态、管理与一致性映射。它的意义不是简单提供另一种高速 SerDes,而是让不同来源的 die 在电气、链路、协议与管理层面拥有共同语言。只有接口可互操作,chiplet 才可能从单一公司的内部模块化,进一步发展为可复用 IP、第三方 die、封装服务和测试工具共同组成的市场。
标准化最难的部分往往不是峰值速率,而是 corner case:链路训练、错误处理、功耗状态、热插拔式管理思想、测试访问、封装通道损耗和不同工艺 die 的时钟/电压边界。协议支持 PCIe、CXL 等生态可以降低软件迁移成本,但一致性与完整协议栈也会带来面积、延迟和功耗开销。因此高端产品可能同时使用 UCIe 与私有轻量互连,分别服务开放性和极致能效。
未来五年 UCIe 的成功指标不应只看会员数量,而应看跨厂商互操作测试、量产 PHY IP、封装设计规则、测试方法和真实多供应商产品。标准已经解决“能否对话”的第一步,供应责任、良率归属、版本兼容与商业模式仍需产业继续磨合。
文献研读十五:UCIe Consortium《UCIe 3.0 Specification》——速率翻倍之后,管理与可维护性更关键
UCIe 3.0 将数据率扩展到 48 GT/s 与 64 GT/s,覆盖标准封装与先进封装,并加入运行时重新校准、更长的 sideband reach 和增强管理能力。速率翻倍直接提高每毫米封装边缘可提供的带宽,但通道损耗、抖动、串扰、功耗和信号完整性难度也随之增加,封装材料与布线不再只是物理实现细节。
运行时重新校准尤其值得重视。多 die 系统在工作过程中会经历温度、供电和老化变化,静态出厂校准未必足以覆盖全部状态。链路若能在运行时监控并调整,就更适合规模更大、寿命更长的 AI/HPC 与服务器系统。管理能力的增强也说明 chiplet 正从“若干裸片连接起来”转向可观测、可诊断的系统。
图:die-to-die 标准的价值不止是传输数据,还在于让跨 die 系统能够训练、监控、纠错和维护。
文献研读十六:Micron《HBM4》——2.8 TB/s 背后是接口、堆叠与 base die 的共同升级
Micron HBM4 页面给出 2048-bit 接口、每 pin 超过 11.0 Gbps、单栈带宽超过 2.8 TB/s,以及 12-high 36 GB 等公开参数。相较 HBM3E,接口宽度翻倍是关键变化:HBM 通过大量低摆幅并行通道换取高带宽和较低单比特能耗,而不是像板级 SerDes 那样一味提高单通道频率。
这些参数也揭示封装压力。2048 条数据通道连同地址、控制、电源与地,需要极高互连密度;多层 DRAM die 经 TSV 堆叠在逻辑 base die 上,任何 die、TSV 或键合缺陷都会影响整栈良率。页面给出的制造流程强调已知良品筛选与堆叠后终测,说明 HBM 的成本来自 DRAM 容量、先进封装、逻辑 base die 与复杂测试的叠加。
对 AI 系统而言,2.8 TB/s 并不意味着“内存墙已消失”。若计算吞吐、上下文长度、MoE 路由和并行规模增长更快,带宽仍会被消耗;容量也可能比带宽更早成为约束。HBM4 因而是存储层次中的高速层,而不是 DDR、CXL 内存或 SSD 的替代者。未来五年的设计重点将从单纯增加 HBM 数量,扩展到数据放置、压缩、复用、重算和跨层调度。
图:HBM4 的正确位置是分层存储中的高带宽层。系统能效取决于数据在各层之间移动的次数,而不只取决于某一层的峰值规格。
文献研读十七:SK hynix《Hybrid Bonding》——从微凸点走向铜铜直接键合
SK hynix 的技术说明比较了约 100 µm 的传统焊球、约 20 µm 的 microbump 与低于 1 µm 的 Cu-Cu hybrid bonding pitch。去除凸点后,die 间距与互连电容下降,单位面积连接数上升,信号延迟、带宽密度和散热路径都可能改善。对层数持续增加的 HBM,混合键合还可以减少凸点高度,为更多 DRAM 层留出封装厚度预算。
文章同时比较 wafer-to-wafer 与 die-to-wafer。W2W 一次键合整片晶圆,吞吐高且适合超细 pitch,但上下晶圆若良率不匹配,坏 die 会相互拖累;D2W 可以挑选已知良品并组合不同尺寸 die,设备处理与对准却更复杂。选择何种流程,本质上是 pitch、吞吐、die 尺寸、良率和产品价值之间的优化问题。
SK hynix 判断混合键合在 HBM4E 或 HBM5、尤其超过 20 层的堆叠中更可能全面采用,这比把它描述成 HBM4 的统一现状更严谨。未来五年 microbump 与 hybrid bonding 将长期共存:前者拥有成熟成本和供应链,后者在层数、厚度或带宽密度越过临界点后才显示决定性优势。
文献研读十八:SK hynix《HBM4》——规格竞争最终落到可量产性
SK hynix 的 HBM4 发布资料强调开发完成、量产准备、带宽和能效改善,并把产品面向下一代 AI 平台。与 Micron 页面相互对照,可以看到行业方向高度一致:2048 I/O、更高 pin speed、更高堆叠层数、逻辑 base die 与先进封装共同演进。供应商差异则体现在 DRAM 工艺、键合方法、base die 来源、客户验证、良率与实际供货节奏。
“开发完成”不等于客户系统已经规模部署。HBM 必须通过信号完整性、功耗、热、可靠性、封装共设计和长周期压力测试,且最终规格可能因客户平台而异。对高价值 AI 加速器而言,一颗 HBM 栈的失效可能影响整个昂贵封装,所以验证严苛程度远高于普通存储器件。
这份资料与后面的 TrendForce 认证进度报道结合后,提供了一个重要方法论:厂商公告用于确认技术能力与目标,第三方供应链信息用于观察认证和放量,两者不能互相替代。未来五年 HBM 竞争的核心不是谁最早宣布,而是谁能稳定交付足够多、足够快且功耗可控的合格堆栈。
文献研读十九:SK hynix《CPO Roadmap Featured in Nature Electronics》——光互连的目标是系统带宽密度
SK hynix 对 Nature Electronics 路线图的介绍,把 CPO 的目标量化为单节点超过 100 Tb/s、能耗低于 1 pJ/bit、芯片间延迟低于 10 ns。与“光比电更快”这种笼统表述相比,这三个指标更有判断价值:带宽决定大规模加速器是否能保持并行效率,单比特能耗决定网络功耗能否随规模增长,端到端延迟则影响 collective communication 与内存语义的可用范围。
文献强调 CPO 并不是在任何距离都替代铜。短距离铜互连成本低、制造成熟且维护方便;随着速率和距离上升,均衡、重定时与 SerDes 功耗增加,光引擎靠近交换或计算 ASIC 才逐渐显示优势。因此电与光的分界会随工艺、封装和系统拓扑移动,而不会出现单一固定距离。
路线图从 2D、2.5D interposer 延伸到 3D heterogeneous stacking,说明光学引擎、激光源、调制器、探测器、控制 IC 和交换 ASIC 的集成方式仍在演化。未来五年最可信的落点是高端交换机与部分 AI scale-up/scale-out 网络;让光 I/O 深入计算封装,需要进一步解决激光耦合、热漂移、测试、维修和标准化。
文献研读二十:NVIDIA《Spectrum-X Photonics》——CPO 开始从研究路线进入系统产品
NVIDIA 的产品公告把 CPO 放入 Spectrum-X 交换平台,并给出相对于传统方案的激光数量、功耗效率、信号完整性、网络韧性和部署速度目标。它的重要性不在于厂商自报的倍数可以无条件横向比较,而在于系统供应商开始同时设计交换 ASIC、硅光引擎、网络拓扑、管理软件与 AI 集群,这标志着 CPO 正从器件论文进入可交付系统。
系统化同样放大了失效成本。传统可插拔光模块出现故障时可以单独更换,CPO 的光学部件靠近甚至进入 ASIC 封装后,现场维护单位变大;激光源寿命、光纤连接、封装热场和测试覆盖会影响整台交换设备。厂商宣称的网络韧性必须靠冗余、遥测和可维护设计兑现,不能只靠器件能效。
对芯片产业的长期影响是,网络不再是加速器之外的配套采购。模型并行和内存池化使通信效率直接决定昂贵计算 die 的利用率,交换芯片、NIC、光引擎与软件集合通信库必须共同优化。CPO 的商业化因此是“系统边界向光学移动”的证据。
文献研读二十一:OIF《EEI Interop Demo at OFC 2025》——互操作演示比单点纪录更接近产业条件
OIF 的 EEI 互操作材料比较可插拔模块、板载光学和共封装光学的链路形态,并通过多厂商演示验证电接口、连接器、线缆、模块与测试设备的协同。标准组织的价值在于把实验室中各自最优的器件放进共同接口条件,暴露连接损耗、容差、训练和测试中的实际问题。
材料提出的下一代链路目标包括约 10 m 距离内低于 5 pJ/b、约 100 m 距离内低于 10 pJ/b,以及 2-4 Tb/s/mm 的带宽密度。不同距离的能耗目标不能直接与片内或封装内互连比较,因为驱动、调制、光源和接收链的边界不同;但它们清楚显示网络能效已成为 AI 系统的一级设计指标。
图:光引擎越靠近 ASIC,高速电路径越短,但封装耦合和维护成本越高。CPO 的采用速度取决于这一组收益与代价能否闭合。
文献研读二十二:SEMI《Q2 2026 Global Semiconductor Equipment Billings》——设备支出是量产信心的滞后投票
SEMI 的 WWSEMS 数据显示,2026 年第二季度全球半导体设备销售额达到 405.3 亿美元,同比增长 23%、环比增长 11%。这类数据覆盖晶圆制造、封装与测试相关设备,是观察产能建设和工艺升级的硬指标。相比厂商宣布未来建厂,设备实际形成销售更接近资本已经落地。
但设备销售是滞后且混合的指标。一台设备从下单、交付、安装到产出合格晶圆需要较长时间,季度增长可能同时包含先进逻辑、DRAM、NAND、成熟节点、封装和区域政策驱动项目。设备支出增长能证明产业在扩张,不能单独证明某一技术路线的终端需求必然持续。
本文用它支撑的是更有限也更可靠的结论:AI 驱动的逻辑、存储和封装投资已经穿透到制造装备层,而且量测、检测、键合和测试的重要性与光刻、刻蚀同步上升。未来五年若系统复杂度继续提高,资本开支会更多流向跨环节良率控制,而不仅是增加晶圆开工量。
文献研读二十三:SEMI《Inside the EDA Growth Story and AI’s Impact》——AI 会被嵌入工具,而不是独立存在
SEMI 的访谈从产业收入与产品形态讨论 EDA。受访者指出,Cadence、Synopsys 等厂商已有单独品牌化的 AI 产品或 agent,但长期看 AI 能力会逐渐嵌入既有工具,届时很难再把“AI 收入”单独拆分。这个判断比“AI 将取代芯片工程师”更符合工程软件的演进规律:当算法稳定后,它往往成为布局、验证、仿真或调试流程中的默认功能。
EDA 是 AI 较早落地的工程软件领域,因为设计流程本来就拥有明确约束、可计算目标和大量机器生成数据。布局布线可用 PPA 评价,验证可用覆盖率和反例评价,时序、功耗、DRC 与 LVS 都能提供反馈信号。AI 适合做搜索、排序、预测和候选生成,但最终结果仍必须通过确定性工具和物理验证闭环。
这篇访谈也提醒读者不要高估公开收入数据的解释力。厂商很少披露每项 AI 功能带来的真实工程时长节省,客户案例存在选择偏差。未来五年更值得观察的是 tape-out 周期、工程师每人可管理的设计规模、验证缺陷发现率和跨项目复用,而不是生成了多少行 RTL。
图:可信的 AI EDA 必须处在可验证闭环中。模型负责扩大搜索空间,确定性检查与硅后数据负责约束错误。
文献研读二十四:SEMI《Heterogeneous Integration Roadmap》——路线图对象已经从器件扩展到系统
异构集成路线图由 SEMI 与 IEEE 多个学会及产业伙伴共同维护,覆盖未来 15 年至 25 年的系统、封装、互连、热、光电、测试、可靠性和制造挑战。它延续了传统 ITRS 的协同功能,但研究对象不再只是晶体管尺寸,而是多种器件、材料和 die 如何组成可制造系统。
路线图的意义在于识别跨行业依赖。例如 chiplet 密度提升需要更细互连 pitch,却同时要求更好的对准、失效分析和已知良品测试;功耗上升推动液冷和新型 TIM,又改变封装应力与可靠性;CPO 改善远距离通信能效,却把激光、光纤耦合和光学测试带进半导体封装流程。这些问题没有一家企业能够独立优化。
路线图不是承诺表。其时间点表示产业认为需要解决的问题和目标窗口,并不保证某项技术按期量产。本文把 HIR 用作“系统级约束清单”和跨领域共识,而将具体产品状态交给厂商资料和市场数据验证。这种分工能避免把愿景误写成事实。
文献研读二十五:WSTS《Global Semiconductor Market Approaches USD 1 Trillion in 2026》——旧预测是理解修正幅度的基线
这份较早的 WSTS 预测预计 2026 年全球半导体市场约 9,750 亿美元,同比增长超过 25%,存储与逻辑增长超过 30%。如果只看这一份资料,2026 年已经是强劲扩张年,但仍接近传统周期波动的量级。它后来被春季预测大幅上修,因此更适合作为“预测如何变化”的历史基线,而不是当前最终数字。
保留旧预测有方法论价值。行业预测不是静态真理,而是对价格、出货和需求信息的阶段性汇总;存储价格、AI 加速器交付与云厂商资本开支变化,会在几个月内显著改变名义市场规模。比较 9,750 亿美元与后续 1.51 万亿美元的差异,可以看到这轮增长很大一部分来自存储价格与 AI 基础设施的集中重估。
因此本文不把任一版本的 WSTS 数字当作五年技术趋势的充分条件。预测修正本身更值得关注:当存储对总额的贡献如此巨大,产业景气与技术进展可能出现背离,市场收入猛增并不意味着所有产品类别都同样繁荣。
文献研读二十六:WSTS《Recent News Releases》——1.51 万亿美元预测揭示的是结构分化
WSTS 2026 年春季预测把当年市场规模上调到约 1.51 万亿美元、同比增长约 90%,并预计 2027 年约 1.9 万亿美元。分项中,存储预计增长约 250%,逻辑增长约 37%,其他类别增速明显温和。由此可见,标题中的整体高增长主要由存储价格、HBM 与 AI 逻辑拉动,不是消费电子、模拟、传感器和分立器件同步翻倍。
这一结构对技术投资有直接影响。资本会优先流向 HBM、先进 DRAM、AI 加速器、先进封装与数据中心互连,相关设备与材料出现扩产;传统终端若需求温和,则更强调库存、成本与成熟节点利用率。所谓“半导体超级周期”在内部实际上由多个不同步的小周期组成。
图:总市场高增长掩盖了品类分化。技术趋势判断应看增量由谁贡献,而不是只看总额曲线。
文献研读二十七:TrendForce《TSMC Expands CoWoS Capacity》——先进封装已经成为可量化瓶颈
TrendForce 转述的供应链信息显示,TSMC CoWoS 月产能可能从 2025 年约 7 万片提高到 2026 年底的 13 万至 14 万片,NVIDIA 被报道预订 2026 年约 80 万至 85 万片,占全年能力的一半以上。数据若大致成立,说明先进封装不是晶圆完成后的边缘步骤,而是能够直接限制 AI 加速器交付量的稀缺产能。
这类报道需要谨慎使用。CoWoS“片数”可能按 interposer wafer、封装投入或不同环节统计,产品尺寸差异也会让同样一片晶圆对应不同数量的最终封装;预订不等于最终消耗,供应链来源也不是企业审计数据。因此本文把它作为产能紧张程度的区间证据,而不把单一数字当作精确产量。
更可靠的方向性结论是,扩产需要晶圆厂、OSAT、基板、interposer、HBM、测试、散热和设备共同爬坡。将部分前段步骤外包给封测伙伴,反映产业正在通过分工缓解瓶颈。未来五年先进封装竞争会同时比拼工艺和供应链组织能力。
文献研读二十八:TrendForce《HBM4 Validation Expected in 2Q26》——认证节奏决定真实供给
TrendForce 在 2026 年 2 月的分析中认为,Samsung、SK hynix 与 Micron 的 HBM4 客户验证将在第二季度进入关键节点,并分别讨论三家供应商的进度与潜在份额。它补充了厂商产品公告无法回答的问题:同样宣称“开发完成”的 HBM4,可能处在送样、认证、初始量产或稳定放量等不同阶段。
HBM 认证需要把存储 die、逻辑 base die、TSV/键合、封装通道和客户加速器放在一起验证。温度、功耗、信号完整性、长期可靠性与封装良率任何一项不满足,都可能推迟平台导入。客户还可能为不同速率、容量或功耗档建立多个料号,因此一次认证通过并不等于全系列立即放量。
这份早期预测应与后续厂商公告交叉阅读,而不能倒过来用它覆盖已经发生的事实。它对五年趋势的贡献,是揭示高端存储供给由“最慢的认证环节”决定;在 AI 芯片里,内存不再是可随时替换的标准商品,而是与计算封装共同设计的关键组件。
文献研读二十九:TrendForce《Rapidus Takes on TSMC with Aggressive 2 nm Pricing》——晶圆报价只是成本方程的一部分
报道转述供应链消息称,TSMC 2 nm 与 Intel 18A 晶圆报价约 3 万美元,而 Rapidus 目标价格可能低至约 2.1 万美元。文章本身使用“reportedly”和“if accurate”等限定,说明这些并非厂商公开价目表。先进晶圆价格通常还受订单规模、良率学习、掩模、IP、测试、长期协议和产品组合影响,不能把媒体数字当作普适成交价。
即便如此,约 3 万美元的量级仍能说明先进节点的入场门槛。一个产品的裸片成本可用简化关系理解:
其中 是晶圆相关成本, 是理论可切割 die 数, 是综合良率。die 面积越大,单片可得数量越少,随机缺陷导致的良率损失也越严重;对 AI 芯片而言,后续 HBM 与先进封装成本还可能超过逻辑 die 本身。低晶圆报价若缺少稳定良率、IP 和封装生态,未必形成更低系统成本。
这份资料因此支撑的不是“某家一定更便宜”,而是先进节点竞争已从单一 PPA 延伸到价格、良率、生态和产能可信度。未来五年,新进入者要打破代工集中度,必须同时跨过技术与客户量产风险两道门槛。
文献研读三十:TrendForce《Cloud Service Provider CapEx Forecast 2026》——资本开支是 AI 芯片需求的上游变量
TrendForce 在 2026 年的阶段性预测中把全球主要云服务商资本开支显著上调,早期口径为九家企业合计约 8,300 亿美元、同比增长约 79%,后续口径还继续调整。其价值在于把芯片需求放回数据中心投资链:只有云厂商持续购买服务器、网络、电力与建筑基础设施,GPU、ASIC、HBM 和 CPO 的订单才能兑现。
但 CapEx 不能等同于半导体采购额。它同时包含土地、建筑、供电、冷却、服务器、网络和资本化软件,不同企业的会计口径也不一致;资本开支上调还可能受到设备价格上涨和建设周期前移影响。把全部 CapEx 直接换算成 GPU 数量会严重高估芯片需求。
更稳妥的用法是观察方向与连续性:若多个 CSP 同时上调 CapEx,AI 基础设施需求具有广度;若支出从计算转向电力、冷却或网络,则说明系统瓶颈正在外移。未来五年芯片公司需要关注的不是单一客户预算,而是预算在 compute、memory、network、power 与 cooling 之间如何重新分配。
图:云资本开支通过多条路径传导到半导体。AI 扩张不仅增加计算 die,也同时拉动存储、网络、功率与散热技术。
文献研读三十一:Creative Strategies《Foundry Economics in the AI Age》——廉价晶体管时代为何结束
Ben Bajarin 的前端成本模型估算,大型单片 AI die 上每十亿晶体管的制造成本从 N5 约 5.4 美元,上升到 A16 的高个位数至低两位数美元区间;模型还强调先进 fab 的资本强度显著上升。它挑战了摩尔定律长期隐含的经济前提:密度继续增加,并不保证每个晶体管继续变便宜。
模型结果依赖晶圆价格、die 面积、缺陷密度、良率、晶体管计数和折旧假设,因此不应把 5.4 美元或 11 美元理解为会计意义上的统一成本。尤其不同架构中 SRAM、逻辑、模拟和 I/O 密度差异很大,“晶体管数量”本身也可能来自估算。不过,只要 EUV 层数、设备投入、工艺复杂度和设计成本上升的方向成立,经济拐点的结论就具有稳健性。
这正是 chiplet 与异构集成的经济基础。把对密度敏感的计算放在先进节点,把 I/O、模拟、缓存或管理功能放在更成熟工艺,可以减少昂贵先进晶圆面积;设计复用还能摊薄验证成本。但 chiplet 增加封装、测试和通信成本,只有系统总成本下降时才成立。未来五年最优设计会越来越像成本函数的联合优化,而不是“能上最新节点就全部上”。
文献研读三十二:Epoch AI《AI Chip Component Costs》——HBM 已成为成本中心
Epoch AI 对主要 AI 芯片采购的估算显示,HBM 在组件成本中的占比从 2024 年第一季度约 52% 上升到 2025 年第四季度约 63%,同期逻辑 die 约为 13%-14%,先进封装约 15%。文献还给出不确定性区间,提醒读者这些数字来自价格、配置和采购量模型,而不是厂商公开 BOM。
即使考虑误差,“存储成本显著高于逻辑 die”这一结构仍有解释力。AI 加速器的价值链从单纯追逐最大计算 die,转向争夺 HBM 产能、封装位置、base die、测试和供应协议。系统设计中每增加一组 HBM,不只增加存储采购,还扩大 interposer、封装基板、供电和散热需求。
这组数据也解释了为什么算法优化会反馈到芯片经济性。量化、稀疏化、KV cache 压缩、prefix reuse、投机解码和更好的调度如果能减少所需 HBM 容量或带宽,节省的可能是系统中最大的单项组件成本。未来五年,软硬件协同的价值会越来越多地以“少用多少昂贵数据移动”衡量。
图:该比例是 Epoch AI 的模型中心估计,不是所有 AI 芯片的统一 BOM。它用于展示成本重心已经向存储移动,不能替代具体产品成本核算。
文献研读三十三:Epoch AI《Chip Performance per Dollar》——系统性改进仍在延续“经济摩尔定律”
Epoch AI 估算,自 2023 年以来,每季度采购的 AI 芯片按固定币值计算,其平均每美元性能以约 49% 的年均速度提高,约 1.7 年翻一倍。增长并非平滑发生,而是在新一代芯片成为采购主力时阶跃式提升。这与“每晶体管成本上升”并不矛盾,因为产品性价比还能由架构、低精度计算、HBM、封装、软件和规模采购共同改善。
指标边界必须说明。AI“性能”可能按不同精度的峰值算力或模型相关吞吐估算,采购价格也受到合同、整机配置和供应紧张影响;把不同代产品压缩成单一指数,会掩盖内存容量、互连、可靠性与软件可用性的差异。49% 是描述既有采购结构的统计趋势,不是保证未来每年复制的自然定律。
它对本文核心论点的支持在于:传统单位晶体管经济性减弱后,系统级性价比仍可快速增长。未来五年若这种趋势继续,主要贡献将来自多维协同,而不是单一光刻缩放。衡量摩尔定律是否“继续”,应该观察单位成本可交付的有效工作量,而非只观察晶体管价格。
文献研读三十四:JEDEC《High Bandwidth Memory Standards》——开放标准让 HBM 不止属于单一客户
JEDEC 的 HBM 标准规定接口宽度、通道组织、信号、电气、封装与功能要求,使内存供应商、逻辑芯片厂、IP 厂商、封装厂和测试设备能够围绕共同基线开发。HBM4 将接口扩展到 2048 bit,标准化可以降低控制器与 PHY 的重复开发,也让不同供应商进入客户验证体系。
标准定义兼容边界,却不抹平产品差异。供应商仍会在 pin speed、容量、堆叠层数、功耗、base die 工艺、封装方法、热表现和良率上竞争;客户也可能在 JEDEC 基线之上提出定制要求。标准版本发布与量产产品出现之间还存在设计、认证和产能爬坡周期。
未来五年 JEDEC 的作用会进一步向系统协同延伸。HBM 与 logic die 的关系越紧密,标准就越需要考虑测试、维修、RAS 能力和生态接口。开放标准降低的是协调成本,不是物理难度;它使多供应商竞争成为可能,却不能自动解决 HBM 供给集中和先进封装瓶颈。
文献研读三十五:IEEE IRDS《International Roadmap for Devices and Systems》——“系统”已写进路线图名称
IRDS 接续 ITRS,但把路线图从单纯的 semiconductor technology 扩展到 devices and systems,设立系统集成、More Moore、Beyond CMOS、封装、存储、互连、工厂集成、量测和环境安全等多个方向。名称变化本身反映产业共识:器件缩放仍重要,却必须在应用驱动和系统约束中讨论。
路线图的最大价值是给不同参与者提供共同时间尺度。材料研究者可以看到未来接触电阻和沟道厚度需求,设备厂商可以提前规划量测与加工能力,设计工具厂商可以准备新的器件模型和 3D 分析,系统公司则能评估哪些技术可能进入产品窗口。没有这种协调,任何单点突破都可能因为上下游缺位而停在实验室。
IRDS 同样不是预测市场赢家的水晶球。路线图目标往往具有挑战性,技术之间可能相互替代,商业化时间会受成本与需求改变。本文使用它确认长期问题集合,而不把每个节点时间当成确定承诺。对 2026-2031 年而言,最稳健的读法是:GAA、背面供电、3D 集成和异构系统已进入共同路线;CFET、二维材料和更激进的单片 3D 仍需要跨越较长工程化距离。
综合文献结论:未来五年的确定项、条件项与观察项
逐篇研读后,可以把前沿技术分成三个证据层级。第一类是确定项:GAA nanosheet、先进 2.5D 封装、HBM4、chiplet 接口、AI 辅助 EDA 和制造自动化已经拥有产品、标准、设备投入或明确量产活动,未来五年的问题主要是放量速度、成本与份额,而不是是否存在。
第二类是条件项:背面供电、混合键合、CPO、CXL 内存池与更大规模 3D 堆叠已经跨过原理验证,但能否普及取决于良率、热、可维护性、客户验证与生态。它们会在高价值场景率先成立,却未必在五年内成为所有芯片的默认配置。
第三类是观察项:CFET、二维沟道、单片 3D 逻辑和更深入的片上光互连具有清楚的物理动机,也已进入路线图与试验线,但距离广泛商业化仍有材料一致性、热预算、接触、对准和设计工具等多重障碍。把这些技术写入五年趋势是为了识别研发方向,而不是宣布它们即将全面量产。
最终结论没有因为材料增多而改变,反而变得更明确:未来五年不是某一项“神奇技术”接管产业,而是先进逻辑、供电、存储、互连、封装、自动化和供应链同时逼近各自边界。领先者的优势将来自把这些边界组织成一个能量产、能散热、能验证、能交付且成本可闭合的系统。
参考资料
- ASML: EUV lithography systems
- ASML: The Rayleigh criterion for resolution
- Intel Foundry: Intel 18A process
- Intel Foundry Technology Brief: Intel 18A Process Node Family
- imec: How to power chips from the backside
- imec: A path to high-density front- and backside wafer connectivity
- imec: Putting complementary FET (CFET) logic technology on the roadmap
- imec: Introducing 2D-material based devices in the logic scaling roadmap
- imec: Entering the nanosheet transistor era
- TSMC: Advanced Packaging Services
- TSMC 3DFabric: CoWoS
- TSMC 3DFabric: TSMC-SoIC in depth
- TSMC Investor Relations: Quarterly Results
- UCIe Consortium: Specifications
- UCIe Consortium: UCIe 3.0 Specification
- Micron: HBM4
- SK hynix: Hybrid Bonding, Evolving into a Foundational Technology
- SK hynix: HBM4
- SK hynix: CPO roadmap featured in Nature Electronics
- NVIDIA: Spectrum-X co-packaged optics networking switches
- OIF: EEI Interop Demo at OFC 2025
- SEMI: Global Semiconductor Equipment Billings Increased 23 Percent Year-Over-Year in Q2 2026
- SEMI: Inside the EDA Growth Story and AI’s Impact
- SEMI: Heterogeneous Integration Roadmap
- WSTS: Global Semiconductor Market Approaches USD 1 Trillion in 2026
- WSTS: Recent News Releases
- TrendForce: TSMC expands CoWoS capacity amid rising AI demand
- TrendForce: HBM4 certification and production schedule
- TrendForce: 2nm wafer pricing report
- TrendForce: Cloud service provider capex forecast 2026
- Creative Strategies: Foundry Economics in the AI Age
- Epoch AI: AI chip component cost shares
- Epoch AI: Chip performance per dollar
- JEDEC: High Bandwidth Memory standards
- IEEE IRDS: International Roadmap for Devices and Systems
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



