


扩散模型从零讲起(十九):一次请求的完整推理链路——从收到 prompt 到放出图像,diffusion pipeline 的每一块都在干什么
写在前面:这一篇在系列里的位置
前十篇从数学和算法侧把扩散模型讲完了:DDPM 的前向/反向链、DDIM 的确定性轨迹、分数与 SDE 视角、Flow Matching 的直线路径、采样器、蒸馏、架构演进、条件与文本编码、离散扩散与 dLLM。第八篇(推理加速工程)已经算过一次延迟账,第十三篇(引导)算过 CFG 的前向次数,第四篇(潜空间)算过 VAE 与 sigma shift 的成本。
这一篇换一个视角:不再把”扩散模型”当作一个数学对象,而是把它当作一条线上服务里的流水线。用户发送一个 prompt,到浏览器里出现一张图,中间经过哪些模块、每个模块读什么写什么、哪一段是时间大头、哪一段可以重叠、哪一段最容易成为瓶颈。第八篇关心的是”每个模块内部有什么加速手法”,这一篇关心的是”模块之间如何串起来,串起来之后时间如何分布”。
如果只用一句话概括这一篇要建立的概念,那就是:
扩散模型的推理不是”一次前向”,而是一串对同一个小张量反复施加的去噪步骤,前后各挂着一个编码器和一个解码器;“扩散推理服务”要处理的,正是这串步骤与两个端点上挂件的资源矛盾。
理解这条链路之后,很多工程上的反常现象就能解释了:为什么 4 步蒸馏之后 GPU 利用率反而下降;为什么同一个模型在不同分辨率下延迟不是线性增长;为什么把两个请求拼进一个 batch 有时反而更慢;为什么并行扩散看起来”理论上应该加速好几倍”,实测却常常只有 1.3 倍。
一、一次 txt2img 请求到底经过哪些环节
先看一个实际的文本生图(text-to-image,txt2img)请求。以 Flux 系列为例,模型本身由四块组成:文本编码器(T5-XXL,可选补一个 CLIP 文本编码器)、一个潜空间自编码器(VAE)的编码端与解码端、一个 DiT 主干、一个采样器(scheduler)。一次请求大致按下面顺序推进:
- 请求接收:HTTP 入口解析参数(prompt、尺寸、步数、seed、引导强度),校验尺寸与步数是否在模型允许范围内,生成请求 ID,放进队列;
- 参数规范化:把 prompt 与负向 prompt 拼接、分桶(同一 batch 的请求必须共享分辨率与采样器),决定 seed 与确定性采样模式;
- 文本编码:tokenize 后过一次 T5 编码器,得到形如 的文本嵌入,作为整个采样循环的条件;
- 潜空间初始化:从高斯噪声采样一个 的潜空间张量(Flux 的 VAE 下采样倍率为 8),这就是采样的起点;
- 采样循环:按 scheduler 给出的时间步 ,每一步把当前潜变量 与文本条件一起送进 DiT,得到预测(噪声、速度或 ),再由 scheduler 算出 ;
- (可选)image-to-image 路径:如果输入了一张图,先过 VAE 编码端得到潜变量,再按 sigma/strength 加噪作为起点;
- VAE 解码:采样结束的 经过 VAE 解码端还原成像素张量,格式化为 PNG/WebP;
- 响应回传:图片编码为字节流,写回 HTTP 响应或对象存储,释放该请求占用的显存。
TridentServe 论文(2025 年 10 月发表于 arXiv)把这条链路概括成 encode–diffuse–decode 三段,并给出了下面的结构图。图里把三个阶段画成并排的三块:左侧是 prompt 与 tokenizer 进入文本编码器,中间是”低维潜空间”里的扩散模型反复迭代,右侧是像素空间里的解码。
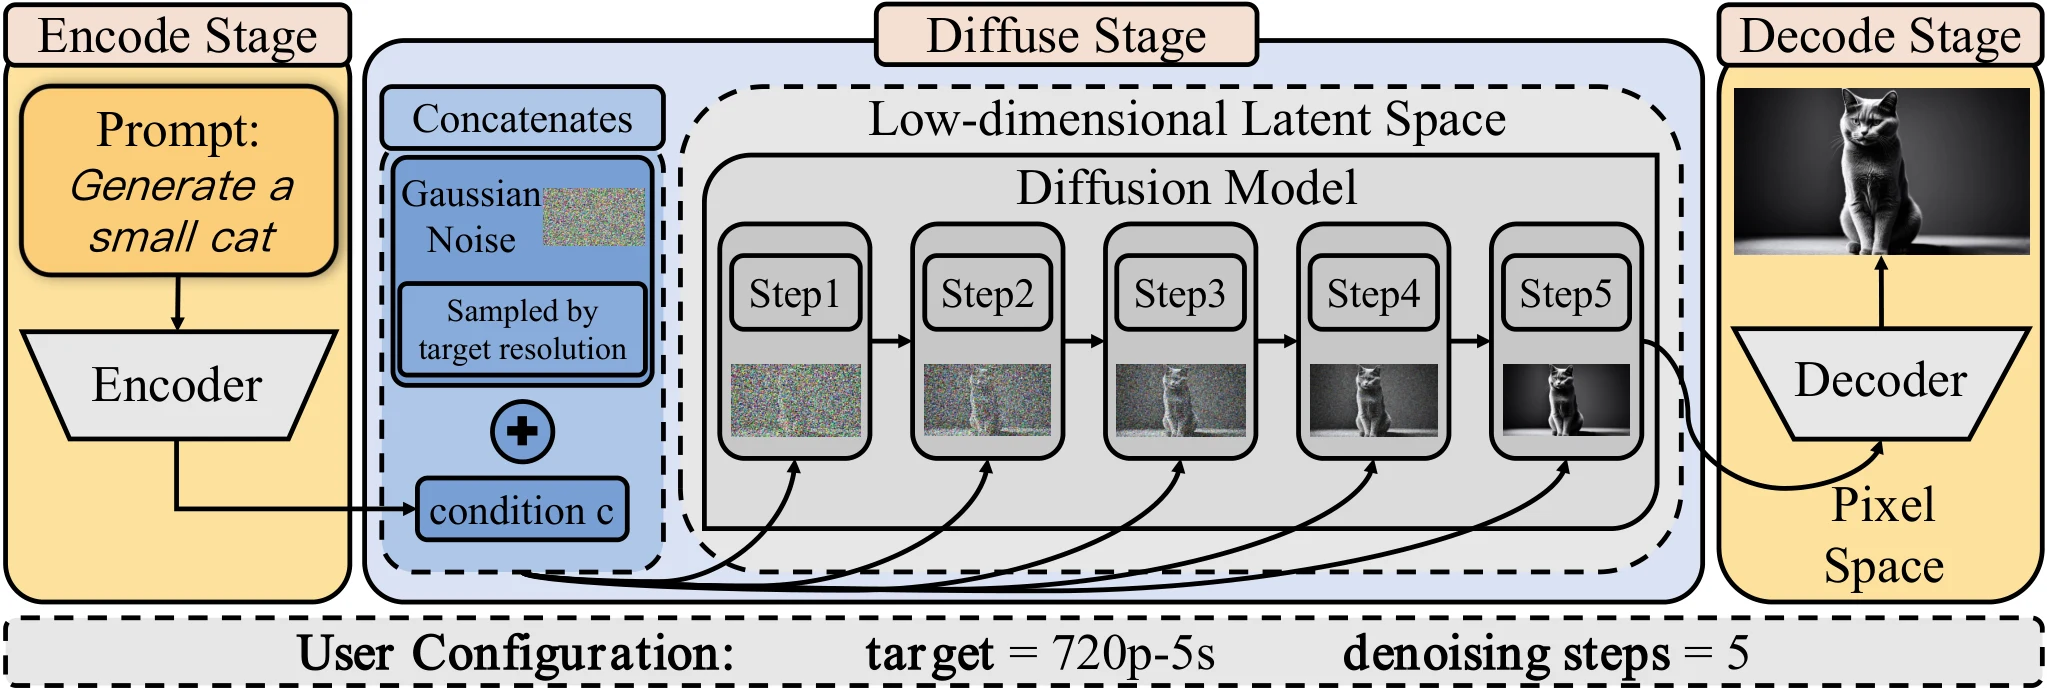
这张图值得逐块读。最左边是用户输入(prompt 与用户配置,例如目标分辨率 720p、去噪步数 5);接着 prompt 被编码成条件张量;中间的”低维潜空间”部分画了很多个方块——每一个方块对应一次完整的 DiT 前向,方块之间用箭头串起来,表示”上一步的输出是下一步的输入”;最右边是解码器,把潜空间里的结果展开成像素。读这张图要抓住两点:第一,中间那串迭代是整个流程里唯一被”重复执行”的部分,编码器和解码器各只执行一次;第二,迭代的每一步都是全图计算,没有”逐词生成”那种可以增量追加的结构。这两点决定了扩散服务与语言模型服务在资源分配上的根本差异。
下文的分节基本按照这条链路走,但会补上两个语言模型服务里不存在的现象:一是三段对资源的需求完全不同(编码器和解码器偏访存、扩散阶段偏算力),二是同一阶段的请求成本在准入时无法精确预知(步数、分辨率、模型都可能不同,而扩散阶段每一步的耗时还取决于 GPU 当时的负载)。
二、请求接收:队列、准入与参数规范化
2.1 入口层要做什么,以及为什么它比 LLM 入口更啰嗦
从 HTTP 请求进入,到它被允许占用 GPU,中间隔着一层”请求接收”。语言模型的入口相对简单:prompt 长度决定 prefill 成本,max_tokens 决定 decode 上限,二者相加就是一次请求的成本上界,准入时算得出来。扩散模型不行:一次请求的成本取决于分辨率、步数、引导强度、模型版本、是否启用缓存,以及采样过程中 GPU 的实际负载;这些信息在准入时只能估,不能精确算。
这一层通常包含以下动作:
- 鉴权与限流:按 API key 或租户计配额。扩散请求的单价高、GPU 占用时间长,限流粒度往往按”并发请求数”或”GPU 秒”而不是按 token;
- 参数校验与规范化:尺寸必须是 VAE 下采样倍率的整数倍(Flux 是 8,SD 系列也是 8),很多实现还要求是 16 或 64 的倍数,以便 patch 并行与分块解码;步数通常限制在 1 到 50;引导强度限制在合理区间,防止数值溢出;seed 必须在 64 位以内;
- 请求 ID 与幂等:重复提交同一个请求(客户端重试)不应重复计费,也不应产生两张不同的图。常见做法是把
(prompt, negative_prompt, seed, size, steps, guidance, model_version)规范化后哈希成幂等键; - 超时与取消:扩散生成是长任务,客户端断开、用户点”取消”、上游网关超时都要能传到 worker。由于采样循环不可中断到”半个 token”,取消只能在步边界生效:worker 每完成一步检查一次取消标志,命中就丢弃该请求的潜变量与缓存,不进入下一步;
- 参数分桶:相同分辨率的请求才能进同一个 batch;不同分辨率要么分桶排队,要么拆成 patch 单独调度(PatchedServe 走的就是后者)。
2.2 准入:为什么扩散服务需要”预测”而不是”计算”
设一个请求的分辨率为 、步数为 、引导强度 。在最简单的实现里,它的前向次数是
而单步前向的耗时并不是常数:它随 增长、随 batch 大小变化、随 GPU 是否被其他请求占满而漂移。于是”准入时预测这个请求要占多久”变成一个回归问题,而不是一个算术问题。PatchedServe(2025 年 1 月发表于 arXiv)的做法是维护一个轻量的在线延迟预测器,用历史执行数据估计当前负载下某个 组合的完成时间,再配合 SLO 感知的调度策略决定”现在放它进来,还是让它再等一会儿”。论文报告在混合分辨率负载下,SLO 满足率比当时的 SOTA 扩散服务系统高 30.1%。
这个数字背后是一个结构性事实:扩散请求的成本对参数极其敏感,而参数又是用户给的。一个 1024×1024、50 步、CFG 7.5 的请求,前向次数是 100 次;一个 512×512、20 步、CFG 3.5 的请求是 40 次,单次前向的 FLOPs 还只有前者的约四分之一。两者相差一个数量级,却可能排在同一个队列里。准入层如果只按”请求数”公平排队,短请求会被长请求堵死,尾延迟完全失控。
2.3 请求状态:一个请求要携带哪些东西
走到采样循环时,每个请求都携带一份状态。它比 LLM 的一个序列状态更零碎,因为里面既有连续张量,也有采样器的标量历史:
| 状态 | 典型形状/类型 | 生命周期 | 说明 |
|---|---|---|---|
| 当前潜变量 | ,FP16/BF16 | 整个采样循环 | 每步被覆盖,是显存占用的主体之一 |
| 文本条件 | 整个采样循环 | 与 一起进 cross-attention | |
| 负向条件 | 同上 | CFG 时整个循环 | 可以与 拼成一个 batch 走一次前向 |
| scheduler 状态 | 时间步序列、 表 | 整个循环 | 有些采样器还要保存上一步的输出 |
| 随机数状态 | RNG state | 整个循环 | 随机采样器每步都要用;确定性采样器不需要 |
| 跨步缓存 | 若干中间特征图 | 可选的若干步 | TeaCache/DeepCache 一类方法的状态,逐请求不同 |
| 请求元数据 | 参数、租户、截止时间 | 整个循环 | 调度与计费用 |
这张表解释了一个容易忽略的工程点:扩散请求的”上下文”不是一个可以统一分页管理的 KV 缓存,而是一组生命周期各异的状态。Xema(2026 年 7 月发表于 arXiv)正是抓住这一点:它先离线追踪每个请求模板的张量生命周期,找出显存压力真正紧张的时间区间,只在那些区间内、只按需要的量做卸载或分片,并为生命周期可预测的张量建立静态内存布局,减少碎片。论文在 Flux.2、CogVideoX-5B 与 LTX-2 上报告 SLO 满足率最高提升 3.7 倍,离线规划耗时从网格搜索的 6.3 小时降到 197 秒。
三、文本编码:条件是怎么变成张量的
3.1 编码器在管线里扮演什么角色
文本编码器的任务只有一句话:把 token 序列变成一个矩阵,供采样循环里的注意力层读取。以 T5-XXL 为例,输入是 token id 序列,输出是
其中 是 token 数(T5 常见上限 512), 是编码器隐藏维度。这个矩阵在采样循环里被投影成 cross-attention 的 key 与 value:
每一层注意力都有自己的 ,所以严格说,编码器输出 之后,每层还要各做一次线性投影。工程上有些实现会把这些投影提前算好并缓存,有些则在每步前向里边算边用;前者省算力但占显存,后者相反。
在 MMDiT 这类双流结构里,文本 token 与图像 token 不是”条件与被条件”的关系,而是拼接成一条序列一起做注意力。这时编码器输出的 会与图像 token 的嵌入拼成 ,注意力矩阵的形状随之变成 。这一点直接决定了文本长度对单步成本的影响:在 cross-attention 结构里,文本长度只影响 KV 的宽度;在拼接式双流结构里,文本长度会进入二次复杂度的序列维度。第(十六)篇讨论过 77 token 上限与组合性失败,这里补上它在系统侧的另一面:文本越长,单步注意力的开销越大,而这一步要被重复 次。
3.2 成本结构:一次编码, 次复用
文本编码的成本有三个特征:
- 与采样步数无关:无论 4 步还是 50 步,编码只做一次。第(七)篇讲过,少步蒸馏之后瓶颈会转移到采样之外,文本编码就是其中最大的一块;
- 参数量大:Flux 用的 T5-XXL 约 47 亿参数,BF16 权重约 9.4 GB。它比很多 DiT 主干小不了多少,常驻显存是一笔实打实的开销;
- 可缓存:同一个 prompt 的编码结果是确定性的(在固定模型、固定精度、固定 tokenizer 版本下),可以按规范化后的 prompt 哈希缓存。
用一个数量级估算:在 A100 上,T5-XXL 编码 512 token 的耗时大约在几十毫秒量级;而 25 步、1024×1024、CFG 开启的采样循环,在 BF16 下是数十秒量级。也就是说,文本编码通常只占端到端延迟的百分之几。但少步模型会改变这个比例:4 步蒸馏把采样压到 1 到 2 秒之后,几十毫秒的编码就从”可忽略”变成”占比可观”,再叠加 VAE 解码,固定开销可能超过一半。
这也解释了为什么生产服务普遍把”文本嵌入缓存”当作第一优先级的优化:它的收益不依赖模型结构,不损失质量,而且对”同一 prompt 换 seed 批量出图”这类场景命中率极高。缓存键通常要把模型版本、tokenizer 版本、最大长度、是否开启 prompt 加权都包含进去——少一个字段,就会出现”换了模型却命中旧嵌入”的静默错误。
3.3 三个容易踩的坑
坑一:padding 浪费。 一个 batch 里的 prompt 长度不同,tokenizer 会把它们 pad 到同一长度。如果 batch 里混进一个 512 token 的长 prompt,其余 20 token 的短 prompt 也要按 512 计算,编码器的算力大部分花在 padding 上。工程上的做法是按长度分桶,或者用变长注意力的编码器实现。这个坑在 LLM 服务里也存在(prefill 的 padding),但扩散服务里更隐蔽:编码只做一次,profiler 里往往只看到”编码 30 ms”,看不到其中 28 ms 在算 pad token。
坑二:负向 prompt 的重复编码。 CFG 需要条件与无条件两路。如果负向 prompt 为空,无条件分支的嵌入是固定的,可以只算一次并常驻;如果负向 prompt 每个请求都不同,就要多一次编码。很多实现把两路拼成一个 batch 一次前向算完,这比串行两次快,但要求两路长度对齐,否则又回到 padding 问题。
坑三:编码器与主干的显存争抢。 T5-XXL 常驻要 9 GB 以上,和 DiT 同时常驻很容易把 24 GB 卡撑爆。常见做法是”编码完就卸载”:把编码器权重换出到 CPU 内存,采样循环期间显存只留 DiT。代价是下一个请求到来时要重新换入,换入时间可能比编码本身还长。更精细的做法是把编码器放在单独的 GPU 或单独的进程里,形成”编码服务 + 扩散服务”的两级结构;TridentServe 的 stage-level 部署就是把 encode、diffuse、decode 三段分别放置、分别扩缩容的思想。
四、采样循环:管线的核心,也是最容易被误解的部分
4.1 一步到底做了什么
把采样循环写成伪代码,一步只有四件事:
for t in reversed(timesteps): # t_N ... t_1 eps = model(x_t, t, c) # DiT 前向,读 x_t 与文本条件 x_{t-1} = scheduler_step(eps, x_t, t, t-1)真正复杂的是第二行的 model 与第三行的 scheduler_step。model 在不同参数化下输出的含义不同:噪声预测输出 , 预测输出 ,速度预测输出 。scheduler_step 要按当前采样器的公式把它们换算成下一步的潜变量。以 DDPM 的后验采样为例:
其中 由 反解:
这两条式子说明了一件对系统设计很关键的事:模型的输出不是最终结果,而是”告诉 scheduler 往哪走”的一个中间量。每一步都要把 和模型输出一起喂给 scheduler,scheduler 再算出 。所以采样循环的状态不只包括 ,还包括 sampler 自己的历史(二阶多步法要保存上一步的模型输出)。这也意味着:换采样器不是换一个函数调用,而是换一套状态机;服务端如果允许用户按请求指定采样器,就不能假定所有请求共享同一套循环结构。
DDIM 的确定性更新则去掉随机项,写成
它就是”先估 ,再按新的噪声水平重新混入噪声”。Flow Matching / rectified flow 的 Euler 更新更直接。若把 定义为沿 增大方向(指向噪声)的速度场,采样是从 往 反向积分,于是
其中 是步长。三种写法看起来差别很大,但在系统侧它们是同一件事:一次网络前向 + 一次逐元素的张量更新。前向占绝对大头,更新只占很小一部分算力,却决定了采样器的数值稳定性和步数下限。
4.2 CFG 让每一步变成两次前向
分类器无关引导(classifier-free guidance,CFG)的公式是
其中 表示空条件, 是引导强度。它要求同一步里做两次前向:一次带条件,一次不带。工程上有两种实现:
- 串行两路:先算条件分支,再算无条件分支,显存占用小,但延迟翻倍;
- 拼 batch 一次前向:把 拼成一个 batch,一次前向同时得到两路输出。延迟接近单路的两倍(因为计算量翻倍),但省掉一次 kernel 启动与一次调度开销,实际比串行略快。
在 GPU 上,两种实现的总 FLOPs 相同,差别只在 kernel 效率与显存峰值。这就是为什么”CFG 免费”是一种误解:它不免费,它把每一步的成本乘以二。第(十三)篇讲过引导蒸馏可以把第二次前向省掉,那是另一条路:训练一个小模型直接输出引导后的结果,推理时只做一次前向。
对服务系统而言,CFG 还有一个调度上的后果:同一个 batch 里的请求必须共享”是否开 CFG”这个属性。开与不开的请求混在一个 batch 里,要么统一按两路算(浪费),要么拆成两个 batch(增加调度开销)。生产系统通常把 guidance_scale 作为分桶键的一部分。
4.3 为什么扩散的 batch 效率不如 LLM
LLM 服务里,batch 越大吞吐越高,因为 decode 阶段是访存瓶颈:权重只读一次,却可以服务很多条序列,batch 增大几乎不增加单步延迟。扩散不是这样。FlashDiff 论文(2026 年 7 月发表于 arXiv)的 Figure 2 给出的观察是:扩散在很小的潜空间尺寸上就已经把 GPU 打满,是计算瓶颈而不是访存瓶颈。这意味着 batch 增大时,单步延迟近似线性增长,吞吐收益主要来自”摊薄固定开销”(kernel 启动、调度、Python 循环),而不是来自”复用权重读取”。
具体估算一下。DiT 每处理一个 token 的前向 FLOPs 约为 ( 为参数量)。要注意 DiT 的 patch 是在潜空间上切的,不是在像素上:1024×1024 的图经 8 倍下采样得到 的潜空间,patch size 取 2 时得到 个 token。按 估算,单次前向约
即约 98 TFLOPs。25 步、CFG 开启就是 50 次前向,约 4.9 PFLOPs。H100 的 BF16 稠密算力约 1 PFLOP/s,实际利用率按 50% 算,约 10 秒;4090 的 BF16 稠密算力约 165 TFLOP/s,按 50% 算约 60 秒。这与第八篇引用的 SVDQuant 实测(4090 上 BF16 端到端 111.7 秒)在同一数量级,差额来自注意力、VAE 与固定开销。
这个估算说明:扩散的单步成本主要由”token 数 × 参数量”决定,batch 只是把 token 数按 batch 维叠加。所以 batch=4 时,单步时间大致是 batch=1 的 4 倍(略有摊薄),而不是 LLM 里那种”几乎不变”。这直接改变了调度策略:LLM 追求”尽量大的 batch”,扩散追求”在延迟约束下把 batch 填到刚好”;盲目堆 batch 只会让尾延迟变差。
4.4 步边界:扩散服务唯一可靠的调度点
LLM 的连续批处理可以在 token 边界插入新请求,因为每一步只生成一个 token,序列之间互不干扰。扩散的最小调度单位是”一步”:一步之内所有请求共享同一次前向,无法插入或退出。于是调度器只能在步边界做决定:
- 当前 batch 走完一步后,检查是否有请求完成(走到 )、被取消、或超时;
- 把完成的请求移出,释放其潜变量与缓存;
- 检查队列里是否有同分辨率、同采样器、同 CFG 配置的请求可以加入;
- 重新组 batch,必要时重新捕获 CUDA Graph。
这套流程与 LLM 的 continuous batching 神似,但约束更强:新加入的请求必须与 batch 内所有请求处于同一个时间步。如果一个 50 步的请求和一个 4 步的请求同批,前者走到第 5 步时后者已经结束,batch 就出现空位;空位不能随便填,因为新请求得从自己的 开始,而 batch 当前在 。常见处理是”按步数分桶”:4 步、8 步、20 步、50 步各走各的队列,桶内再按分辨率分。这也是为什么生产系统里”步数”往往被限制为几个离散档位,而不是任意整数。
TridentServe 的 Figure 2 用一张示意图对比了不同的服务方式:在 pipeline-level 的静态部署里,三个请求的 diffuse 阶段需求分别是 3、2、1 份资源,但系统给每个请求分配同样的资源,于是需求 1 的请求浪费了 2 份,需求 3 的请求又不够用。stage-level 的动态部署则按每个请求、每个阶段的真实需求分配。这个例子虽然简化,却点出了扩散服务的核心矛盾:请求之间、阶段之间的资源需求差异很大,而静态分配只能取一个折中值。
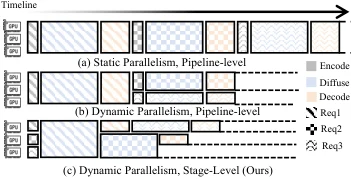
图里三行对应三个请求,每一行被分成 encode、diffuse、decode 三段,格子的宽度代表分配到的资源量。静态方案里三行的 diffuse 段宽度一致,所以需求小的请求出现空白、需求大的请求被挤压;动态方案里格子宽度跟着需求走。把它与前面”batch 内必须同步、调度只能在步边界”的约束放在一起看,就能理解为什么扩散服务需要按阶段、按请求分别配置资源,而不是给每个模型副本一份固定配额。
4.5 采样循环里的缓存:为什么它让 batch 变得不整齐
第八篇讲过跨步缓存(TeaCache、DeepCache、FBCache)的原理:相邻去噪步的输出高度相似,可以跳过某些步的完整前向,复用上一步的特征。放到服务系统里,它带来一个 LLM 里没有的问题:同一个 batch 里的请求,缓存命中情况不同。
- 请求 A 在第 7 步命中了缓存,只需要算一个轻量分支;
- 请求 B 没命中,要走完整前向;
- 请求 C 用的缓存阈值不同,命中的步也不同。
这时 batch 无法”一起走一次前向”。可选方案有三种:一是按”是否需要完整前向”把请求拆成两个子 batch,分别计算;二是整批按最保守的请求一起算,牺牲吞吐换实现简单;三是把缓存判断下沉到 kernel 内部,用掩码控制哪些 token/通道走完整计算。FlashDiff 走的是更激进的一条:它按潜空间区域(patch)调度,不同区域可以有不同的计算量,用优先队列管理 patch 任务,允许高优先级 patch 抢占低优先级 patch。论文的 Figure 10 把这种调度器画成一个”patch 单任务队列 + 优先级抢占”的结构。
缓存带来的另一个系统性后果是尾延迟的方差变大:命中缓存的请求走得快,没命中的走得慢,同一批请求的完成时间被拉开。调度器如果按”平均步时”估计完成时间,就会在缓存命中率波动时频繁误判。生产环境里的做法通常是给缓存命中率设一个下界,低于下界就关闭该请求的缓存,回到均匀步时。
五、VAE 解码:潜空间回到像素
5.1 解码器为什么常常是显存峰值所在
采样结束后,潜变量 还是一个 的小张量。以 Flux 为例,,1024×1024 的图对应 ,FP16 下约 0.5 MB。它要经过 VAE 解码器还原成 的像素张量,FP16 下约 6 MB。看起来都不大,但解码器的中间激活远大于输入输出:上采样层会逐级把特征图放大,每一级都要保存激活用于卷积/归一化,峰值常常是采样阶段的数倍。
这解释了一个反直觉的现象:有些配置下,OOM 发生在最后一步解码,而不是采样循环中间。第八篇提到过”解码的显存峰值往往高于采样阶段本身”,原因就在这里。工程上的应对手段有三类:
- 分块解码(tiling):把潜空间切成带重叠的小块,逐块解码再拼接。显存峰值随块大小而不是全图大小增长;重叠区用来消除接缝,代价是边缘重复计算。Flux 与 SDXL 的 pipeline 都提供该选项;
- 轻量解码器:TAESD 一类的小型自编码器只有几百万参数,解码延迟降到毫秒级,代价是细节与文字渲染质量下降。它适合做”预览图”,让用户在完整解码前先看到构图;
- 解码与下一请求重叠:解码是纯前馈、不依赖采样循环的后续步骤,可以和下一个请求的采样并行,用两条 CUDA stream 交替。
5.2 解码的三个数值细节
细节一:潜变量的缩放系数。 VAE 训练时通常会对潜变量做缩放,解码前要乘回 scaling_factor(SD 系列约 0.18215,Flux 系列不同)。如果漏掉这一步,解码器看到的输入尺度不对,输出会是一片灰或严重偏色。这个错误在自研管线里很常见,因为它不会报错,只会”图很丑”。
细节二:VAE 的精度。 SDXL 曾有一个著名问题:VAE 在 FP16 下数值溢出,解码出黑图或 NaN,需要把 VAE 强制转成 FP32 或使用修复版权重。原因是解码器中间层的激活值超出了 FP16 的表示范围。系统侧的教训是:不要把”整个 pipeline 用 FP16”当成一条无脑规则,VAE 往往需要单独指定精度;量化 DiT 时也要确认 VAE 没有被一起量化。
细节三:分块接缝。 tiling 的重叠区如果小于解码器的感受野,拼接处会出现网格状接缝或亮度跳变。重叠区大小的选择与解码器的卷积核、上采样倍数有关,不能拍一个”64 像素”了事。上线前要用含细密纹理、人脸、文字的难例做对比,LPIPS 对纹理退化敏感,但对文字错误不敏感,单一指标不够。
5.3 Xema 的视角:把生命周期可预测的张量”排好队”
Xema 的出发点不是”解码器慢”,而是”显存管理粗放导致解码阶段过早 OOM”。它先离线追踪一个请求模板的完整张量生命周期,标出哪些时间段显存压力最大;然后只在压力区间内做卸载/分片,并且只按”刚好能装进目标 GPU 预算”的量做;最后为生命周期可预测的张量建立静态布局,减少动态分配带来的碎片。
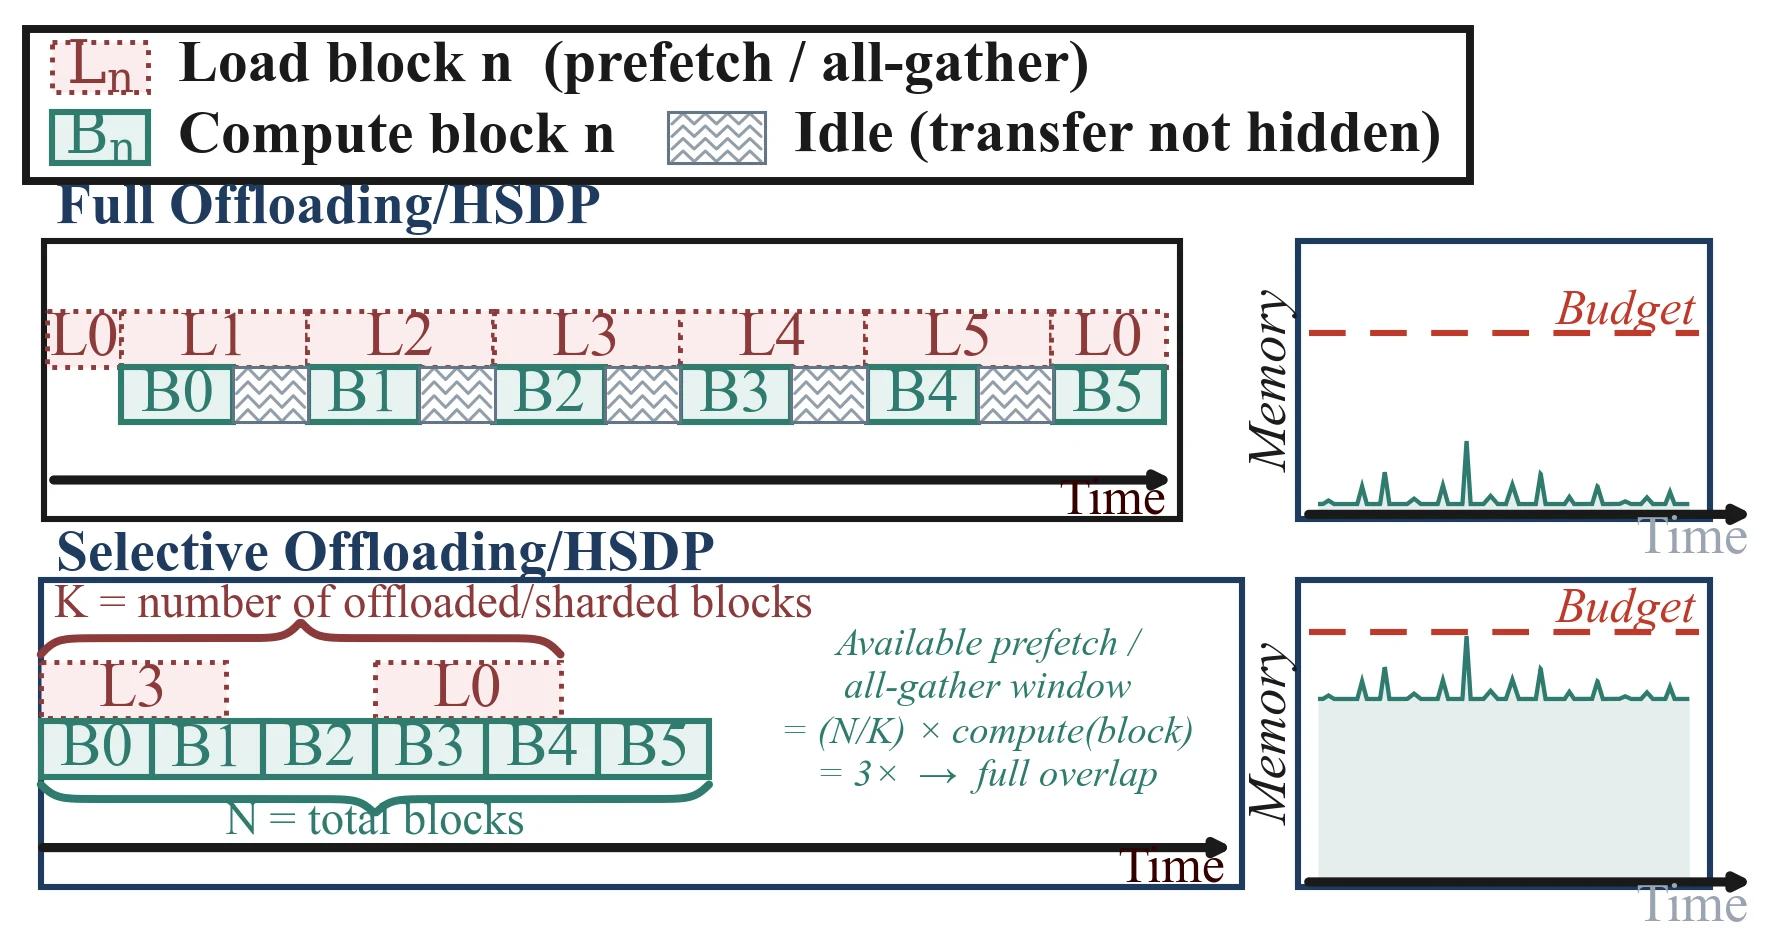
这张图的关键读法是把”显存压力”看成一条随时间变化的曲线,而不是一个恒定值。编码、采样、解码三个阶段的压力曲线形状不同:编码阶段被文本编码器权重占住,采样阶段被 DiT 权重与激活占住,解码阶段被上采样激活占住。传统做法是”全程按峰值预留”,于是大量内存在非峰值区间闲置;Xema 的做法是”按区间调度”,在非峰值区间把闲置内存让给并发请求。论文报告的 3.7 倍 SLO 提升,很大一部分来自这种”时间维度上的复用”,而不是某个 kernel 变快了。
对自建服务的启发是:显存规划要按阶段画曲线,不能只记一个峰值数字。如果监控里只看到”峰值 22 GB”,就不知道这 22 GB 出现在哪一步、持续多久、能否与别的请求错峰。把 per-stage 的显存曲线画出来,往往能发现”解码阶段其实只需要 8 GB,但权重常驻占了 14 GB”这类可优化的结构。
六、把一次请求拍成时间轴:逐段排队与重叠
6.1 先把账算清楚:端到端的四项加一个尾巴
把一次请求的端到端延迟 拆开,可以写成
其中 是在队列里的等待, 是文本编码, 是前向次数( 或 ), 是平均单步时间, 是 VAE 解码, 是图片序列化、网络传输等收尾。这个式子看起来平淡,但它把优化空间清楚地分成了几类:
- 压低 :少步蒸馏、更好的采样器、跳步缓存;
- 压低 :量化、kernel 融合、FlashAttention 类注意力、编译与 CUDA Graph;
- 压低 与 :embedding 缓存、卸载编码器、tiling 解码、轻量解码器;
- 压低 :调度策略、按步数/分辨率分桶、优先级;
- 让上面几项重叠:encode 与 diffuse 重叠、decode 与下一个请求的 diffuse 重叠。
每一项的收益取决于当前瓶颈在哪。一个常见的错误是”看到 大就去上量化”,但如果 是 50(CFG)而模型本身已经很快,真正的瓶颈可能是 或 。优化之前必须先把这五项分别测出来。
6.2 一个具体的数字账
用第八篇引用的 SVDQuant 数据做一个横向对照(FLUX.1-dev、单张 4090、25 步、1024×1024、单请求):
| 阶段 | BF16 | 4-bit(SVDQuant) | 说明 |
|---|---|---|---|
| 采样循环 | 约 100 s | 约 10 s | 25 步 × CFG 两路 = 50 次前向 |
| 端到端 | 111.7 s | 12.9 s | 含文本编码与 VAE 解码 |
| 固定开销占比 | 约 10% | 约 23% | 端到端减去采样 |
读这张表要紧的不是”快了多少”,而是固定开销占比从 10% 涨到了 23%。这不是固定开销变大了,而是采样变小了,分母换了。如果再叠上 4 步蒸馏,采样会降到 1 到 2 秒,端到端就会被编码与解码主导。这时继续优化 DiT 的边际收益很低,应该转向”embedding 缓存命中率""解码分块”与”队列等待”。
这个规律可以推广成一条经验:优化要盯着占比最大的那一项,而占比会随优化本身变化。每做完一轮优化都要重新拍一次时间轴,而不是沿用上一轮的分工。
6.3 三段重叠:能叠什么、不能叠什么
三段之间有没有可重叠的部分,取决于数据依赖:
| 重叠对 | 是否可行 | 成立条件 | 代价 |
|---|---|---|---|
| 请求 A 的编码 ↔ 请求 B 的采样 | 可行 | 编码器权重与 DiT 权重能同时驻留,或编码器在另一张卡/另一个进程 | 显存;编码器换入换出 |
| 请求 A 的解码 ↔ 请求 B 的采样 | 可行 | 解码与采样使用不同的 stream,且显存够同时放下两份激活 | 显存峰值;需要按 stream 管理分配 |
| 请求 A 的采样 ↔ 请求 A 的解码 | 不可行 | 解码依赖采样最终结果 | — |
| 请求 A 的编码 ↔ 请求 A 的采样 | 不可行 | 采样每一步都需要文本条件 | — |
后两行看起来是常识,但在实现里很容易被”流水线化”的冲动破坏。有些框架把 encode、diffuse、decode 抽象成三个 stage,然后用一个通用的 stage 流水线去编排;这时如果只按”stage 下标 +1”做错位重叠,就会把同一个请求的 decode 提到 diffuse 之前,得到一堆错误的图。正确的重叠只能是跨请求的:A 的 decode 与 B 的 diffuse 并行。
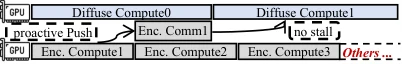
这张窄条图把时间轴横过来画:每一行是一个请求,每一段是它的 encode/diffuse/decode,段与段之间在横轴上错开,表示不同请求的同名阶段可以并行,而同一请求的三段必须按顺序。读图时注意两个不变量:同一行内三段不重叠(依赖关系),不同行之间同类阶段可以重叠(资源允许时)。调度器要做的,就是在满足这两个不变量的前提下,把尽可能多的段塞进同一段时间窗口。
TridentServe 的 Figure 5 画出了它的系统总览:不同请求的三段被拆成独立的任务,在多个模型副本之间按 stage 级别调度,有的副本偏重 encode/decode,有的副本偏重 diffuse,根据每段的实际需求和副本能力做匹配。
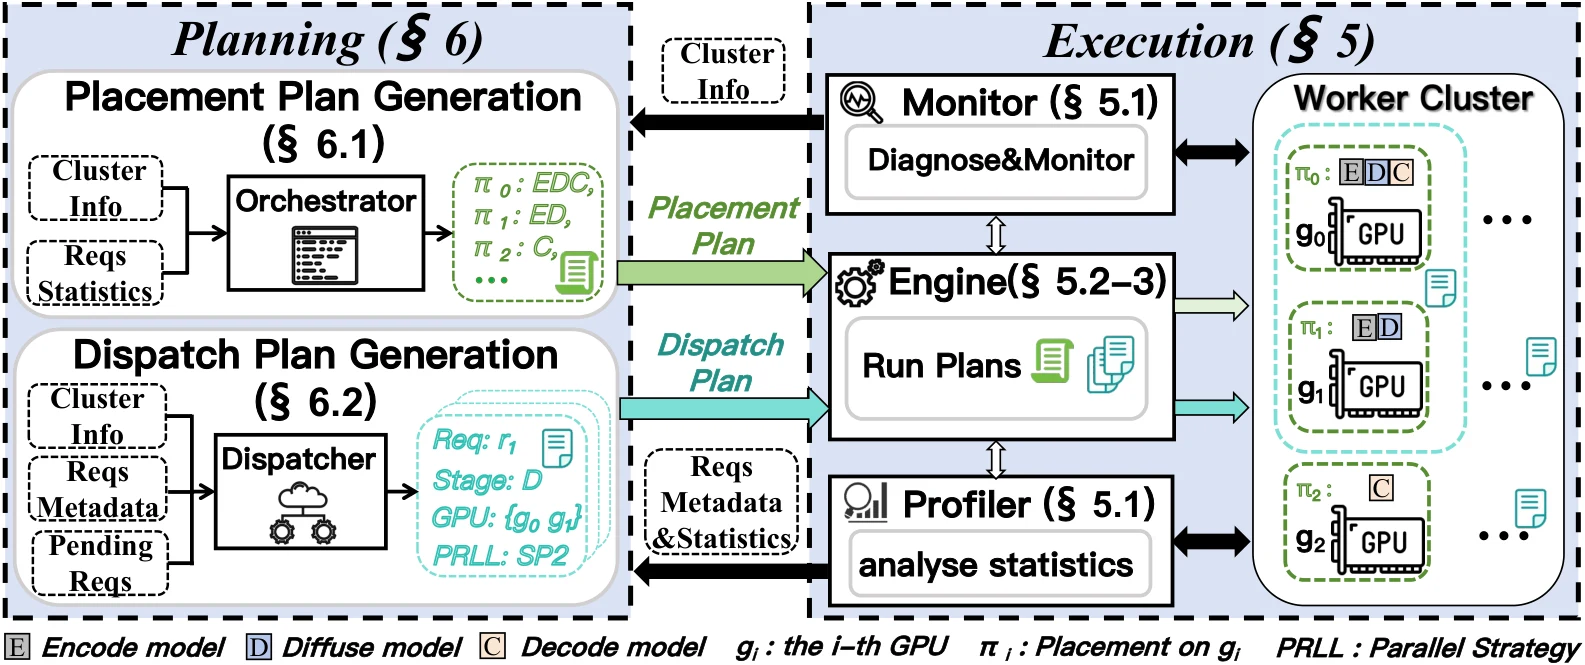
这张图的结构可以这样读:左侧是请求进入与调度器,中间是多个模型副本(每个副本上可能并置不同的 stage),右侧是完成回传。关键设计是”副本按 stage 能力区分,而不是每个副本都跑完整 pipeline”。在 pipeline-level 的静态部署里,每个副本都加载完整模型(编码器、DiT、VAE),请求进来就整条跑完;stage-level 则允许一个副本只放 encode 与 decode(显存需求小、计算量小),另一个副本只放 DiT(显存需求大、计算量大),然后按流量在两者之间路由。这样做的收益来自两点:一是不同类型的阶段可以各自扩缩容;二是每个副本的显存只服务于自己那段,不必”为最重的一段预留全部”。
6.4 并行采样:为什么理论加速比常常兑现不了
当一张图都装不下或一张卡的延迟太长时,自然想到把扩散阶段拆到多张卡上。几种典型做法:
- 张量并行 / 数据并行:前者把每层切到多卡,需要频繁通信;后者只是多条请求各走各的卡,不改变单请求延迟;
- patch 并行(区域并行):把潜空间切成互补的 patch,各卡分别去噪,patch 之间用 halo 重叠区做注意力。DistriFusion 走这条路,代价是 patch 边界处的注意力要用陈旧 KV 近似;
- 流水线并行:把不同层放到不同卡,按 micro-batch 流水,适合 batch 大的离线场景。
FlashDiff 的 Figure 3 指出:多卡带来的通信开销经常盖过并行收益。注意力层本身需要跨卡汇总,如果潜空间序列长、注意力占比高,那么切得越细,通信越多。
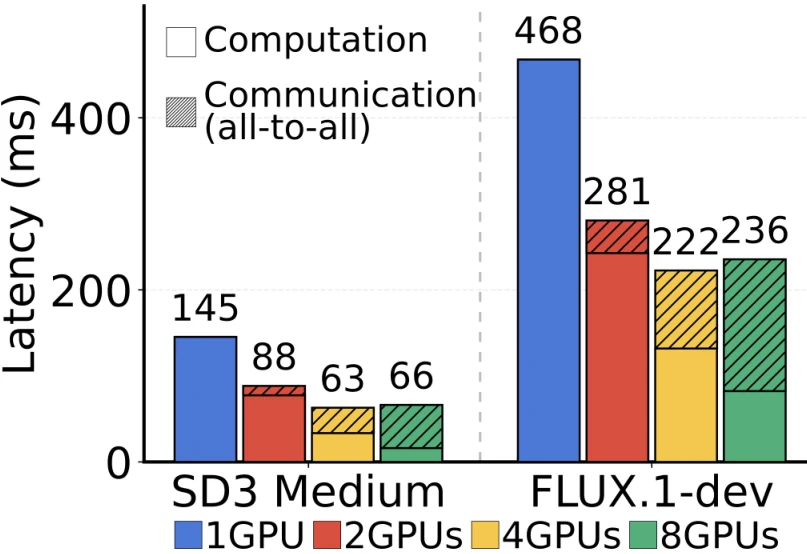
这张图把单步耗时拆成”计算”与”通信(all-to-all)“两段,横轴是 GPU 数,分别看 SD3 Medium 与 FLUX.1-dev。读法是:计算段随 GPU 数增加而缩短,通信段却随 GPU 数增加而放大;到 8 卡时,通信已经与计算相当甚至超过计算,于是总单步时间不再下降,并行效率崩塌。论文的正文也提到,在 SD3 模型上 8 卡时通信占比可达 76%。这也是为什么在单卡能装下的场景里,业界更倾向于”少步 + 量化 + 缓存”而不是”多卡并行”:前者的收益是确定的,后者依赖负载、序列长度与互联拓扑。
6.5 三个容易算错的量
量一:把”每 GPU 秒”当成成本单位。 扩散服务的成本不只是 GPU 秒,还包括权重常驻占用的显存(即使空闲)、显存热插拔的换入换出、以及为了低延迟预留的冗余副本。一个看似”利用率很高”的部署,可能因为每个副本都常驻了 20 GB 权重,实际有效吞吐远低于表面数字。
量二:忽略 的长尾。 采样循环是长任务,队列等待往往比单步耗时的波动更大。平均延迟好看不代表尾延迟好看:P95 可能比 P50 高出数倍。调度器必须按 SLO 而不是按平均延迟做决策。
量三:把”前向次数”等同于”延迟倍数”。 前向次数翻倍,延迟不一定翻倍:batch 增大能摊薄 kernel 启动,CFG 拼 batch 比串行两路快,CUDA Graph 捕获能省掉重复的启动开销。反过来,某些实现里前向次数只多一次,但因为显存压力触发了换页,延迟却暴涨。前向次数是成本的一阶近似,不是精确的延迟模型。
七、扩散 pipeline 与 LLM 服务链路的对照
7.1 一张对照表
| 维度 | LLM 推理服务 | 扩散推理服务 |
|---|---|---|
| 核心循环 | 每步生成 1 个 token | 每步对全图做一次全量更新 |
| 调度粒度 | token 级,可连续批处理 | 步级,batch 内必须同步 |
| 状态 | KV 缓存,可统一分页 | 潜变量 + 条件 + sampler 状态 + 可选缓存 |
| 瓶颈 | decode 阶段是访存瓶颈 | diffuse 阶段是计算瓶颈 |
| batch 收益 | decode 时几乎不增加单步延迟 | 单步延迟近似随 batch 线性增长 |
| 成本预估 | prompt 长度 + max_tokens | 分辨率 × 步数 × CFG,且受负载影响 |
| 输出 | 流式 token | 一次性出图(可做预览图) |
| 取消 | token 边界 | 步边界 |
| 固定开销 | 较少(sampler 很轻) | 显著(文本编码 + VAE 解码) |
| 显存峰值 | 权重 + KV 池 | 权重 + 采样激活 + 解码激活 |
这张表里最有工程价值的几行是”瓶颈""batch 收益""固定开销""显存峰值”。它们共同说明:不能把 LLM 引擎的经验直接套到扩散上。vLLM 式的”PagedAttention + 连续批处理 + 前缀缓存”在扩散里没有对应物,因为扩散没有增长型 KV、没有 token 级的可插入点、也没有”前缀”这种可以跨请求共享的线性结构(除非做区域级的近似复用)。
7.2 哪些 LLM 经验可以迁移
- 按阶段拆部署:LLM 的 P/D 分离(prefill/decode 分离)与扩散的 encode/diffuse/decode 分离在思想上一致:不同阶段对资源的需求不同,放在一起会互相干扰;可参考 DistServe 完全拆解:拆开 Prefill 与 Decode,按 Goodput 调度大模型推理;
- 分块与无停顿批处理:Sarathi-Serve 的分块 prefill 思想对应到扩散,就是”按 patch 拆分 diffuse 阶段,让不同请求的 patch 错峰调度”,FlashDiff 的 patch 调度器可以看作这一思想在扩散上的变体;可参考 Sarathi-Serve 完全拆解:分块 Prefill 与无停顿批处理如何兼顾吞吐和尾延迟;
- 在线延迟预测驱动准入:LLM 服务里用历史数据估计 prefill/decode 时间,扩散里同样需要,而且因为参数空间更大,预测模型更重要;
- CUDA Graph 与编译:LLM 的 decode 阶段因为形状固定而适合图捕获;扩散的”步”形状固定(batch、分辨率、模型确定后),图捕获的收益更大,因为单步计算远重于单个 token。
7.3 哪些经验不能迁移
- “大 batch 一定更好”:在 LLM 的 decode 阶段,加大 batch 几乎不影响单步延迟;扩散阶段会直接线性放大延迟,尾延迟会失控;
- “KV 缓存可以跨请求复用”:扩散没有可共享的 KV;跨请求复用的只是文本嵌入与少数缓存特征,粒度完全不同;
- “流式输出”:扩散没有 token 流,能做的只是”预览图”——先低分辨率/低步数出一张,再补细节;
- “上下文长度决定成本”:扩散的成本由分辨率平方、步数、CFG 三者共同决定,文本长度只是其中一个小项。
7.4 一个共同点:都需要”前缀/条件缓存”
虽然结构不同,两类服务都有一块”每次请求都一样、可以预先算好”的成本。LLM 是系统提示与固定前缀的 KV,扩散是文本嵌入与无条件分支的嵌入。把这块缓存做好,两类服务都能拿到确定性收益。区别在于:LLM 的前缀缓存可以用分页块精确管理,扩散的嵌入缓存按 prompt 哈希管理,命中率取决于重复度,更适合”批量同 prompt 换 seed”与”模板化 prompt”的场景。
八、流水线里的常见断裂点与排查方法
8.1 断裂点一:参数不合法导致静默降级
尺寸不是 8 的倍数、步数为 0、seed 超范围、引导强度过大——这些问题如果被入口层悄悄”修正”,用户看到的就是”同一参数在不同服务商那里效果不同”。例如某个网关把 1023 的宽度向上取整到 1024,构图就变了;某个实现把引导强度钳到 10,用户以为 15 生效了。排查方法:入口层打印最终生效的规范化参数,与用户原始参数并列记录。
8.2 断裂点二:缓存键不完整
文本嵌入缓存如果只按 prompt 字符串做键,换了模型、换了 tokenizer 版本、换了最大长度都会命中旧结果。表现为”升级模型后,某些 prompt 出的图仍像旧模型”。排查方法:缓存键必须包含模型哈希、tokenizer 版本、精度、是否开启提示词加权;并且对同一键做一次抽样复核。
8.3 断裂点三:OOM 发生在解码而不是采样
前面讲过,解码的激活峰值可能高于采样。表现为”日志显示采样循环正常结束,随后 OOM”。排查方法:按阶段记录 torch.cuda.max_memory_allocated() 的峰值,分别看 encode、采样、decode 三段;先上 tiling 与 VAE 精度修复,再考虑降分辨率。
8.4 断裂点四:batch 混入了步数或 CFG 不同的请求
表现为”某些请求的延迟出现数倍跳变”,或者”生成的图在中间步就停止更新”。根源是 batch 内请求共享了同一个步序列,步数少的请求被步数多的拖住,或步数多的请求被提前截断。排查方法:在组 batch 的代码里显式断言 (steps, guidance_scale, sampler) 三者一致;不一致就分桶。
8.5 断裂点五:CUDA Graph 与动态形状冲突
为了省 kernel 启动开销,很多实现会对”一步”做 CUDA Graph 捕获。但只要 batch 大小、分辨率、是否命中缓存变化,图就失效,需要重新捕获或回退到 eager 执行。表现为”固定负载时很快,负载一变化就变慢”。排查方法:记录图捕获的次数与耗时;把 batch/分辨率分桶,桶内尽量保持形状稳定;对缓存命中导致的分支差异,用掩码而不是改变形状。
8.6 断裂点六:取消没有传到 GPU
用户取消后,worker 还在跑完整的 50 步,GPU 被占住,后续请求排队。排查方法:在步边界检查取消标志,命中即丢弃;对已进入 kernel 的步不做强行中断(不安全),只保证不超过一步的浪费。
小结
这一篇把扩散模型从”数学对象”还原成”线上流水线”,要点如下:
- 一次请求经过 encode–diffuse–decode 三段:只有中间那段被重复执行 或 次,两端各只执行一次,但两端常常是固定开销与显存峰值的主要来源;
- 单步是”一次全量前向 + 一次 scheduler 更新”:模型输出是中间量,不是结果;换采样器等于换一套状态机;
- CFG 把每步成本乘以二:拼 batch 与串行两路的 FLOPs 相同,差别在 kernel 效率;这是”引导不免费”的系统侧含义;
- 扩散是计算瓶颈,不是访存瓶颈:batch 增大近似线性放大单步延迟,盲目堆 batch 会伤害尾延迟;
- 调度只能在步边界发生:步数、CFG、分辨率不一致的请求不能混批;步数分桶是生产系统的常规操作;
- 解码常常是显存峰值所在:tiling、轻量解码器、VAE 精度修复是三条常规手段;显存规划要按阶段画曲线,而不是只记一个峰值;
- 优化要看占比最大的项:每轮优化后占比都会变化,要重新拍时间轴;
- LLM 的经验只能部分迁移:阶段分离、延迟预测、CUDA Graph 可以借鉴;大 batch 优先、KV 复用、流式输出不能直接套用。
这条链路是理解后续系统工作的基础。区域级调度(FlashDiff 按 patch 分配计算)、跨请求的阶段级放置(TridentServe)、按生命周期管理显存(Xema)都建立在本篇描述的同一个三段结构之上;把它们看作”在同一条链路上改变资源分配方式”,比逐个记论文更容易串起来。
参考资料
- TridentServe: A Stage-level Serving System for Diffusion Pipelines(arXiv, 2025)
- Xema: Efficient Diffusion Serving through Fine-Grained Memory Management and Auto-Configuration(arXiv, 2026)
- FlashDiff: Efficient Regional Execution and Scheduling for Diffusion Model Serving(arXiv, 2026)
- PATCHEDSERVE: A Patch Management Framework for SLO-Optimized Hybrid Resolution Diffusion Serving(arXiv, 2025)
- Scalable Diffusion Models with Transformers(DiT,Peebles & Xie, ICCV 2023)
- High-Resolution Image Synthesis with Latent Diffusion Models(LDM / SD,Rombach 等, CVPR 2022)
- Denoising Diffusion Probabilistic Models(DDPM,Ho 等, NeurIPS 2020)
- Denoising Diffusion Implicit Models(DDIM,Song 等, ICLR 2021)
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis(SD3,含 timestep shifting 与 T5 文本编码器设计)
- FLUX.1-dev 模型卡(文本编码器、VAE 与 pipeline 结构说明)
- Hugging Face diffusers 文档:Diffusion pipelines
- SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models(含 FLUX.1-dev 端到端延迟与显存数据)
- DistriFusion: Distributed Parallel Inference for High-Resolution Diffusion Models(patch 并行与 halo 重叠)
- PipeFusion: Patch-level Pipeline Parallelism for Diffusion Transformers Inference
- Learning Transferable Visual Models From Natural Language Supervision(CLIP,Radford 等, 2021)
- Hugging Face Transformers 文档:T5 模型与分词器
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



