


DAC 2026 Chiplet 方向论文精读:从链路压缩、晶圆级网络到架构探索与 3D 内存映射
大模型推理落到多裸片系统后,问题远不止“芯片间带宽够不够”。同样一条物理链路,传什么编码、经过多少跳、由怎样的数据流触发、能否被编译与映射工具准确建模,都会改变最终可用带宽。
本文串联四项 DAC 2026 工作:LEXI 在链路上传更少的位,Wafer-on-Wafer(WoW)网络利用物理摆放创造更好的图,ChiSER 用高保真代理模型寻找更可信的 Chiplet 架构,HiBand 则围绕混合键合 DRAM 重组大模型推理的数据流与片上网络。四者分别回答了四个问题:
- 数值不能失真时,怎样减少跨裸片传输量?
- 两片晶圆面对面键合时,怎样把几何重叠变成高质量网络?
- 架构、映射和制造成本耦合后,怎样快速搜索又不丢失核心内细节?
- 垂直内存带宽突然增大后,怎样避免 NoC 成为新的瓶颈?
把它们放在一起看,会得到一个比“峰值带宽”更有用的观察:系统真正追求的是工作负载可兑现的有效带宽。
先建立统一坐标:物理带宽不等于有效带宽
Chiplet 把一颗大芯片拆成多个可复用裸片,通过中介层、封装基板或混合键合互连。拆分改善了良率、复用和工艺选择,却把原先片内的数据移动变成了显式的跨裸片通信。对自回归推理尤其如此:解码阶段每生成一个 token 都要读取大量权重,并访问随上下文增长的 KV Cache;MoE 还会引入 token dispatch、expert 计算和 combine 流量。
可以用一个简化乘积理解有效带宽:
其中:
- 是链路或混合键合界面的物理带宽;
- 描述拓扑、路由和拥塞造成的利用率损失;
- 是无损编码带来的等效容量增益;
- 反映映射、并行策略与通信计算重叠程度。
这不是四篇论文共同使用的公式,而是便于横向理解的系统抽象。LEXI 提高 ,WoW 网络改善 ,ChiSER帮助找到这些因素的合理组合,HiBand 主要提高 并让 NoC 匹配新的 。
LEXI:只压缩 BF16 指数位,语义一位不改
为什么指数位值得单独处理
BF16 由 1 位符号、8 位指数和 7 位尾数组成。它保留了与 FP32 相同的指数宽度,因此动态范围大;但“格式允许 256 种指数”并不意味着一次推理真的会均匀使用这些取值。
LEXI 对 Jamba、Zamba 和 Qwen 的权重、激活、KV Cache 与状态空间模型缓存进行逐字段分析,观察到指数流的 Shannon 熵通常低于 3 bit,而且常用指数集中在不超过 32 个取值中。指数随机变量 的熵为:
固定 8 bit 指数为所有值付出相同开销,而 Huffman 编码让高频指数使用短码、低频指数使用长码。对最优前缀码,平均码长 满足:
符号位和尾数保持原样,指数经前缀码无损恢复,因此计算单元看到的仍是逐位一致的 BF16,而不是近似值。若平均指数码长约为 3 bit,一个 BF16 值在线路上的主体便可由 16 bit 降到约 bit;实际包还要算入码本、头部和补齐,所以收益取决于消息长度与分布。
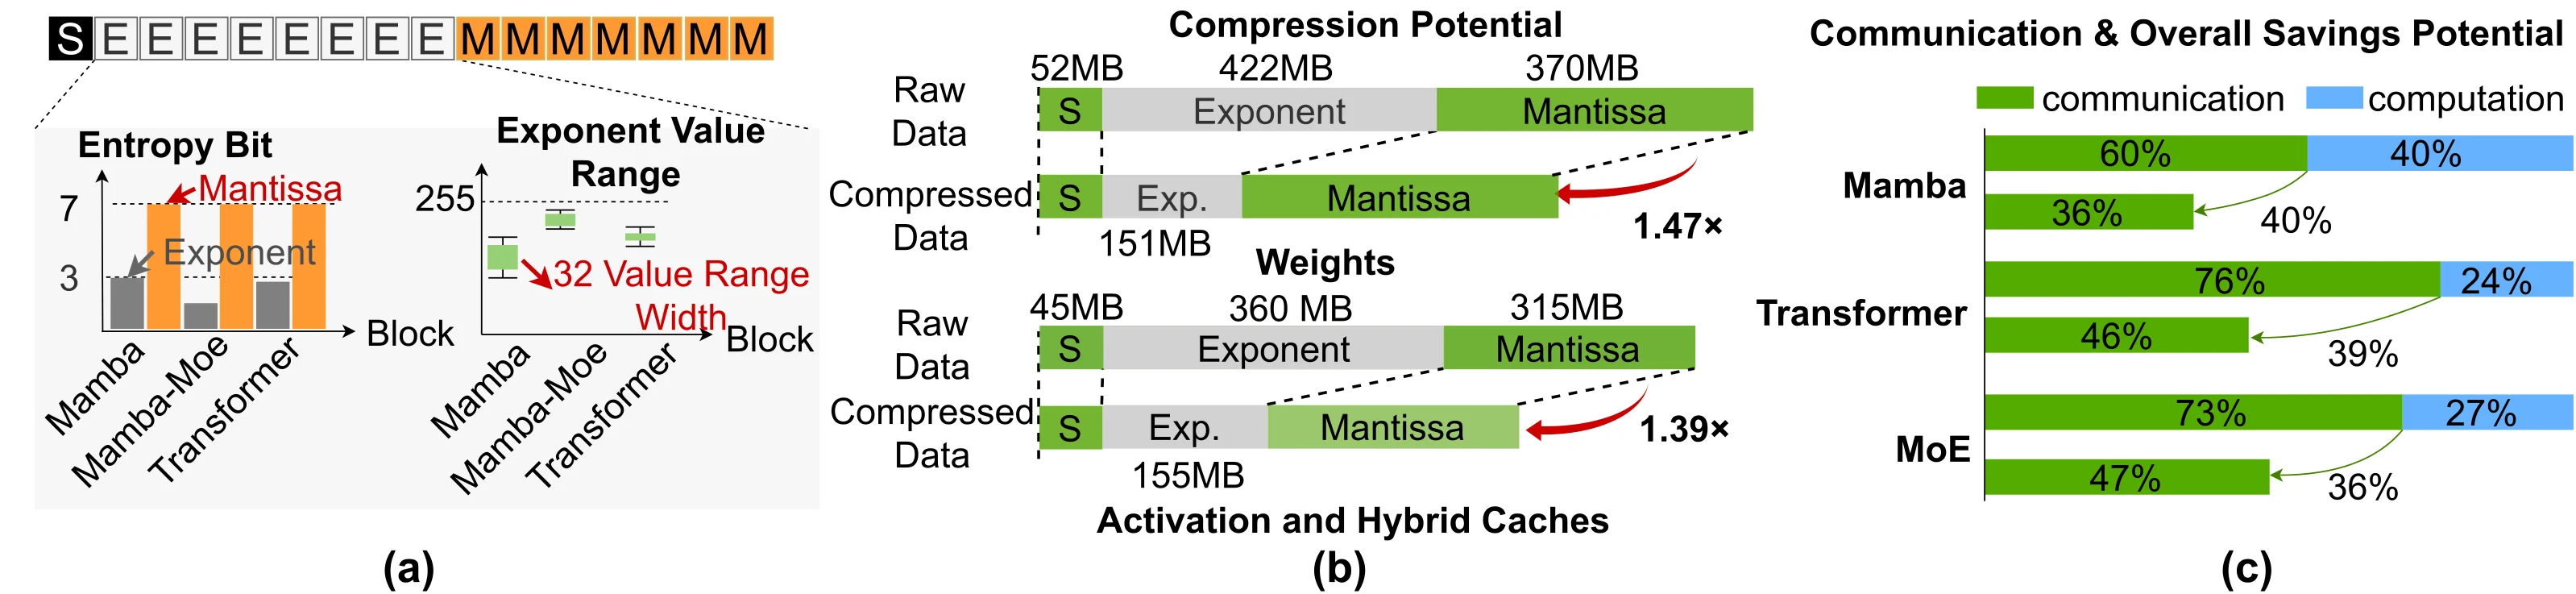
图 1:BF16 指数具有明显低熵特征,而尾数仍接近完整 7 bit 范围。来源:LEXI 官方 arXiv HTML,Figure 1。
论文报告,在它的分析样本中,权重指数数据量从 422 MB 降到 151 MB,激活与缓存的指数数据量从 360 MB 降到 155 MB。计入未压缩的符号位和尾数后,总数据量分别约缩小 1.47 倍和 1.39 倍。这里必须区分“指数部分压缩比”和“完整 BF16 流压缩比”,否则很容易高估链路收益。
权重离线压,激活与缓存在线压
LEXI 将三类数据分开处理:
- 权重提前压缩后存入 DRAM/HBM,读取时以压缩态传输,在靠近计算的位置即时解码;
- 激活在计算裸片的网络出口在线编码,在目标入口恢复;
- KV Cache 与状态空间模型缓存写回时压缩、取用前解压。
编码与解码器嵌入 NoC 路由器的出口和入口,处理单元本身无需理解压缩格式。传输 flit 由头部、符号位、尾数和压缩指数流组成;头部描述当前 flit 承载的元素数量,边界不足时补零。这样,变化长度的码字被重新装入固定宽度网络单位,路由器仍可按原有流控工作。
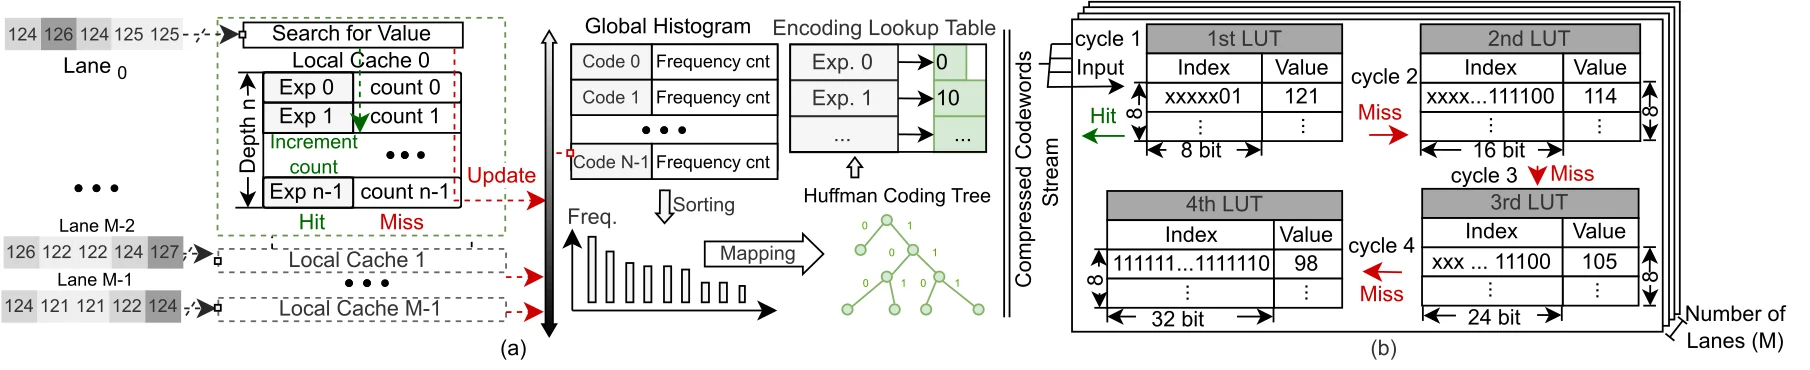
图 2:多路局部计数、码本生成与四级 LUT 解码器。来源:LEXI 官方 arXiv HTML,Figure 3。
在线编码最难的部分不是查表,而是快速建立适合当前层的码本。LEXI 用每层最先到达的 512 个激活统计指数分布,之后复用同一码本处理该层数百万个元素。硬件流程分为三步:
- 多个并行 lane 用各自的 8 项局部缓存累计指数频次,未命中时再合并到全局直方图;
- 针对不超过 32 个常见指数,用 15 级 bitonic sorter 排序,再用 31 个周期完成 Huffman 树合并;
- 遍历树并在 32 个周期内写入编码 LUT,合计 78 个周期。
若出现码本未覆盖的指数,编码器发送保留的 24 bit escape code,再附上原始 8 bit 指数。这个回退路径牺牲个别元素的压缩率,却保证任意 BF16 指数都能无损传输。
变长码怎样追上固定速率链路
Huffman 解码天然带有串行依赖:必须知道当前码字在哪里结束,才能确定下一个码字的起点。直接用最长 24 bit 前缀寻址一个巨大 LUT 会快速膨胀。LEXI 改用 8、16、24、32 bit 四级 LUT:高频短码通常在第一级完成,只有长码才向后级转发;多条解码 lane 再以轮询方式并行接收 flit。
在论文选择的实现点上,100 Gbit/s、1 GHz 链路相当于每周期约 100 bit。按最乐观的 10 bit 压缩元素估算,需要 10 条并行解码 lane 才能守住线速。10 lane、每 lane 8 项局部缓存的编码器把 512 样本码本准备时间压到约 55 ns;四级解码器解出 10 个指数的平均延迟约 11.6 ns。
评估使用 6×6 同构 Simba 风格 Chiplet、2D mesh、100 Gbit/s 跨裸片链路和修改后的 HeteroGarnet 流量仿真,RTL 在 GF 22 nm、1 GHz 目标下综合。论文在 Jamba-tiny-dev、Zamba2-1.2B-Instruct-v2 与 Qwen1.5-1.8B-Chat 上报告跨裸片通信延迟降低 33%~45%,端到端推理延迟降低 30%~35%,编解码单元面积与能耗开销约 0.09%。这些数字属于该论文的平台和流量假设,不应直接外推到所有封装与模型。
LEXI 的边界
LEXI 的优势来自两个前提:指数分布足够集中、长消息足以摊薄码本成本。短控制消息、小张量、指数分布快速漂移或层内多个专家差异显著时,512 个样本与逐层码本未必是最佳粒度。工程实现还需要明确码本版本、错误恢复、背压和压缩后包长变化对虚通道分配的影响。它降低的是传输位数,不会减少计算单元读取完整 BF16 后的内部数据通路宽度。
WoW 网络:让晶圆几何直接决定图的边
传统 2D mesh 往往先确定逻辑拓扑,再把节点摆进物理版图。Wafer-on-Wafer 混合键合提供了另一种思路:上下两片晶圆面对面键合,只有在平面投影中相互重叠的 reticle 才能通过垂直键合点直接连接。于是,移动、旋转或改变 reticle 轮廓,本身就在改变网络图。
论文区分两种集成方式:
- Logic-on-Interconnect(LoI):上层晶圆放计算 reticle,下层晶圆主要承担路由与互连;
- Logic-on-Logic(LoL):上下两层都放计算 reticle,垂直连接同时承担跨层通信。
可把系统写成二部图 。上下层节点分别属于 和 ,当两个 reticle 的投影交叠且具备合法键合区域时建立边 。同一层 reticle 不通过混合键合直接相连。与普通 mesh 相比,设计目标不再只是“把线连起来”,而是同时优化节点度数、直径、平均最短路和二分带宽。
平均最短路可写为:
更小的 通常意味着更少路由级和线延迟,但最大度数升高也会增加路由器端口、仲裁和布线代价。因此好的几何并不等于无条件追求最多重叠。
五类摆放怎样改变连通关系
论文从 mesh-like baseline 出发,提出四种优化摆放:
- Aligned:调整上下 reticle 的相对位置,形成更规则的高连通结构;
- Interleaved:让两层网格错位穿插,增加跨层邻接选择;
- Rotated:旋转一层 reticle,使边角跨越原有行列边界;论文给出的代表性尺寸为 22.98 mm × 32.53 mm,45° 旋转后节点度数可达 7;
- Contoured:使用 H 形或十字形等轮廓扩大有效重叠,在接近光刻 reticle 尺寸限制的条件下提高晶圆利用率,代表设计节点度数为 5。
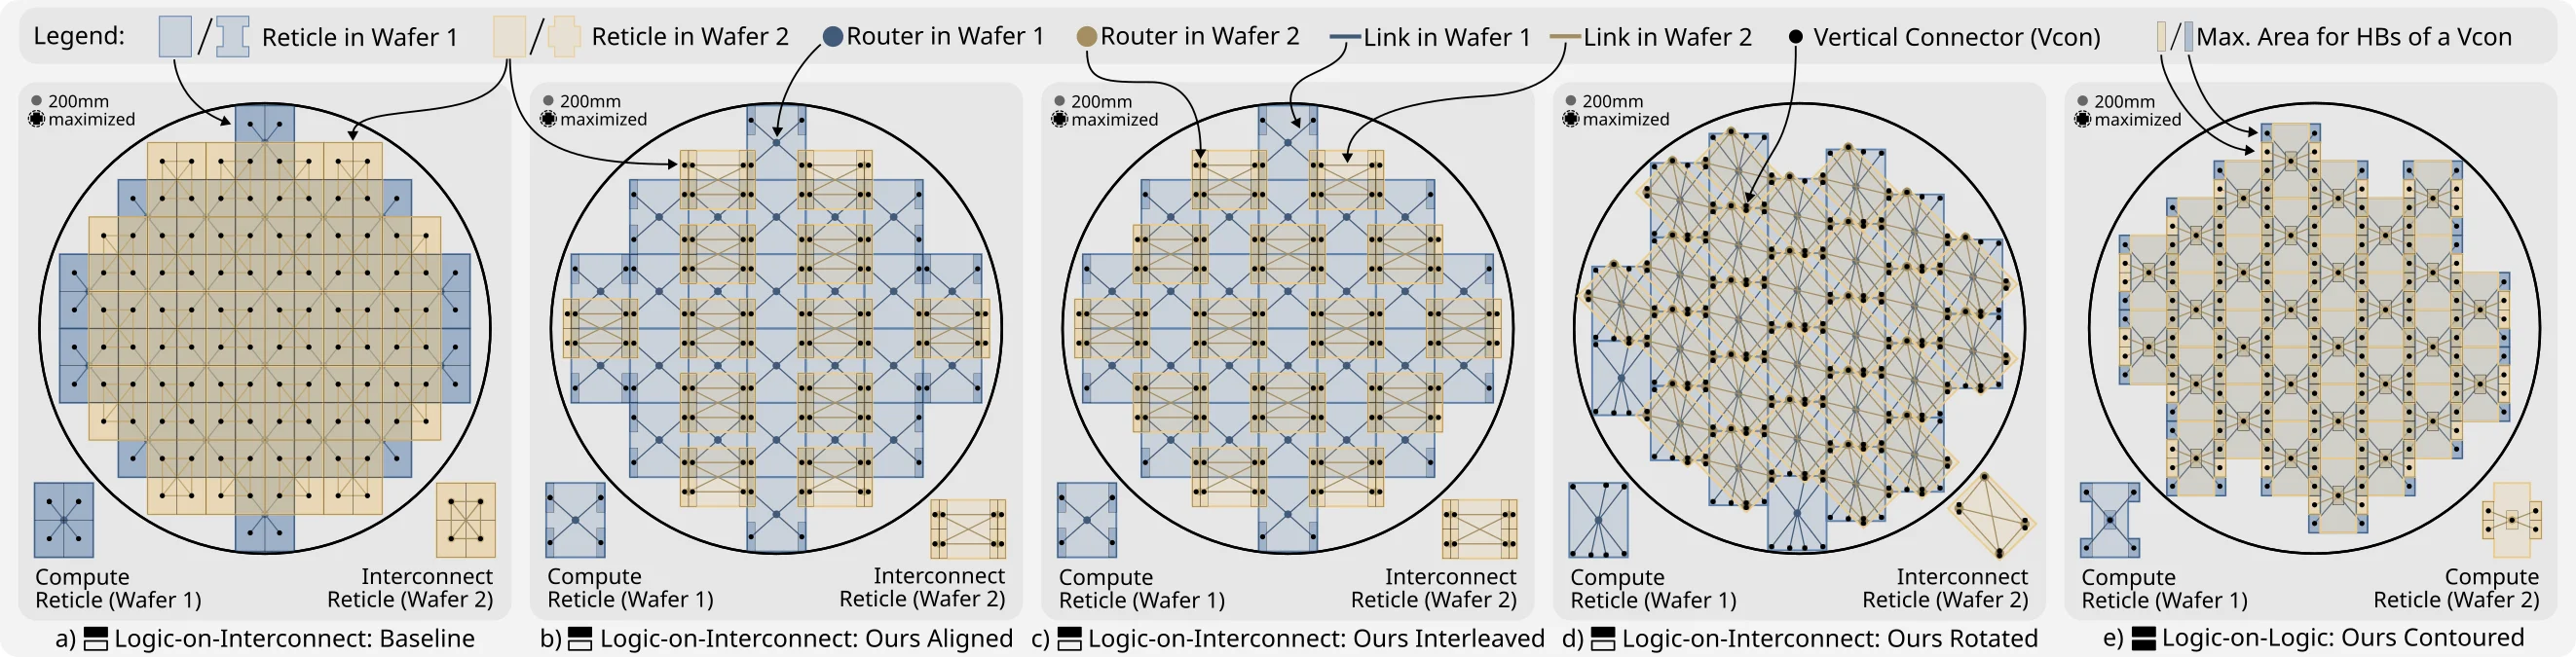
图 3:物理摆放与逻辑拓扑是一件事。来源:WoW 网络论文官方 arXiv HTML,Figure 1。
Aligned 和 Interleaved 的优势是制造与版图规则相对直观;Rotated 用角度换取更多邻接边,但会引入非正交边界与更复杂的晶圆利用问题;Contoured 进一步放宽 reticle 轮廓,让几何自由度服务于拓扑,不过掩模、切割、供电和故障隔离也更难。
评估为何不能只看均匀随机流量
论文使用 BookSim2 建模,配置包括每方向 2 TB/s、1 GHz 路由器、4 周期路由延迟、每 2 mm 插入一级线延迟、32-flit 输入缓冲和单虚通道。流量既包括 uniform、permutation、neighbor、tornado 等合成模式,也包括由 Llama-7B 映射产生的跟踪流量;跟踪评估把消息切成 2 KB 数据包,原始消息最大约 1.8 MB。
这组设置的价值在于揭示两个不同问题:合成流量测拓扑的极限和对称性,真实跟踪则测热点、集合通信与阶段性突发。一个拓扑可能在 uniform random 下二分带宽很高,却在张量并行 all-reduce 或邻近通信下绕远路;反过来,为局部流量优化的结构也可能在全局置换中迅速拥塞。
论文在所评估配置中报告最高 250% 的吞吐提升、最高 36% 的平均包延迟下降,以及最高 38% 的每字节能耗下降。这里的“最高”来自不同配置和流量点,不能把三项峰值简单理解成同一工作点同时获得。另一个重要边界是,作者在离散尺寸与角度空间中做了系统枚举和优化,但这不等于对所有连续几何与制造约束给出全局最优的数学证明。
真正值得带走的不是某一种形状,而是设计顺序的反转:在混合键合系统里,网络架构师应在 floorplan 阶段就参与;等 reticle 形状与相对位置冻结后再“选 NoC”,可能已经错过最主要的拓扑自由度。
ChiSER:用高保真代理模型弥合搜索速度与可信度
Chiplet 加速器的设计空间至少跨四层:
- 模型算子怎样切分到不同裸片;
- 裸片怎样摆放、互连带宽怎样配置;
- 每个算子选择什么 dataflow、tile 和并行映射;
- 核内 PE 阵列、L2/RF 容量、端口与数据复用怎样设置。
快速系统估算器可以在约毫秒甚至更短时间筛大量候选,但常把核内行为压缩成粗粒度公式,忽略 PE 利用率、非整除 tile、partial sum 溢出与回写、halo 交换、组播 fanout 和存储端口竞争。Timeloop 一类细粒度参考模型能捕获这些现象,单个候选却可能需要分钟级评估。若把它直接嵌进外层搜索,组合空间几乎不可承受。
ChiSER 的关键不是用机器学习替换整个系统模型,而是在快模型最薄弱的核内部分插入 Intra-Core Surrogate(ICS),并把慢参考模型留在样本标注和最终验证阶段。
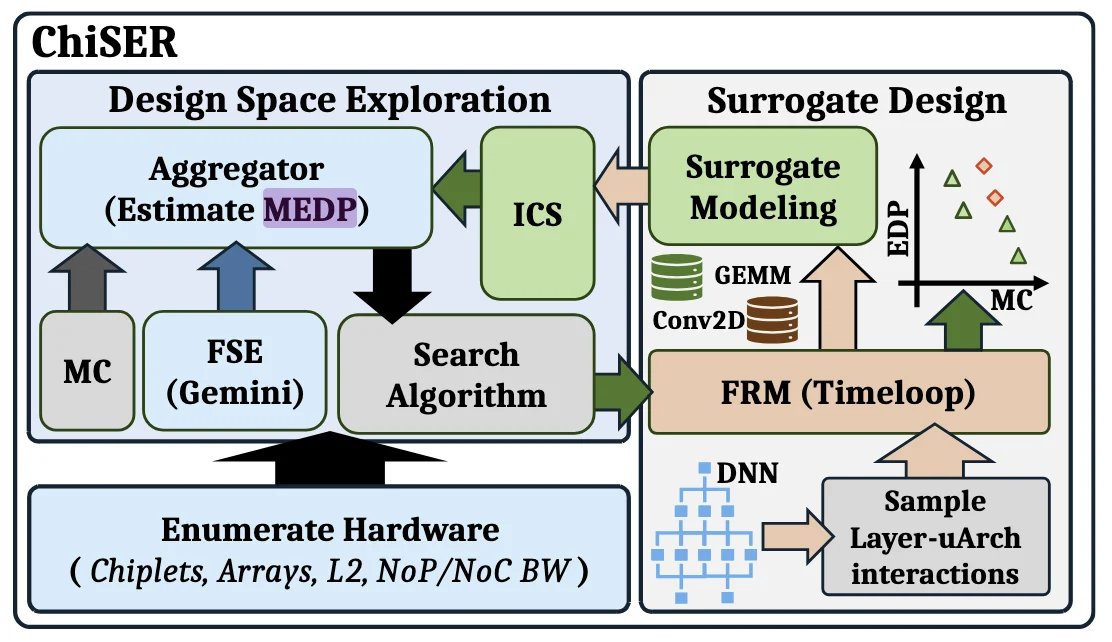
图 4:ChiSER 以快系统估算器覆盖全局,以 ICS 补回核内能耗、延迟与可映射性。来源:ChiSER 官方项目页。
ICS 为什么采用混合模型
ICS 输入不仅包括张量形状、卷积核、阵列规模和存储容量,还加入 ceil/fraction 一类工程特征,把“尺寸不能整除阵列”产生的台阶效应显式暴露给模型。目标输出是核内能耗、延迟与 mapping feasibility。
其预测器由 XGBoost 与轻量 MLP 组合:树模型擅长捕捉容量边界、整除关系和条件分支等离散突变;神经网络头部融合树叶编码,联合预测多个相关目标。随后用 group sparsity 做结构化剪枝,去掉不必要的树特征,并编译为确定性的 C++ 推理路径。官方项目页给出的剪枝后查询延迟是 0.32 ms,和 Timeloop 结果的延迟、能耗相关系数分别为 0.997 与 0.971。
这一设计说明,架构代理模型不能只看平均误差。对 DSE 而言,更关键的是候选排序是否可靠、约束边界是否正确:一个能耗预测误差不大的模型,如果总在 buffer 容量边界附近判断错 feasibility,仍可能把不可实现的候选推上 Pareto 前沿。
从候选参数到制造加权目标
ChiSER 同时搜索切分数、NoC 带宽、die-to-die 带宽、每核 L2 和 MAC 数等参数。论文的代表性离散范围包括:X/Y 方向切分取 1、2、4、8,NoC 带宽取 8、16、32、64,D2D 带宽取 NoC 的四分之一、二分之一或相同值,每核 L2 从 256 KB 到 4096 KB,每核 MAC 从 512 到 4096。
搜索目标不只考虑能耗与延迟,还加入制造成本。可用下式理解 manufacturing-weighted energy-delay product:
这里的制造成本 会随裸片面积、数量、良率与封装方案变化。把它放进目标后,单纯堆叠更多 MAC 或更大 SRAM 未必更优:性能收益若不足以抵消大裸片良率和封装代价,MEDP 会变差。
ChiSER 用 Gemini 风格的快系统估算覆盖互连和全局组合,以 ICS 修正核内能耗与延迟,再让 Timeloop 对最终候选做高保真复核。官方结果页报告,相比由粗粒度估算引导的选择,ChiSER 找到的设计在 ResNet-50 和 Transformer 上分别降低 62% 与 44% 的 MEDP。
代理模型不是永久真理
ICS 的可信域由训练样本、算子类型和硬件参数范围共同限定。若加入新的注意力 kernel、稀疏算子、异构存储或完全不同的 NoC,已有代理可能发生分布外失真。一个稳健流程应该持续做三件事:监测输入是否越界;对 Pareto 前沿与低置信候选调用参考模型;把新标注回灌代理模型。ChiSER 证明的是“慢模型的知识可以进入快搜索”,不是“一次拟合后永远不再需要参考模型”。
HiBand:垂直带宽变大后,NoC 反而成为主角
混合键合 3D DRAM 把存储阵列堆叠在逻辑计算层上方,细间距垂直连接让每个计算阵列拥有很高的本地 bank 带宽。它解决了传统 HBM 经少数控制器进入逻辑芯片的集中式瓶颈,却带来新的不平衡:带宽分散在各个局部阵列,而一个算子需要的数据和计算未必恰好位于同一处。
若沿用传统全局 tensor parallelism,大量中间结果会穿越整个 NoC。本地垂直链路很快,全局横向网络却仍受端口、线长和拥塞限制。HiBand 的论文分析称,NoC 拥塞可造成 41% 的性能损失,而全局 mesh 利用率仍可能低于 25%。两者并不矛盾:少数热点链路已经饱和,其他区域却处于空闲。
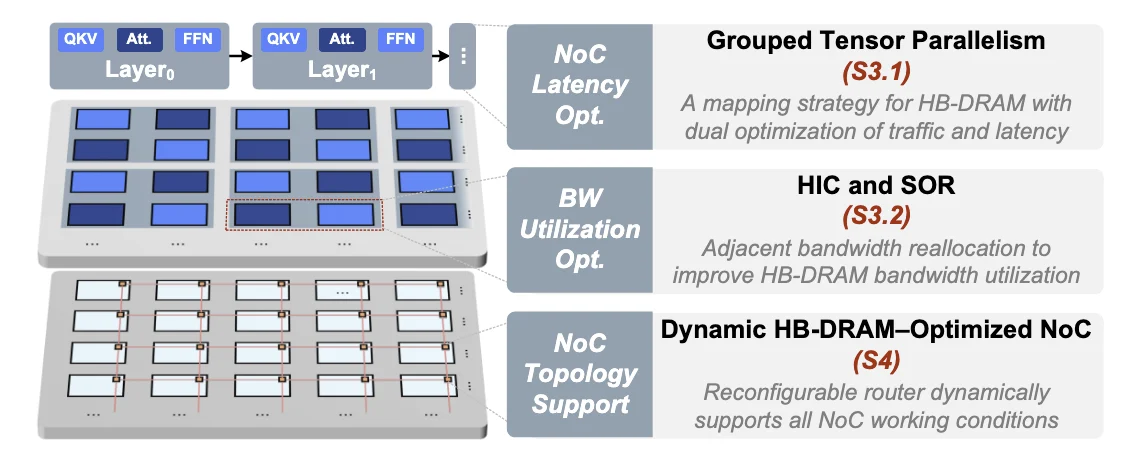
图 5:HiBand 把问题分成内存层、计算与数据流层、NoC 层,逐层协调局部与全局带宽。来源:HiBand 论文作者公开技术材料。
GTP:先把张量并行限制在邻近小组
Grouped Tensor Parallelism(GTP)把相邻的 阵列组成一个组。组内做 tensor parallelism,组间用 pipeline 串联模型阶段;attention head 或通道切分后,其权重、KV Cache 与负责计算的阵列尽量放在同一局部区域。这样,原先跨整片逻辑 die 的 collective 被缩成短距离组内通信。
组大小存在明显权衡:组越大,可并行的计算资源越多,单层延迟可能更低,但通信半径和归约流量也更大;组越小,局部性好,却可能降低单层并行度、增加 pipeline stage 数和气泡。因而 GTP 不是固定的“局部化规则”,而是需要随模型层、batch 和序列阶段选择的映射参数。
BSA、BGA 与 HIC:让不同算子共享阵列带宽
大模型推理的算子强度不均匀。前馈网络和大矩阵乘可能偏计算受限,attention 的 KV 读取则更偏带宽受限。如果所有阵列按同一方式执行,计算受限阶段会闲置一部分局部内存带宽,而带宽受限阶段又会挤占 NoC。
HiBand 提出两类阵列组织:
- Bandwidth-Share Array(BSA)服务计算受限算子,在阵列之间共享或让渡局部带宽;
- Bandwidth-Gather Array(BGA)服务内存受限算子,从多个邻近 HB-DRAM 分区聚合带宽;
- Head-Interleaved Co-execution(HIC)在不同 attention head 间交错安排 QKV projection 与 attention,使计算受限和带宽受限阶段重叠;
- Sub-Operator Recomposition(SOR)进一步拆解并重组子算子,减少资源阶段性闲置。
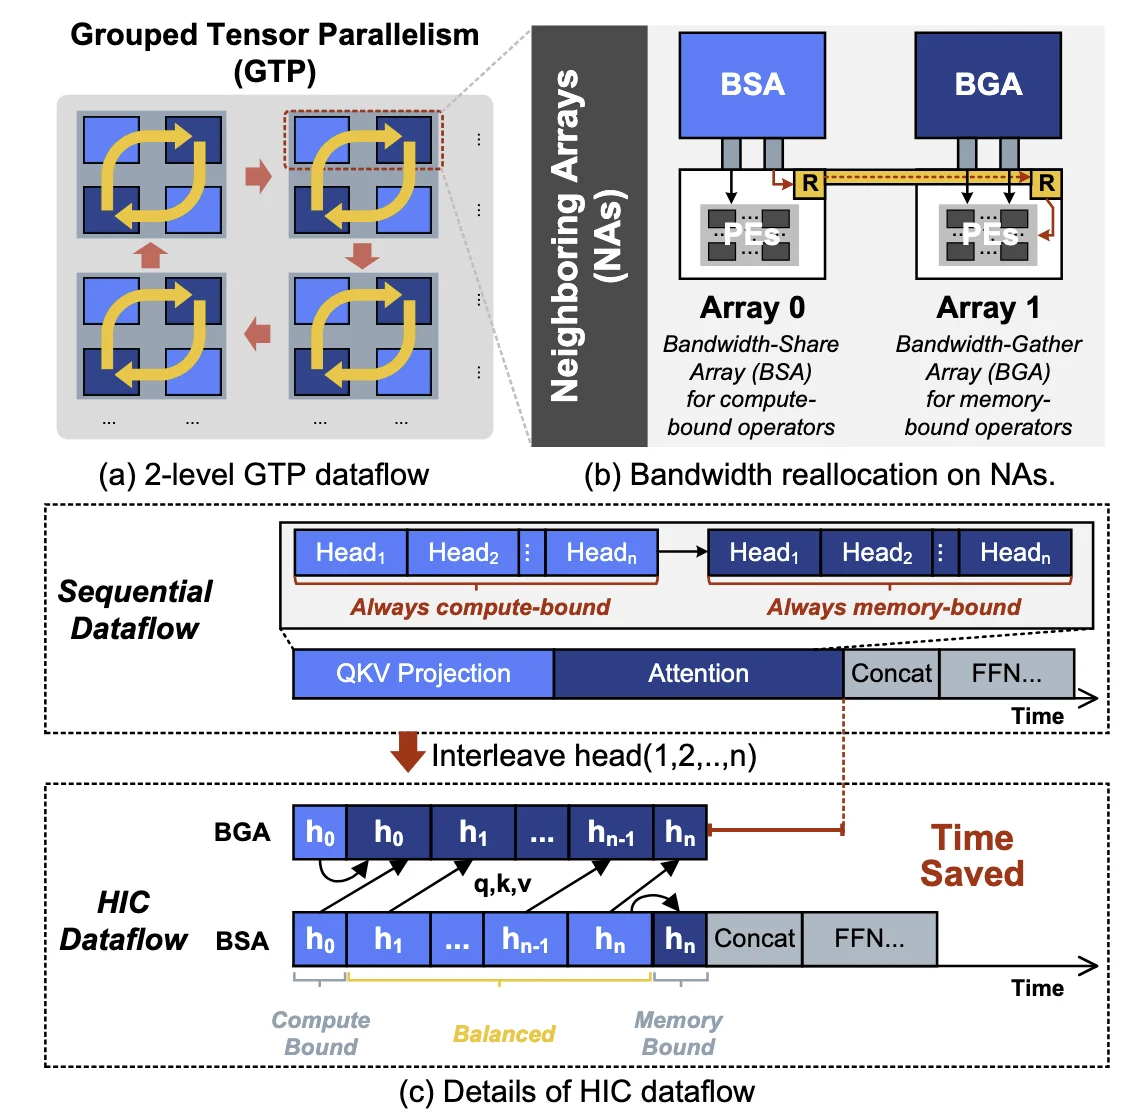
图 6:GTP 控制通信半径,BSA/BGA 重分配带宽,HIC 与 SOR 提高计算和访存重叠。来源:HiBand 论文作者公开技术材料。
这些机制的核心不是让每个算子都获得峰值带宽,而是把“本地带宽所有权”变成可调度资源。例如一个阵列执行 FFN 时计算管线已满,它附近暂时用不完的 DRAM 带宽可以被相邻 attention 子任务利用;反过来,局部组内的 KV 数据保持就近,又减少了全局搬运。
四模式 NoC:按阶段切换局部性与全局性
固定 mesh 很难同时服务局部高带宽和偶发全局通信。HiBand 使用可重构 split-Benes 网络,并提供四种工作模式:
- Full Local:资源完全服务局部组,压低短距离通信开销;
- Local Bias:优先局部流量,同时保留有限的全局交换能力;
- Global Bias:向跨组流量倾斜,但不彻底放弃局部通道;
- Full Global:把网络能力用于全局交换和集合通信。
运行时按迭代或算子阶段切换模式。相比为最坏情况永久配置一张宽大全局网络,这种方式让同一批物理交换资源在不同时间承担不同拓扑角色。代价是控制器必须提前知道通信阶段,切换还要处理在途包、顺序和死锁隔离。
论文评估的代表性系统采用 7 nm 逻辑工艺、4 层 DRAM、32 个 PE array,并以约 1 TB/s 的片上网络连接 8×8 crossbar 与 split-Benes 结构。模型覆盖 GPT-2-Large、Llama-3.2-3B 和 Mixtral 8×7B。DAC 官方摘要报告,HiBand 相对 HBM3 GPU 风格基线最高加速 4.28 倍,相对已有 HB-DRAM 近存计算设计最高加速 1.67 倍。技术材料还给出 TTFT 最高改善约 2.35 倍、TPOT 最高改善约 1.21 倍,以及 NoC 面积占比约 2.3%~4.6% 等结果。不同指标对应不同模型和配置,适合用来说明机制有效,不应混成一个“统一加速比”。
HiBand 也有清晰边界:GTP 与 HIC 依赖可预测的算子图和数据放置;动态 batch、长度差异、MoE 路由偏斜会改变热点;四模式网络增加验证与运行时控制复杂度;HB-DRAM 的热、供电、良率和容量约束也没有因为映射优化而消失。
四篇工作放在一张系统表里
| 层次 | 工作 | 主要控制变量 | 直接改善 | 最容易忽略的代价 |
|---|---|---|---|---|
| 数据表示 | LEXI | 指数码本、lane 数、LUT 级数 | 减少跨裸片比特数 | 码本启动、变长包、分布漂移 |
| 物理与拓扑 | WoW Network | reticle 形状、旋转、错位、集成层次 | 提高连通度与二分带宽 | 制造规则、路由器端口、热与供电 |
| 设计自动化 | ChiSER | 切分、带宽、缓存、MAC、映射 | 更可信地筛选 Pareto 候选 | 代理模型越界与标注成本 |
| 运行时映射 | HiBand | 分组、head 交错、带宽聚合、NoC 模式 | 让分布式垂直带宽被算子利用 | 调度控制、在途包与动态负载 |
它们不是互斥方案。一个可能的组合系统可以先由 ChiSER 搜索 reticle 数量、带宽与缓存,再采用 WoW 几何拓扑连接裸片;运行时由 HiBand 式映射限制通信半径,而需要跨组或跨裸片传输的 BF16 流再由 LEXI 无损压缩。真正困难之处在于局部优化会互相改变假设:压缩改变包长分布,包长改变路由拥塞;拓扑改变映射代价,映射又改变代理模型的训练域。
因此,下一代工具不应把这四层完全割裂。至少需要让仿真与搜索传递以下信息:
- 编码后真实消息长度,而不是固定压缩率;
- 从 floorplan 导出的链路长度、端口数和故障图;
- attention、FFN、MoE dispatch 等阶段化通信跟踪;
- buffer、端口、归约与多播产生的核内非线性;
- 面积、良率、封装、热和能耗共同构成的成本。
对推理系统设计的五点启示
第一,带宽优化应先问“搬什么”。LEXI 表明,即使不改变数值精度,也能利用字段级统计冗余;对 KV Cache、激活和权重分别选择离线或在线策略,比给所有数据套同一种压缩更合理。
第二,先进封装不是透明导线。WoW 的物理重叠直接决定图结构,reticle 几何、切割和路由算法必须协同。只把封装提供的带宽填进系统模拟器,会遗漏拓扑自由度和物理限制。
第三,快但失真的模型会选错架构。DSE 的风险不只是预测误差,而是候选排序和约束判断错误。ChiSER 的粗到细方法比“所有候选都跑最慢模型”现实,也比只在最后用高保真模型验收更早地影响搜索方向。
第四,消除一个瓶颈会暴露下一个瓶颈。HB-DRAM 提高垂直带宽后,NoC、数据放置和调度成为主导。HiBand 的价值正在于不把新内存当作更快的旧内存,而是重新组织并行与网络。
第五,真实流量比峰值规格更重要。无论是 LEXI 的每层指数分布、WoW 的 Llama 跟踪、ChiSER 的核内 tile 行为,还是 HiBand 的分阶段通信,最终结果都依赖工作负载结构。峰值 TOPS、TB/s 和键合密度只有与实际映射结合,才会转化为 token/s、TTFT 与 TPOT。
总结
这四项工作构成了一条完整的 Chiplet 推理优化链:LEXI 从表示层减少字节,WoW 网络从物理层缩短路径并增加连通,ChiSER 从工具层搜索可信组合,HiBand 从映射与运行时层调度分散带宽。
它们共同指向一个趋势:Chiplet 与 3D 集成的竞争焦点,正在从“能否提供更多裸片和更宽接口”转向“能否让算法、数据流、拓扑、封装和工具共同兑现这些接口”。物理峰值仍然重要,但决定推理效率的,是经过编码、路由、拥塞和调度之后剩下的有效带宽。
参考资料
- Miao Sun et al., LEXI: Lossless Exponent Coding for Efficient Inter-Chiplet Communication in Hybrid LLMs, arXiv:2603.15589, 2026.
- Patrick Iff et al., Network Design for Wafer-Scale Systems with Wafer-on-Wafer Hybrid Bonding, arXiv:2603.05266, 2026.
- SPCL, Network Design for Wafer-Scale Systems — official implementation, 2026.
- Yi-Cheng Lo and Siva Satyendra Sahoo, ChiSER: Surrogate-Enhanced Resource-aware Exploration of Chiplet-based Deep Neural Network Accelerators, DAC 2026.
- Siva Satyendra Sahoo, ChiSER official project page, 2026.
- Huanyu Wang et al., HiBand: A Hierarchical Bandwidth-Aware HB-DRAM Accelerator with Array-Level Co-Execution and Reconfigurable NoC for LLM Inference, DAC 2026.
- UCIe Consortium, UCIe Specifications, 2026.
- TSMC, 3DFabric: System on Integrated Chips and advanced packaging.
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



