


DistServe 完全拆解:拆开 Prefill 与 Decode,按 Goodput 调度大模型推理
为什么 Prefill 与 Decode 不该挤在同一批次
一条大模型请求在 GPU 上并不是一种工作负载,而是两种几乎相反的工作负载首尾相接:
- Prefill 接收长度为 的提示词,一次并行计算整段序列,生成第一个 token,并为每一层写出 Key/Value 缓存。矩阵乘法的 维通常足够大,较容易把 Tensor Core 喂满,因此长提示词下主要受计算吞吐限制。
- Decode 每轮只加入一个 token,却要逐层读取模型权重和此前全部 KV Cache。小 batch 时矩阵乘很“瘦”,算术强度低,通常先撞上 HBM 带宽;它还要重复几十到几千轮,因此单轮抖动会直接破坏流式输出的平滑度。
DistServe 由北京大学、加州大学圣迭戈分校等团队于 2024 年发表在 OSDI 2024。它抓住的不是“两个阶段快慢不同”这么简单,而是两个阶段在共置系统中有两层耦合。
第一层是执行干扰。连续批处理会在每个调度迭代中把新到的 Prefill 与存量 Decode token 拼成一个 batch。加入一条长 Prefill 后,本轮 kernel 变长,所有正在流式生成的请求都必须等待,于是 TPOT 出现尖峰;反过来,Decode token 也会占用计算和显存带宽,使 Prefill 的 TTFT 增加。连续批处理提高了总 token 吞吐,却未必提高按时完成的请求数。连续批处理的调度基础可参考 连续批处理完全拆解。
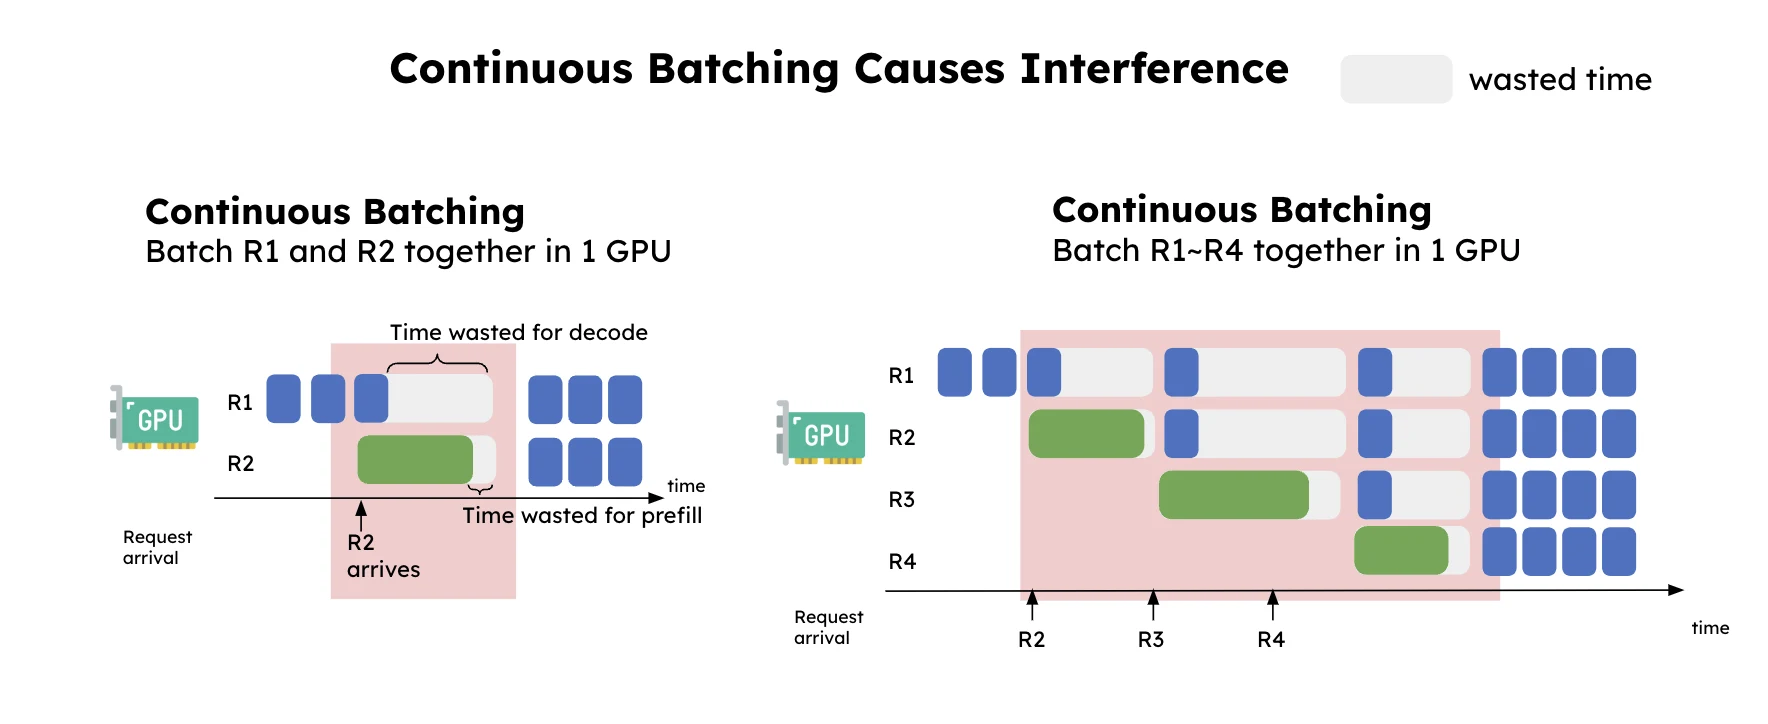
图源:DistServe 作者团队技术解读。图左展示一次 Prefill 如何拉长同批 Decode 的迭代,图右把这种局部干扰展开成时间线:只要 Prefill 持续到达,Decode 请求的 token 间隔就周期性变长。关键问题不是平均 TPOT 略有上升,而是 P90、P99 尾延迟更容易越过 SLO。
第二层是资源与并行策略耦合。共置实例只能保留一份模型,也就被迫让 Prefill 与 Decode 使用同一套张量并行、流水线并行和副本数。可它们的偏好并不相同:严格 TTFT 往往需要更高张量并行度来缩短单条 Prefill 的执行时间;Decode 则更希望积累较大的连续 batch,并用复制或流水线并行扩大吞吐。用一组旋钮同时调两种阶段,往往只能折中。
Sarathi-Serve 的分块 Prefill 是另一条路线:把长 Prefill 切小,再与 Decode token 混排,以限制一次迭代的工作量。它能缓和干扰,但不能消除共享 GPU 的竞争;把 Prefill 切成 块后,后续块还要反复读取先前块的 KV,累计读入量呈 增长,而不分块是 。其调度机制可参考 Sarathi-Serve 完全拆解。DistServe 选择更彻底的做法:让两个阶段不再共享 GPU。
从吞吐量到 Goodput:DistServe 真正优化什么
只报告“每秒完成多少请求”会掩盖一个事实:服务可以在积压越来越严重时保持很高吞吐,但大量请求已经迟到。DistServe 因此把优化目标改为 Goodput,即在给定延迟目标与达标比例下,系统能够承受的最大到达率。
设请求到达率为 ,请求 的首 token 延迟与平均输出 token 延迟分别为 、;两项 SLO 上限为 、,要求至少比例 的请求同时达标。可写成:
这里 是 goodput,单位通常为 requests/s; 可以是 90% 或 99%。逻辑连接词“且”很重要:只满足 TTFT 或只满足 TPOT 都不能算合格请求。论文进一步用每 GPU goodput 比较配置:
它把服务质量和硬件成本放进同一个指标。若系统 A 能跑 10 rps,但只有 30% 请求同时满足 SLO;系统 B 在 6 rps 下有 95% 请求达标,那么在 的定义下,A 的可用 goodput 甚至可能低于 B。吞吐量回答“GPU 做了多少工作”,goodput 回答“每块 GPU 交付了多少合格服务”。
论文中的一个合成例子很能说明资源配比。13B 模型在 A100-80GB 上处理 512 token 输入、生成 64 token,采用泊松到达:共置实例受 TPOT 约束只能承受约 1.6 rps。拆分后,单个 Prefill GPU 约能承受 5.6 rps,单个 Decode GPU 约能承受 10 rps。若部署 2 个 Prefill 实例和 1 个 Decode 实例,则整组容量为:
取最小值是因为请求必须先经过 P 再经过 D,任一阶段容量不足都会形成瓶颈。这个例子也揭示 P/D 分离的本质收益:不是“搬一次 KV 就自动变快”,而是解锁不同实例数量的非对称配比,并让每个阶段分别选择最合适的并行方式。
架构总览:两个 GPU 池与一条 KV 传输路径
DistServe 的运行时由中心控制器、Prefill 实例池、Decode 实例池和 KV Cache 传输通道组成。每个“实例”都保存一份完整模型的逻辑副本,但该副本可以通过张量并行或流水线并行横跨多块 GPU。
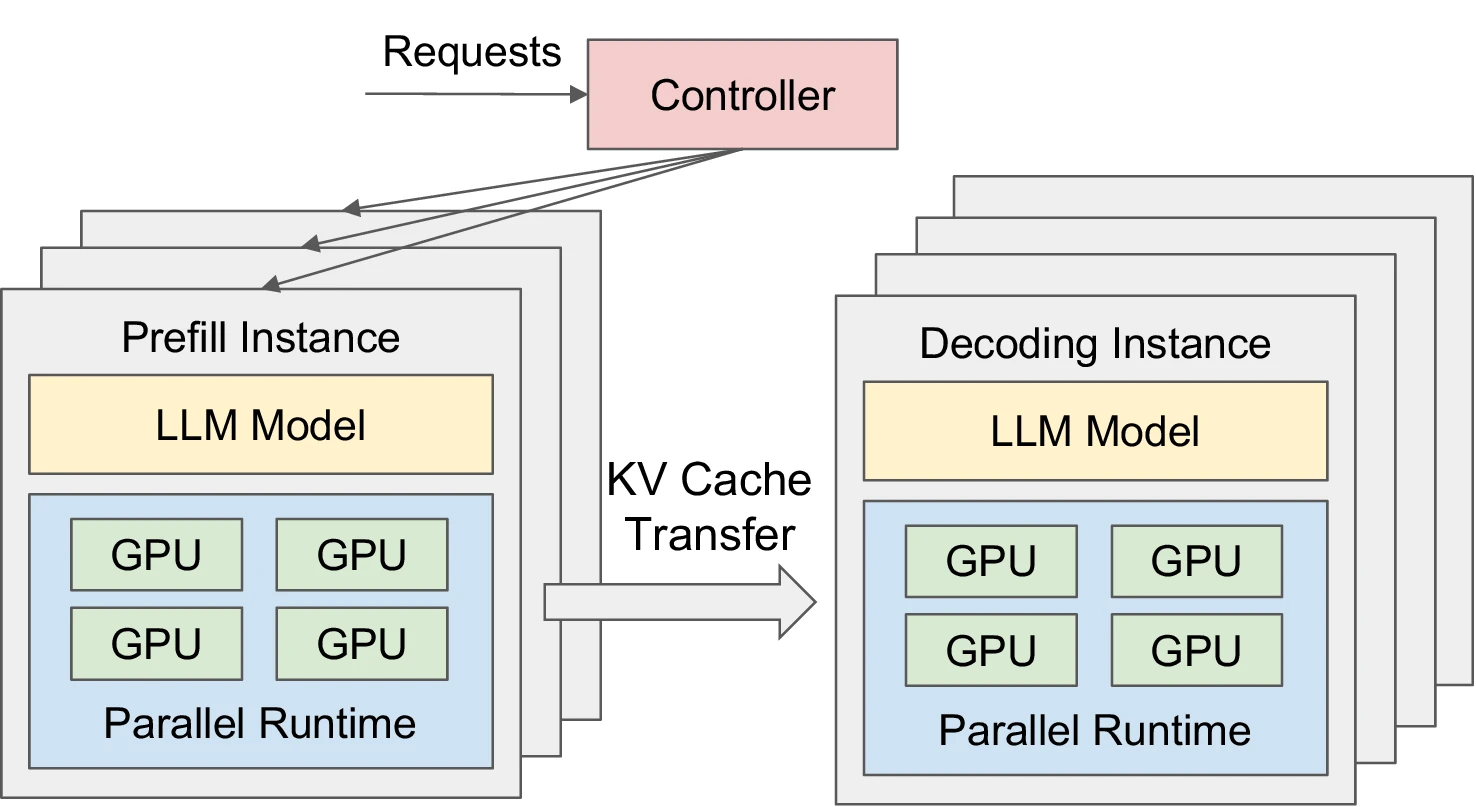
图源:DistServe OSDI 2024 论文,由论文源文件中的 Figure 6 转换。图中请求先进入控制器,再被送到 Prefill 实例;完成首 token 后,Decode 端按需拉取对应 KV Cache,随后独立执行连续解码。右侧每个实例内部仍可采用模型并行,这一点决定了 DistServe 不只是简单的“两台机器分工”。
控制面与数据面分工如下:
- 中心控制器接收请求,按最短队列把它交给 Prefill 实例。
- Prefill 实例执行完整提示词,产生第一个 token,并暂存各层 KV Cache。
- 控制器为请求选择负载最低的 Decode 实例;Decode 端不是等待 Prefill 主动推送,而是在有接纳能力时拉取 KV Cache。
- KV 到位后,Decode 实例把请求加入连续批处理,每轮生成一个 token,直至遇到停止条件。
- 工作负载画像器监控到达率、输入长度和输出长度;分布明显漂移时,离线放置模块重新搜索实例并行度与副本比例。
“拉取”而非“推送”是容易被略过的关键设计。如果 Prefill 完成后立刻向 Decode 推送,突发流量会让大量 KV 同时涌入 Decode HBM;即使计算队列尚未消费,它们也会先占满显存。拉取模式把 Prefill GPU 的剩余显存当成阶段间缓冲:Decode 有空位才取,两个池可以按自己的速率推进。代价是 Prefill 实例不能立即释放这些 KV,控制器必须跟踪所有权、生命周期和超时清理。
原型的控制与编排部分约 6.5K 行 Python,执行引擎约 8.1K 行 C++/CUDA;跨节点使用 NCCL,节点内使用异步 cudaMemcpy,并集成连续批处理、FlashAttention 与 PagedAttention。PagedAttention 在这里解决 Decode 池内部 KV 块的细粒度分配,P/D 分离则解决阶段之间的资源边界,两者是正交关系。相关内存机制可参考 PagedAttention 完全拆解。
Prefill 实例:把 TTFT 约束变成批处理上限
Prefill 的目标不是盲目堆 batch,而是用最少 GPU 满足 TTFT。对给定模型和硬件,DistServe 先通过 profiling 找到能让 GPU 接近饱和的最短总提示长度 。调度规则随之变得直接:多个短请求可以合批,使 token 总数接近 ;单条长度已经超过 的请求则独立执行。超过计算饱和点后继续扩大 batch,不会显著提高设备效率,只会让同批所有请求更晚得到首 token。
为了解释 Prefill 为什么会在不同负载下偏好不同并行方式,论文从 M/D/1 队列出发。假设请求按速率 的泊松过程到达,单请求服务时间恒定为 ,并要求利用率 。平均 TTFT 为:
第一项是执行时间,第二项是排队时间。分母中的 表明系统接近饱和时,排队延迟不是线性增长,而是迅速发散。这也解释了为什么只测空载 kernel 延迟无法决定线上容量。
考虑两块 GPU。若做两级流水线并行,设整条流水的请求延迟为 ,最慢 stage 的服务时间为 。层间激活通信较小时,可近似 、,于是:
流水线没有明显缩短单请求穿过全部层的时间,但把稳态服务间隔从 降到约 ,因此高到达率下排队更少。
若做两路张量并行,设实际加速比为 ,通信与分片开销使 ,服务时间变成 :
低负载时排队项很小,张量并行直接缩短执行时间,因而更适合严格 TTFT;高负载时流水线的稳态吞吐优势逐渐占上风。 又受提示长度、模型结构、GPU 互联和放置位置影响,不存在“Prefill 永远用高 TP”的固定答案。DistServe 没有把这三个式子硬编码成决策器,因为真实请求长度并不恒定;它们用于揭示趋势,最终配置由真实长度分布驱动的模拟器选择。
这套分析还给出一个实用判据:如果 TTFT 主要由 主导,应优先减少单请求执行时间;如果主要由排队项主导,应扩副本或增加流水吞吐。两种问题在监控面板上可能都表现为 TTFT 高,但处理手段完全不同。
Decode 实例:连续批处理如何满足 TPOT
单条 Decode 每轮只做一个新 token。对于每层线性变换,GPU 需要读入大量权重,却只产生很小的矩阵乘;对注意力还要读取不断增长的 KV Cache。小 batch 下算术单元等待数据,扩大 batch 才能让一次权重读取服务更多请求,提高算术强度。
因此 Decode 池的第一原则与 Prefill 相反:在 HBM 容量和 TPOT 上限允许的范围内维持尽可能大的连续 batch。多条 Prefill 流汇入较少 Decode 实例,恰好可以提高 Decode batch;这就是前述 2P1D 配比能胜过三个共置副本的原因。
Decode 的 batch 也不能无限增长,至少受三道约束:
- 每条活跃序列持有全部层的 KV Cache,显存容量先限制并发数;PagedAttention 只能减少碎片和预留浪费,不能消除 KV 本身。
- batch 变大后,单轮计算时间增长;一旦超过 TPOT SLO,额外吞吐不再计入 goodput。
- 当 batch 已使矩阵乘接近 compute-bound,再加请求的边际收益迅速下降。
模型并行的选择同样受 SLO 支配。张量并行可以降低单轮 TPOT,但每层都引入集合通信,扩展收益递减;流水线并行更接近线性扩大稳态 token 吞吐,却增加请求穿过各 stage 的延迟和调度复杂度。论文的规则是:先使用足够的张量并行把 TPOT 压进目标,再优先用流水线并行或副本扩大容量。
Decode 端并非传统静态 batch。每个迭代结束后,已完成请求退出,新到且 KV 已就绪的请求加入。因此调度器需要同时维护 active batch、待拉取 KV 的候选队列和可用 KV block。DistServe 采用 FCFS 与最小负载路由,未实现抢占;长输出会长期占用 KV 和 batch 槽位,这也是系统的一个明确边界。
KV Cache 跨实例传输:省下重算,付出通信
P/D 分离增加了一项共置系统没有的成本:提示词对应的全部 KV Cache 必须从 Prefill 实例移动到 Decode 实例。对标准 MHA,单请求的 KV 字节数可估算为:
其中因子 2 对应 K 和 V, 是提示长度, 是层数, 是 KV 头数, 是单头维度, 是每元素字节数。若传输有效带宽为 ,理想传输时间为:
包含控制消息、NCCL 建链或 DMA 启动等固定开销。它说明短提示时固定开销更显眼,长提示时带宽项主导;GQA、MQA、KV 量化都能线性缩小传输量。
论文以 OPT-66B 为例:512 token 请求的 KV 约 1.13 GB;到达率 10 rps 时需要持续搬运约 11.3 GB/s,即约 90 Gbit/s。这个数字已经能压垮普通以太网,却远低于 A100 节点内 NVLink 的峰值带宽。因此“通信可忽略”不是架构公理,而是放置算法主动把对应 stage 放进高速互联域后的结果。
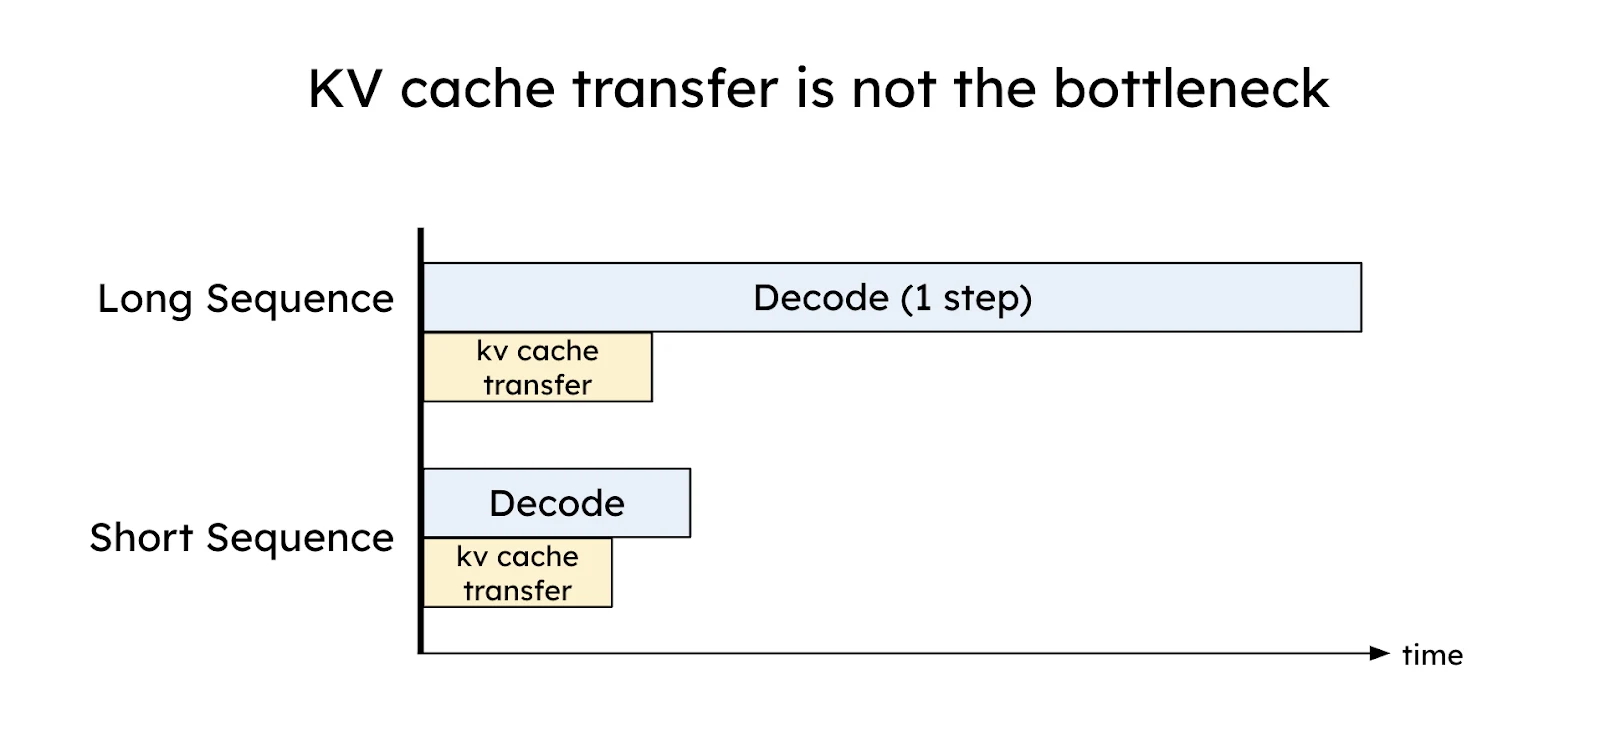
图源:DistServe 作者团队技术解读。横轴是提示长度,柱形比较不同模型的 KV 传输时间,虚线给出单次 Decode 步延迟。模型越大、提示越长,KV 越多;但模型本身的 Decode 步也更慢,所以应该比较传输与 Decode 的相对比例,而不能只看传输的绝对毫秒数。
作者给出的 OPT-175B 示例中,2048 token、约 4.5 MB/token 的 KV,经 8 条 PCIe 5.0 x16 链路、每条按 64 GB/s 估算,得到:
论文实测采用 25 Gbit/s 跨节点网络,但通过同 stage 节点内共置避免大流量跨节点;即使对 OPT-175B,KV 传输在总延迟中的占比也低于 0.1%,超过 95% 请求的传输延迟低于 30 ms。这里的“低于 0.1%”来自整条请求生命周期的累计分解,不意味着单次传输对极严格 TTFT 永远无感。
还要防止两种错误估算。第一,只按最终生成 token 数计算 KV;P/D 交接搬的是整段提示词在全部层的 K/V。第二,用标称 NVLink 或 PCIe 带宽直接除;实际有效带宽还受拓扑、并发流、分片方式与拷贝粒度影响,部署前必须测 BW_eff。
三步放置算法:并行配置、实例配比与节点映射
DistServe 的输入不只是一组 GPU。放置器接收模型结构、GPU 数量与显存、每节点 GPU 数、工作负载的输入/输出长度分布、到达过程、TTFT/TPOT SLO 和达标比例,输出三类决定:P、D 各自用什么并行配置;各部署多少实例;每个 stage 落在哪些物理 GPU 上。
第一步:枚举阶段内并行配置
设单实例允许跨越至多 个节点,每节点 块 GPU。算法枚举可行的张量并行度 和流水线并行度 ,并先用显存条件过滤:
对每个配置,性能模拟器用历史请求分布生成到达事件,预测执行时间、排队、TTFT 与 TPOT,再通过二分搜索找到满足达标比例的最大请求率。Prefill 和 Decode 分别选择每 GPU goodput 最高的配置,而不是共同选择一套配置。
模拟器的时延模型来自算子 FLOPs 与内存访问量,并由真实 profiling 校准。论文将模拟与真机 SLO attainment 对比:在 1.0 到 4.0 rps 的测试点上,误差均小于 2%。这并不保证跨硬件直接泛化;更准确的理解是,DNN 推理执行时间相对可预测,只要在目标硬件上重新标定模型。
第二步:按容量复制实例
若单个 Prefill 配置 goodput 为 、Decode 配置为 ,目标流量为 ,最低副本数分别为:
这一步把“2P1D”从经验调参变成容量规划。线上仍需留出突发余量,因为 、 是给定流量分布和达标目标下的估计,不是永远不变的常数。
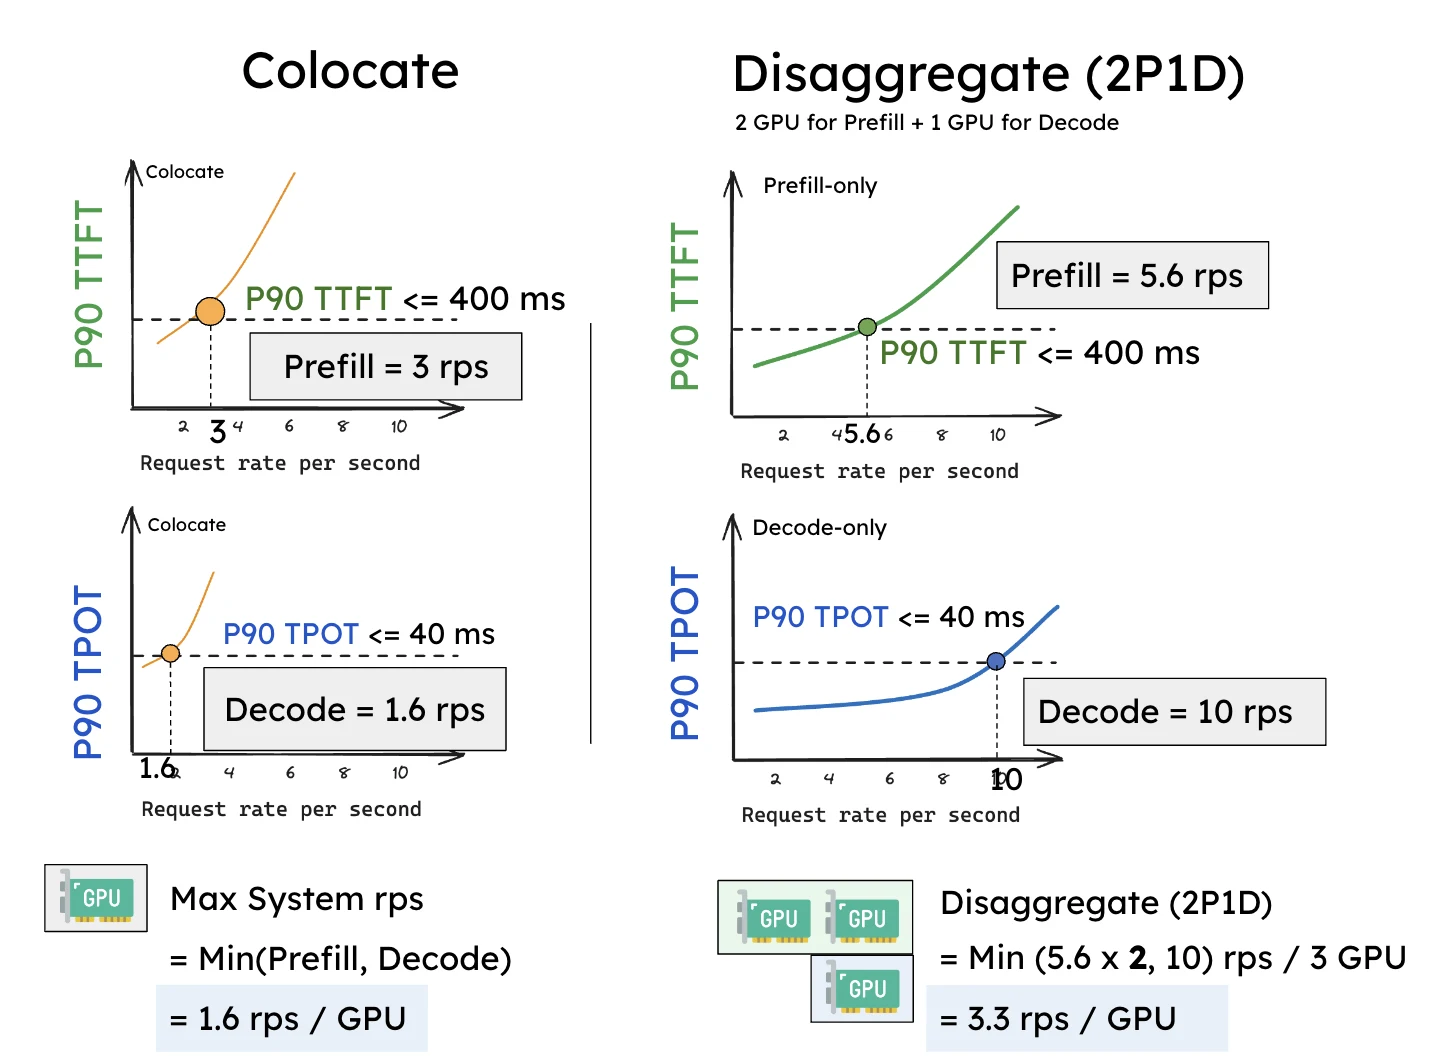
图源:DistServe 作者团队技术解读。左侧共置实例的 Prefill 与 Decode 容量只能同比扩展;右侧拆分后,两个 P 实例可以喂给一个 D 实例,使两阶段容量更接近,减少一侧闲置。
第三步:根据网络亲和性映射 stage
高带宽跨节点网络下,P 与 D 可以相对独立地放置,搜索复杂度为 ,论文最大设置的求解时间低于 1.3 分钟。低带宽跨节点网络下,问题更棘手:OPT-175B 的 FP16 权重约 350 GB,两份模型需要约 700 GB,已经超过单个 8×80 GB 节点的 640 GB,不能简单把一整对 P/D 实例塞进同一节点。
DistServe 利用“第 层的 KV 只会从 Prefill 的第 层传给 Decode 的第 层”这一局部性。它先用流水线并行把模型切成 stage,再把 P 与 D 的同编号 stage segment 放在同一节点。大模型的两份完整权重仍可跨多个节点展开,但大体量 KV 交接被约束在节点内 NVLink;跨节点只保留流水线激活等较小通信。低亲和算法联合枚举流水线级数以及节点内 P、D segment 的张量并行配置,条件是每节点总 GPU 数不超过 。
这也是论文最有系统价值的部分:P/D 分离并不是把服务拆成两个 Kubernetes Deployment 就结束。实例比例、模型并行和物理拓扑必须共同规划,否则 KV 传输会把计算收益全部吃掉。
一次请求如何穿过 DistServe
把系统机制压到一条请求的时间线上,可以看到 TTFT、TPOT 与传输分别在哪里产生:
- 到达与 Prefill 排队:控制器记录到达时间,查询各 Prefill 实例的排队 token 数,而不是只看请求条数。两个请求数量相同的队列,若提示长度相差十倍,预计等待时间完全不同。
- Prefill 成批:调度器以饱和阈值 为 token 预算,将多个短提示拼到接近阈值;长提示单独运行。此时计算所有层的 Q/K/V、注意力与 FFN,逐层写出提示 KV。
- 产生首 token:最后一层 logits 经采样得到第一个输出 token。到达至此的时间构成 TTFT,但请求尚未进入稳定解码。
- 选择 Decode 实例:控制器从 Decode 池选最小负载实例。负载至少应包含活跃序列数、已占 KV block、预计输出长度和待拉取 KV,而不能只看当前 batch 大小。
- 拉取 KV:Decode 发起层级对应的异步传输。P 与 D 使用相同流水 stage 划分时,每个 D stage 只从同节点的 P stage 拉取自己负责层的 KV;传完一块即可建立相应映射,不必把数据拼成连续大缓冲。
- 加入 Decode 连续批:KV 所有权与元数据就绪后,请求在迭代边界加入 active batch。后续每轮读取已有 KV、计算一个 token、追加新 KV,并流式返回结果。
- 结束与回收:命中 EOS、长度上限或取消信号后,D 端释放 KV block;P 端在确认交接完成后释放暂存副本。任何异常路径都必须有租约或超时,否则取消请求会留下 HBM 泄漏。
这条路径说明 TTFT 的定义在 P/D 系统里需要明确。若首 token 在 Prefill 端直接返回,传统 TTFT 不包含 KV 传输;但第二个 token 必须等交接完成,首个 token 间隔可能异常长。生产监控应同时记录 TTFT、首个 inter-token latency、稳态 TPOT 和传输时间,避免用一个均值掩盖阶段边界气泡。
实验结果应该怎样读
论文在 4 个节点、共 32 块 SXM A100-80GB 上评测;每节点 8 卡并由 NVLink 连接,跨节点网络只有 25 Gbit/s。模型为 FP16 OPT-13B、66B、175B。作者特意选择使用传统 MHA 的 OPT,让 KV 传输压力大于采用 GQA/MQA 的现代模型。请求时间戳由泊松过程生成,长度从真实数据集采样。
| 场景 | 模型与数据 | TTFT SLO | TPOT SLO | 主要瓶颈 |
|---|---|---|---|---|
| 聊天 | OPT-13B / ShareGPT | 0.25 s | 0.10 s | 两项都重要 |
| 聊天 | OPT-66B / ShareGPT | 2.5 s | 0.15 s | TPOT 易被 Prefill 干扰 |
| 聊天 | OPT-175B / ShareGPT | 4.0 s | 0.20 s | 容量与拓扑约束 |
| 代码补全 | OPT-66B / HumanEval | 0.125 s | 0.20 s | 极严 TTFT |
| 长文摘要 | OPT-66B / LongBench | 15 s | 0.15 s | 长 Prefill 干扰 TPOT |
所有主结果以至少 90% 请求同时满足两项 SLO 为门槛。与 vLLM 相比,DistServe 在 ShareGPT 聊天负载上承受 2.0–4.6 倍请求率;与 DeepSpeed-MII 相比为 1.6–7.4 倍。代码补全上,相对 vLLM 的最大请求率为 5.7 倍、可承受的 SLO 收紧幅度为 1.4 倍;长文摘要上分别为 4.3 倍和 12.6 倍。不同场景的收益差异正好对应机制:代码补全由 TTFT 主导,Prefill 独立选择更高张量并行度;长文摘要的输入很长,分离后 Decode 不再被长 Prefill 反复打断。
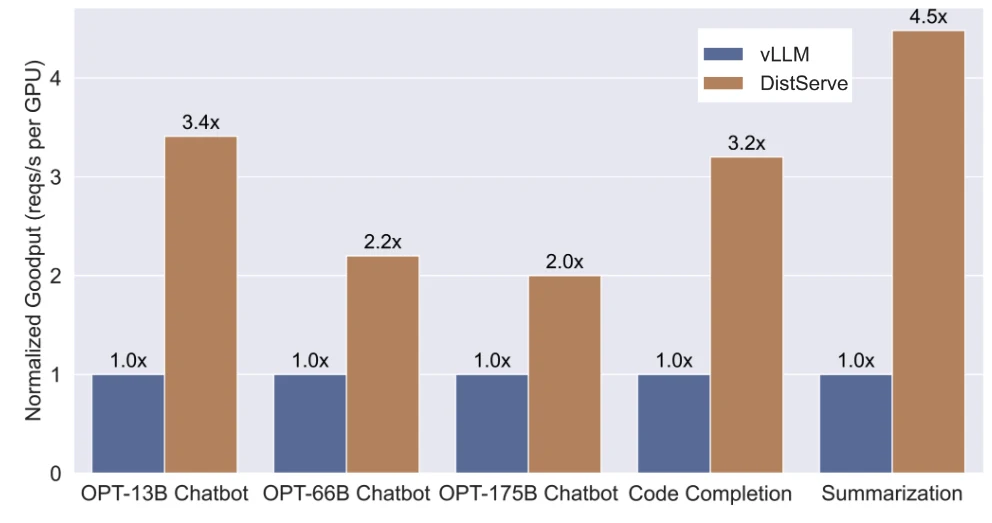
图源:DistServe 作者团队技术解读。图中的倍率必须连同模型、数据集、SLO 和 90% attainment 一起引用,不能脱离口径概括成“P/D 分离固定提升若干倍”。
消融实验还提供了两个重要信息。第一,把 vLLM 的并行配置也枚举一遍得到 vLLM++,并没有消除差距;在 OPT-66B/ShareGPT 上,默认 4 路张量并行已经是其每 GPU goodput 最佳配置,说明仅调并行度无法解除阶段耦合。第二,假设高跨节点带宽的 DistServe-High 优于带同 stage 共置约束的 DistServe-Low,说明网络拓扑确实压缩了可选放置空间。
这些结果不能直接外推到任意现代集群。A100、OPT、FP16、MHA 和泊松到达共同定义了实验边界。GQA 会显著减少 KV 传输,却也改变 Decode 的显存容量与 batch 上限;H100/B200 的算力带宽比、NVLink 拓扑和低精度 kernel 又会改变 与最佳并行度。可迁移的是“基于目标硬件和流量重新 profiling、模拟和搜索”的方法,而不是论文附录里的具体 TP/PP 数字。
与共置、Sarathi-Serve 和现代 P/D 系统的边界
三类方案解决的是不同约束,不能简单排成一条绝对优劣榜。
| 方案 | Prefill 与 Decode | KV 交接 | 主要优势 | 主要代价 |
|---|---|---|---|---|
| 共置连续批处理 | 同一实例、同一 GPU 池 | 无 | 架构简单,权重只放一份 | 阶段干扰,并行与容量耦合 |
| 分块 Prefill / Sarathi-Serve | 仍共置,以 token budget 混排 | 无 | 少量 GPU 也能部署,离线吞吐友好 | 分块开销,无法彻底隔离尾 TPOT |
| DistServe / P/D 分离 | 独立 GPU 池 | 必须传 KV | 独立扩缩、独立并行,尾延迟可控 | 双份权重、网络与路由复杂度 |
如果只有一两块 GPU,模型副本本就放不下两份,DistServe 的设计空间几乎消失;共置和分块 Prefill 更合理。如果任务是离线批量生成,没有严格 TTFT/TPOT,优化总 token throughput 比 goodput 更重要,混排能减少空泡,也可能优于分离。如果线上同时约束首 token 和流式间隔,流量足以形成稳定 Decode batch,且有高速互联,P/D 分离才最能发挥价值。
Splitwise 与 DistServe 是同期的两条 P/D 分离路线。Splitwise 更强调根据 Prompt/Token 两阶段特征选择同构或异构 GPU,并从吞吐、成本、功耗构建集群;DistServe 更强调给定 TTFT/TPOT 后的 per-GPU goodput、并行配置与带宽感知放置。二者共同证明“阶段分离”是架构层机会,但目标函数不同。
现代框架把论文概念拆成可插拔 KV transport。以 vLLM 的 disaggregated prefilling 为例,P、D 是独立实例,通过 NIXL、NCCL P2P 或外部 KV 层连接;官方文档也明确提醒,分离本身不保证提高吞吐,其直接价值是分别调 TTFT 与 inter-token latency、控制尾 ITL。DistServe 的历史意义正在这里:它给出的不是一个万能加速开关,而是一套判断分离是否值得、P/D 如何配比、KV 应该走哪条链路的优化框架。
后续系统还可以在“完全分离”和“完全共置”之间动态切换。例如严格 TPOT、宽松 TTFT 时偏向分离;严格 TTFT、宽松 TPOT 时,共置可能避免交接延迟和双份权重;负载变化时采用混合实例。DistServe 的静态周期重规划是起点,不是这个设计空间的终点。
工程实现清单与常见误区
实现 P/D 分离时,先把以下量测清楚,再决定拓扑和副本数:
- 工作负载画像:输入长度、输出长度、到达间隔不能只有均值,至少保留 P50/P90/P99、联合分布与突发窗口。长输入和长输出是否相关,会影响两个池是否同时拥塞。
- 阶段性能曲线:测 Prefill 在不同总 token 数、TP/PP 下的执行时间,找到 ;测 Decode 在不同 batch、上下文长度、TP/PP 下的单步延迟和吞吐。
- KV 账本:按模型真实的 KV 头数、数据类型和层数计算 bytes/token;把块元数据、对齐和临时 staging buffer 计入峰值显存。
- 链路矩阵:逐 GPU 测节点内与跨节点的单向带宽、双向带宽、小消息启动延迟和并发传输退化,不能只抄硬件标称值。
- SLO 判定:每条请求同时判 TTFT 与 TPOT,按请求而不是按 token 统计 attainment;另外记录首 token 后第一次间隔,识别交接气泡。
- 容量保护:D 端采用 pull、准入控制和显存水位;P 端 KV 暂存要有租约,客户端取消、P/D 故障和传输超时都必须回收。
- 重规划触发器:当输入长度、输出长度或到达率分布持续越过阈值时重跑搜索;短时尖峰优先由余量和背压处理,避免频繁搬模型。
一个简化的容量规划循环可以写成:
profile(model, gpu, topology)trace = fit_recent_request_distribution()
for p_config in feasible_parallel_configs: g_p[p_config] = simulate_prefill(trace, p_config, ttft_slo)
for d_config in feasible_parallel_configs: g_d[d_config] = simulate_decode(trace, d_config, tpot_slo)
choose configs and replica counts that maximize: min(total_prefill_goodput, total_decode_goodput) / total_gpus
verify the chosen placement with an end-to-end replay这里的最后一行不可省略。阶段模拟器可能分别准确,却遗漏共享网络争用、控制器热点、NCCL communicator 建立、Python 调度抖动或多租户干扰。最终容量必须由端到端 trace replay 验证,并留出故障和流量误差余量。
常见误区有四个:把 P/D 分离等同于两个固定副本,未按流量调整比例;只优化平均 TTFT/TPOT,忽略尾部;只测裸 KV memcpy,不测与推理并发时的有效带宽;认为首 token 已返回就完成交接,忽略第一个输出间隔异常。它们都会让实验室平均值很好看,却让线上 goodput 下降。
局限与适用条件
DistServe 的收益建立在“用更多结构换取更少干扰”上,因此有清晰代价。
- 权重复制成本:P 与 D 各持一份逻辑模型。对超大模型,权重容量可能比 KV 网络更先决定能否分离。
- 故障域扩大:一个 D 实例可能接收多个 P 实例的请求;D 故障会连带影响已经完成 Prefill 的请求。论文原型没有完整故障恢复。
- FCFS 车队效应:极长提示会阻塞其后的短提示。抢占、长度感知排队或 deadline 调度与分离正交,但原型没有实现。
- 静态计划滞后:周期重规划依赖历史分布。流量在秒级切换时,重新加载权重需要分钟量级,无法立刻跟随。
- 网络隔离假设:同 stage 共置能把 KV 留在 NVLink 域,却会限制 TP/PP 组合;多租户共享互联时,有效带宽也可能远低于离线测量。
- 指标边界:goodput 依赖人为设定的 SLO 与 attainment。不同业务目标下,同一部署的排名可能反转。
长上下文既放大代价,也放大机会。KV 传输量随提示长度近似线性增长;标准全注意力 Prefill 计算则随长度近似二次增长,因此传输相对 Prefill 的比例可能下降。同时长 Prefill 对共置 Decode 的干扰更严重。若模型使用稀疏或线性注意力,计算复杂度不再按二次增长,这个判断必须重算,不能沿用标准 Transformer 的直觉。
适用 DistServe 的典型条件可以概括为:多 GPU/多节点在线服务、TTFT 与 TPOT 都有明确 SLO、流量足以形成 Decode batch、集群存在 NVLink 或高带宽 RDMA、工作负载分布在分钟到小时尺度相对稳定。缺少其中多项时,应先比较共置、分块 Prefill 和分离三条曲线,而不是默认选择最复杂架构。
小结
DistServe 把一条 LLM 请求拆成两个可独立规划的服务阶段。Prefill 是一次性、计算密集并直接决定 TTFT;Decode 是长时间、带宽敏感并直接决定 TPOT。共置会造成执行干扰,也会把两者的并行方式和副本数绑死。
P/D 分离真正带来三项自由度:为两个阶段选择不同 TP/PP,为两池配置不同实例数,以及按物理拓扑安排 KV 交接。代价则是两份权重、KV 传输、跨池背压和更大的故障域。DistServe 用 goodput 将延迟达标与 GPU 成本统一起来,再用 profiling、离散事件模拟和带宽感知放置搜索这些自由度。
最重要的工程结论不是“分离一定更快”,而是先定义 TTFT/TPOT 与达标比例,再测阶段曲线和链路,最后比较每 GPU 合格请求数。只有当消除干扰与独立扩缩的收益大于复制和交接成本时,P/D 分离才是正确答案。
参考资料
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving(OSDI 2024)
- DistServe arXiv 论文与源文件
- LLMServe/DistServe 官方代码仓库
- Throughput is Not All You Need:DistServe 作者团队技术解读
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- Orca: A Distributed Serving System for Transformer-Based Generative Models
- vLLM Disaggregated Prefilling 文档
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


