


扩散模型从零讲起(十六):文本条件是怎么来的——CLIP/T5 编码器、提示词加权与组合性失败
写在前面:这一篇在系列里的位置
这个系列从 DDPM 的两条高斯链讲起,依次拆开了 DDIM、score matching、flow matching、DiT 主干、掩码离散扩散、dLLM 推理系统、潜空间扩散、视频与音频扩散、采样器、蒸馏、推理加速、架构演进、连续时间 SDE、CFG 引导、图像编辑与 ControlNet 条件适配器。到这里,扩散模型的数学骨架、主干结构和推理工程三条线都已经铺完。
但有一块内容一直以“配角”身份出现:文本提示词是怎么变成网络能吃的条件向量的。第四篇讲条件注入时,把文本表示 当作已经存在的张量直接用了;第十三篇讲 CFG 时,也默认条件嵌入已经算好。实际系统里,这一步前后有一串容易被忽略、却直接影响成图质量和延迟的环节:tokenizer 怎么切词、为什么稳定扩散的提示词上限是 77 个 token、超长提示词怎么处理、(word:1.3) 这种加权语法在数学上到底改了什么、为什么两个物体的颜色会互相串。
这篇把这条链路从头到尾拆开。它既是文本条件这条线的完整交代,也是整个“基础”部分的收尾:讲完这一篇,从加噪去噪的数学,到主干结构、条件注入、采样与加速,再到文本前端,扩散模型的基础拼图就齐了。
问题的起点:去噪网络看不到文字
文本是离散符号,网络只接受连续张量
Transformer 和卷积网络的操作对象都是浮点数张量。“一只戴墨镜的猫”这七个汉字,在进入网络之前必须先经过三层变换:
- 切分:把字符串切成词表里的单元(token),每个单元对应一个整数 ID;
- 嵌入:用一张可学习的查找表把 ID 映射成 维向量;
- 上下文化:让这些向量过若干层注意力,使每个位置的向量吸收上下文信息。
扩散模型的条件通路接的是第三步的输出。具体来说,设提示词 被切成 个 token,文本编码器 输出一个矩阵
其中 是 token 数, 是编码器的隐藏维度。第四篇里 cross-attention 的键和值就是从 投影出来的:,。所以文本编码器的输出质量、序列长度、以及它如何处理填充位置,都会沿着 一路传进每一次去噪前向。
这里有个容易被忽略的事实:扩散主干对文本的理解能力,上限由文本编码器决定。主干只负责“把条件向量翻译成像素”,它没有词表,也没有语言模型。SD1.5 用的是 2021 年的 CLIP ViT-L/14 文本塔,它对“左边”“第三个”“倒映在”这类关系词的表征能力,直接决定了模型能不能听懂空间关系。
一个反直觉的现象:条件长度是固定的
在自回归语言模型里,序列长度随输入变化,短 prompt 就是短。扩散模型的文本条件长度在多数实现里是固定的:SD1.x 与 SD2.x 固定 77,SDXL 固定 77(两路编码器各自 77,沿通道拼接),Flux 的 T5 分支固定 512(不足补零)。
固定长度的原因不在主干,而在文本编码器自身的位置编码:CLIP 文本塔使用一张长度为 77 的可学习位置嵌入表,第 78 个位置没有对应的向量。想在推理时临时加长,就要面对没训练过的位置编码。
这个设计带来两个直接后果:
- 短提示词并不省算力。一句话十个词,也要按 77 个位置跑完编码器和 cross-attention。第七十七个位置和第十一个位置的计算量一样。
- 长提示词会被截断。超过上限的部分直接丢弃,除非在编码前做分块。
后面会看到,这两点分别对应工程上的“填充税”和“分块拼接”。
第一层:从字符串到 token——BPE 在提示词上都发生了什么
BPE 的基本单位是字节级子词
稳定扩散默认的 CLIP 文本塔使用 OpenAI 的 CLIP tokenizer。它的底层是字节对编码(Byte-Pair Encoding,BPE):先把文本编码成 UTF-8 字节序列,每字节对应一个初始符号(共 256 个),然后按训练时统计出的“高频相邻对”反复合并,得到约 49408 个词表条目(49152 个合并结果 + 256 个基础字节 + 两个特殊 token)。
合并规则是在大规模网页文本上统计出来的,所以常见英文词往往是整词一个 token:cat、photo、detailed 都是单个 token。而中文基本没有合并成整词的机会,因为训练语料里中文占比低,绝大多数汉字按 UTF-8 的三字节拆分,一个汉字通常占 2–3 个 token。
这直接解释了中文提示词在 Stable Diffusion 上的一个常见现象:一句 20 字的中文描述,可能就要吃掉 50–60 个 token,加上开头的起始标记与结尾标记,很快就逼近 77 上限。在写中文提示词时,这一点往往比语义本身更关键。
特殊 token:SOT、EOT 与填充
CLIP 把序列包装成三段:
其中 SOT(start of text)是一个特殊 embedding,EOT(end of text)标记序列结束,pad 是填充 token。L + 2 必须小于等于 77,超出的部分被截断。
这里有个细节对理解 CFG 很重要:CLIP 的池化向量取的就是 EOT 位置的输出。官方实现里,取池化特征是“取每条序列中编号最大位置(也就是 EOT)的隐状态”。这和大多数语言模型取最后一个 token 表示的做法一致。第十二篇和第十三篇里讲的“池化条件”就是从 EOT 位置读出来的向量。
截断发生在哪里
截断在 tokenizer 之后的编码步骤,而不是 tokenize 步骤。文本先被完整切成 token 序列,然后只保留前 75 个(留两个给 SOT 与 EOT),后面的 token 不进入编码器。这意味着:
- 提示词的后半段完全不可见,不是“权重变小”,而是不存在;
- 前端没有报错,用户几乎无法察觉,成图只会表现为“某些要素丢了”;
- 换成一个更紧凑的提示词(例如把长句改成短关键词),效果常常比在原句后面加词更好。
第二层:77 个位置从哪来——位置编码决定了硬上限
因果注意力与可学习位置表
CLIP 文本塔使用的是因果掩码:第 个位置只能看到它自己和它之前的 token,与自回归语言模型的注意力一致;图像塔才是双向全注意力。官方实现里那张注意力掩码就是把上三角填成 的三角阵。之所以这样设计,是因为 CLIP 需要像语言模型一样,让末尾位置(EOT)汇总整句,池化向量正是从那个位置读出来的。
因果掩码带来一个对条件通路很关键的性质:每个位置的输出是“前缀摘要”,而不是“整句理解”。cat 所在位置的向量只看得到排在它前面的词,只有靠近末尾的位置才见过整句。因此进入 cross-attention 的 77 个键向量在信息量上是异质的:越靠后的位置携带的上下文越长。
同时,CLIP 仍然使用了一张可学习的绝对位置嵌入表,形状为 77 × d_t,在输入端与 token 嵌入相加。这张表在预训练时确定,长度不会被推理时的输入改变。正是它,而不是注意力机制,构成了 77 这个硬上限。
在 2019–2021 年 CLIP 的设计阶段,77 这个数字来自训练数据中图像描述的长度分布:训练用的图文对大多来自网页抓取的 alt-text,绝大多数不到 75 个 token。模型当时没有被要求处理更长文本,位置表也就停在了 77。
这说明 77 不是架构的硬约束,而是训练分布的产物。理解这一点之后,后续模型的做法就顺理成章:
| 模型 | 文本编码器 | 条件长度 | 位置处理 |
|---|---|---|---|
| SD1.5 | CLIP ViT-L/14 文本塔 | 77 | 可学习绝对位置表 |
| SD2.x | OpenCLIP ViT-H/14 文本塔 | 77 | 同上 |
| SDXL | OpenCLIP bigG + CLIP ViT-L/14 | 77(两路沿通道拼接) | 两张位置表,长度相同 |
| SD3 | CLIP-L + CLIP-G + T5-XXL | CLIP 两路各 77,T5 按管线配置 | T5 为相对位置偏置 |
| Flux | CLIP-L + T5-XXL | T5 分支 512 | T5 使用相对位置偏置,不设绝对上限 |
T5 这类相对位置编码的编码器没有“第 78 个位置没有向量”的问题,序列长度只受显存和算力限制。这正是 Flux 选 T5-XXL 的根本原因之一:它能处理长提示词,并且能用完整句子而非关键词堆叠来描述画面。需要说明的是,T5-XXL 预训练时使用的相对位置偏置在训练范围内也是有限度的,实际可用的长序列长度取决于微调阶段见过的长度,而不是理论无上限。
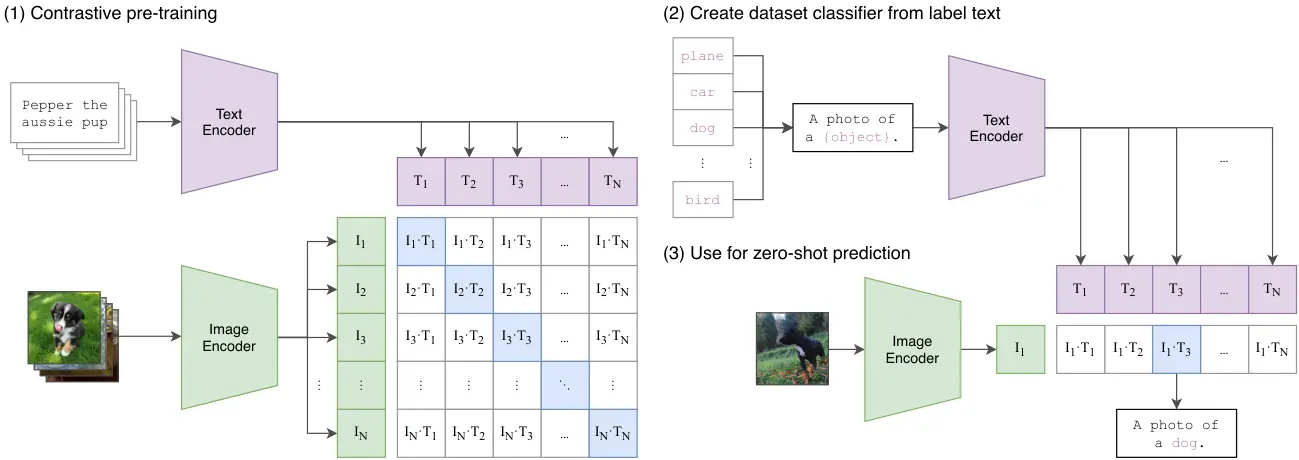
上图是 CLIP 原文的总体框图。图 (1) 是预训练阶段:左侧图像编码器把一张图变成向量,右侧文本编码器把一句描述变成向量,训练目标是让同一对(图, 文)的向量在内积空间中靠得更近,让一个 batch 内的错误配对远离。图 (2) 展示了如何把一个下游分类任务转成文本:每个类别名被填进固定模板(例如 “A photo of a {…}”),再用文本编码器编成向量,成为一组可比较的“类名向量”。图 (3) 是零样本推理:把待分类图像的向量与类名向量比较,取内积最高的类别。
这张图对扩散模型的读者有两个含义。第一,CLIP 训练的是图文对齐,不是语言建模,所以它的文本表示更擅长回答“这段描述整体像什么图”,而不是“某个词在句中担任什么句法角色”。第二,模板化类别名的做法说明 CLIP 对提示词的“模板先行”很敏感,这也解释了为什么稳定扩散对提示词结构(例如“subject, style, quality”这种关键词堆叠)比对自然句更稳。
两路编码器拼接时,位置表是两套的
SDXL 同时使用 OpenCLIP ViT-bigG 和 CLIP ViT-L/14 两个文本塔。论文描述的做法是:把两个编码器的输出沿通道维拼接,即 ,作为 cross-attention 的键值来源;同时把 OpenCLIP 的池化向量作为全局条件,与尺寸、裁剪、宽高比等条件一起拼进时间步嵌入。
注意这里拼接的是通道,不是序列位置。因此 SDXL 进入 cross-attention 的序列长度仍是 77,而不是 154;增加的是每个 token 的宽度(bigG 为 1280 维,CLIP ViT-L 为 768 维,拼起来约 2048 维)。
这里有一个容易误解的地方:两个编码器的 77 不是共享的。同一个提示词分别被两套 tokenizer 与两套位置表编码,两路输出在同一个位置上各自代表“前缀摘要”,然后被拼成更宽的向量。两路编码器并非总是分别对应 Base 与 Refiner 两个阶段,具体哪一路进入哪个模型由实现决定,但两套编码都必须做。因此 SDXL 的文本编码器算力大约是 SD1.5 的两倍,两套权重也都要常驻显存;而 cross-attention 侧增加的是投影矩阵的输入宽度,计算量按 线性增长,而不是按序列长度线性增长。
变长条件在主干侧意味着什么
无论文本多长,主干拿到的都是固定形状的 ,其中 是批大小、 是拼接后(或投影后)的特征宽度。这带来三个工程后果:
- cross-attention 的矩阵形状固定。每一层里 的维度是 ( 是图像 token 数),kernel 形状恒定,可以整段 CUDA Graph 捕获。如果条件长度可变,每换一个提示词就要变一次形状,捕获收益会大打折扣。
- 批次内不同提示词可以直接堆叠。同一 batch 里 8 个 prompt 都会被 pad 到 77,拼接成一个 张量,一次前向完成,不需要处理变长序列的打包与解包。
- 填充位置在注意力里仍然参与计算,除非显式屏蔽。对于 cross-attention,填充位置通常被 attention mask 屏蔽掉;但如果屏蔽做得不彻底,就会把“空”当作一个有效的语义位置参与打分,造成颜色或元素漂移。这是长提示词加填充场景下一类隐蔽 bug 的来源。
第三层:CLIP 的对比训练到底给了扩散模型什么
两段训练目标不一样
扩散模型并不直接使用 CLIP 的对比训练目标,它只用 CLIP 的文本塔作为固定编码器,把下游的扩散训练当作微调:主干学会把 CLIP 文本表示映射到图像的生成轨迹上。所以理解 CLIP 的关键,是弄清“它在训练时被迫学到了什么”。
CLIP 的损失是批次内对称的 InfoNCE:给定一个 batch 的 对图文,图像编码器输出 ,文本编码器输出 ,先各自做线性投影与归一化,然后算相似度矩阵
其中 是可学习的温度系数。损失是两对称交叉熵:
这个目标要求:第 个文本与第 张图的相似度,要高于它与同 batch 内其他任何一张图的相似度,反之亦然。
这个目标偏爱“整体语义”,不擅长“局部绑定”
InfoNCE 的比较单位是整段文本与整张图。它没有要求文本中的每个词在图像中被单独定位,也没有要求属性与主体之间的对应关系。于是 CLIP 学到的文本向量,倾向于编码“这张图整体像一只戴墨镜的猫”,而不是“猫在左、墨镜戴在猫眼睛上”。
这恰好就是扩散模型组合性问题的源头。主干拿到的条件表示是整体式的,cross-attention 每一层里图像 token 去查询这 77 个 token 时,注意力分布由主干自己决定,而主干只被训练成“根据这些键值重建图像”。它没有任何机制保证 cat 这个 token 必须在前景出现,也没有机制保证 red 和 hat 两个 token 绑定到同一区域。
第十三篇讲 CFG 时提到,提高 guidance 会强化条件信号,但同时也会放大绑定错误。这里能看到更底层的解释:CFG 强的只是“整体条件方向”的强度,并不能改变文本表示的颗粒度。
池化向量与序列向量是两种不同的东西
CLIP 文本塔的输出被扩散模型以两种方式使用:池化向量(EOT 位置的隐状态)和完整 token 序列。
- 池化向量是整段文本的“摘要”。DiT 的 adaLN 调制使用它,SDXL 的全局条件也使用它。它的形状是 而不是 ,因此不携带位置信息,只能表达全局风格与主题。
- 完整序列进入 cross-attention,每个 token 都有独立向量。这才是空间绑定的可能来源:图像不同位置可以去关注不同 token。
理解这个区分,就能读懂 SDXL 论文为什么要把“池化 + 序列”两路都接进主干:池化负责“整张图的调性”,序列负责“局部该画什么”。两者缺一都会出问题,只有序列容易整体漂移,只有池化则无法表达多物体布局。
跨语言提示词为什么会出现“隐性降级”
CLIP 的训练语料以英文为主,其他语言占比很小。这导致非英文提示词经过 CLIP 时,存在一层常被忽略的“隐性翻译”:tokenizer 把汉字切成字节级子词,编码器把这些子词映射到训练时见过的英文分布附近,但映射是不精确的。结果是同一句意思,用中文写与用英文写,编码得到的条件向量不是同一个点。
这个现象有两级后果:
- 语义漂移:中文提示词常常只能表达“大致是什么”,细节(材质、光线方向、构图)会被压缩成最接近的英文常见描述;
- 位置表失效:汉字占 2–3 个 token,同样意思的中文描述吃掉的位置远多于英文,在 77 上限下更容易被截断。
工程上的对策主要有三条:其一,对使用 T5-XXL 的模型(SD3、Flux 等)优先用完整自然语言描述,T5 的多语言能力明显强于 CLIP;其二,把提示词主体写成英文关键词,再用少量中文补充风格;其三,需要特定中文语义时,借助双语对齐的微调版本,而不是默认 CLIP 文本塔。这三条都不是“魔法”,只是承认 CLIP 的分布偏置客观存在。
第四层:提示词加权的数学——(word:1.3) 改了哪一步
加权语法不是扩散模型的标准部分,而是前端约定
(word:1.3)、[word]、{word} 这些写法最早来自 AUTOMATIC1111 版 WebUI 的文本前端,在 ComfyUI 等实现了同一套语法的前端里也沿用至今,属于调用侧约定,不是 CLIP 或任何文本编码器的能力。理解这一点很重要:加权发生在编码器之前或之后,具体位置决定了它在数学上究竟改了什么。
第一种做法:对文本重复加权
最朴素的做法是:把 (word:1.3) 里的词按权重重复若干次再编码。例如 (red:1.5) 变成 red red 或按轮次放大。这在实现上简单,但有三个问题:
- 重复次数只能取整数,权重精度受限;
- 每个额外 token 都占用 77 的位置,长提示词会被挤爆;
- 重复会改变句法结构,编码器看到的是一段变长的句子,而不是同一句话的放大。
这类“重复文本”的实现出现在一些简易前端脚本里,但它有三个明显的缺点,因此主流 WebUI 最终都转向了下一种做法:直接在嵌入空间缩放。缩放不占位置、权重可以是小数、也不改变句法结构。
第二种做法:对嵌入做缩放或插值
更精确的做法是在嵌入空间加权。设原文本的 token 嵌入为 ,把某些 token 的嵌入乘上系数 :
其中 是被加权词所占的位置集合。这种写法不改变序列长度,是当前多数高质量实现的选择。compel 这类前端库就采用两种模式(源码里的 DownweightMode):
MASK:对降权 token,把它的嵌入与“该位置被掩掉”的版本做线性混合,混合系数就是权重;REMOVE:直接把被降权 token 从序列中移除(会改变后续位置)。
缩放为什么有效:看 attention 的分子
把加权后的嵌入代入 cross-attention:
设第 个 token 的键向量为 ,被加权后 (当 近似线性时)。那么打分项变为
也就是说,加权等价于把某个文本 token 的 logit 整体乘以 。 时,这个 token 对任何图像位置的打分都被抬高,softmax 后它在注意力分布中的占比上升; 时反之。这里有个关键限制:softmax 是竞争关系,抬高一个 token 必然压低同一位置的其他 token。所以加权不是“只增加”,而是“重新分配”。
负向提示词的位置:CFG 不是加权
负向提示词 negative prompt: ... 常和加权混为一谈,但机制完全不同。负向提示词在 CFG 里作为无条件分支的文本:采样时算一次带负向文本的条件得分与一次带正向文本的条件得分,再按第十三篇的公式外推:
其中 在负向提示词存在时被替换为负向文本的编码。它改变的是“沿哪个方向外推”,而不是单个 token 在注意力里的权重。两者可以叠加使用,但效果不是线性可加的,这一点在后文的成本与经验部分会再遇到。
加权不只是视觉偏好,还会触发“过饱和”
经验上 超过 1.5–2 之后,常见现象是画面出现过饱和、边缘发亮、纹理崩坏。从上面的推导可以给出一个解释:把 抬得过高,等于让单个 token 在几乎所有图像位置的注意力里占主导,主干的键值空间被这一组向量“压平”,其他 token 被压制到接近零,结果就是图像失去了多要素协同。这和第十三篇讨论的高 guidance 过饱和是同一族的失效模式。
第五层:负向提示词与 CFG 的交互
负向文本的嵌入同样要过 77 位置
负向提示词走的是同一个文本编码器、同一张 77 位置表。它同样有填充与截断:负向提示词写得太长,后半段同样被丢弃。这一点在“负向提示词越写越细”的用法下很容易被忽略:你以为在压制十种元素,实际可能只压制了前几种。
负向分支的成本
标准 CFG 每步要做两次前向:条件分支与无条件分支。有条件分支带负向文本时,两个分支的文本嵌入都需要预先算好并缓存。所以对一次请求,文本编码的次数是:
- 无负向:1 次正文本编码(复用到每一步);
- 有负向:1 次正文本 + 1 次负文本编码;
- 加 guidance interval(第十三篇讲过),可只在部分步里走双分支,文本编码仍是两次,但主干前向减少。
由于文本编码只做一次、主干要做几十次,负向提示词的 FLOPs 增量主要在文本编码器侧,而主干侧的增量来自 CFG 的双分支。对 SDXL 这种两个编码器的模型,两条文本编码的固定开销在短请求里并不小。
guidance 区间与负向提示词一起用时的注意点
当 guidance interval 让某些步走单分支时,负向文本在这些步不参与计算。如果负向提示词承担的是“全局风格压制”(例如压制 watermark、blurry),把区间收窄到后半段,效果通常比全程使用更好;如果它承担的是“某类元素不得出现”的结构压制,只在前半段生效更稳。这只是经验方向,具体取值需要按模型和任务做小规模网格搜索。
空提示词不等于零向量
做 CFG 时最容易忽略的一件事:所谓“无条件分支”的文本,从来不是“没有文本”,而是一段空字符串经过同一套模板编码后的结果。以 CLIP 为例,空字符串仍然会被包成 [SOT, EOT, pad, …],SOT 与 EOT 两个位置有真实的嵌入,其余位置是填充。于是无条件分支得到的条件张量是一个非零的张量:它代表“只有起始与结束标记的文本”。
这解释了两个现象。第一,某些模型在空负向提示词下依然有稳定的默认风格,因为空字符串的编码本身就携带了一个“中性”条件;第二,若前端把空提示词处理成全零张量传给主干,结果会明显偏离,因为全零不在文本编码器训练时见过的分布里。调试时如果发现“去掉 CFG 反而风格崩坏”,先检查无条件分支是不是传了零张量而不是空字符串的编码。
第六层:组合性失败的三张面孔
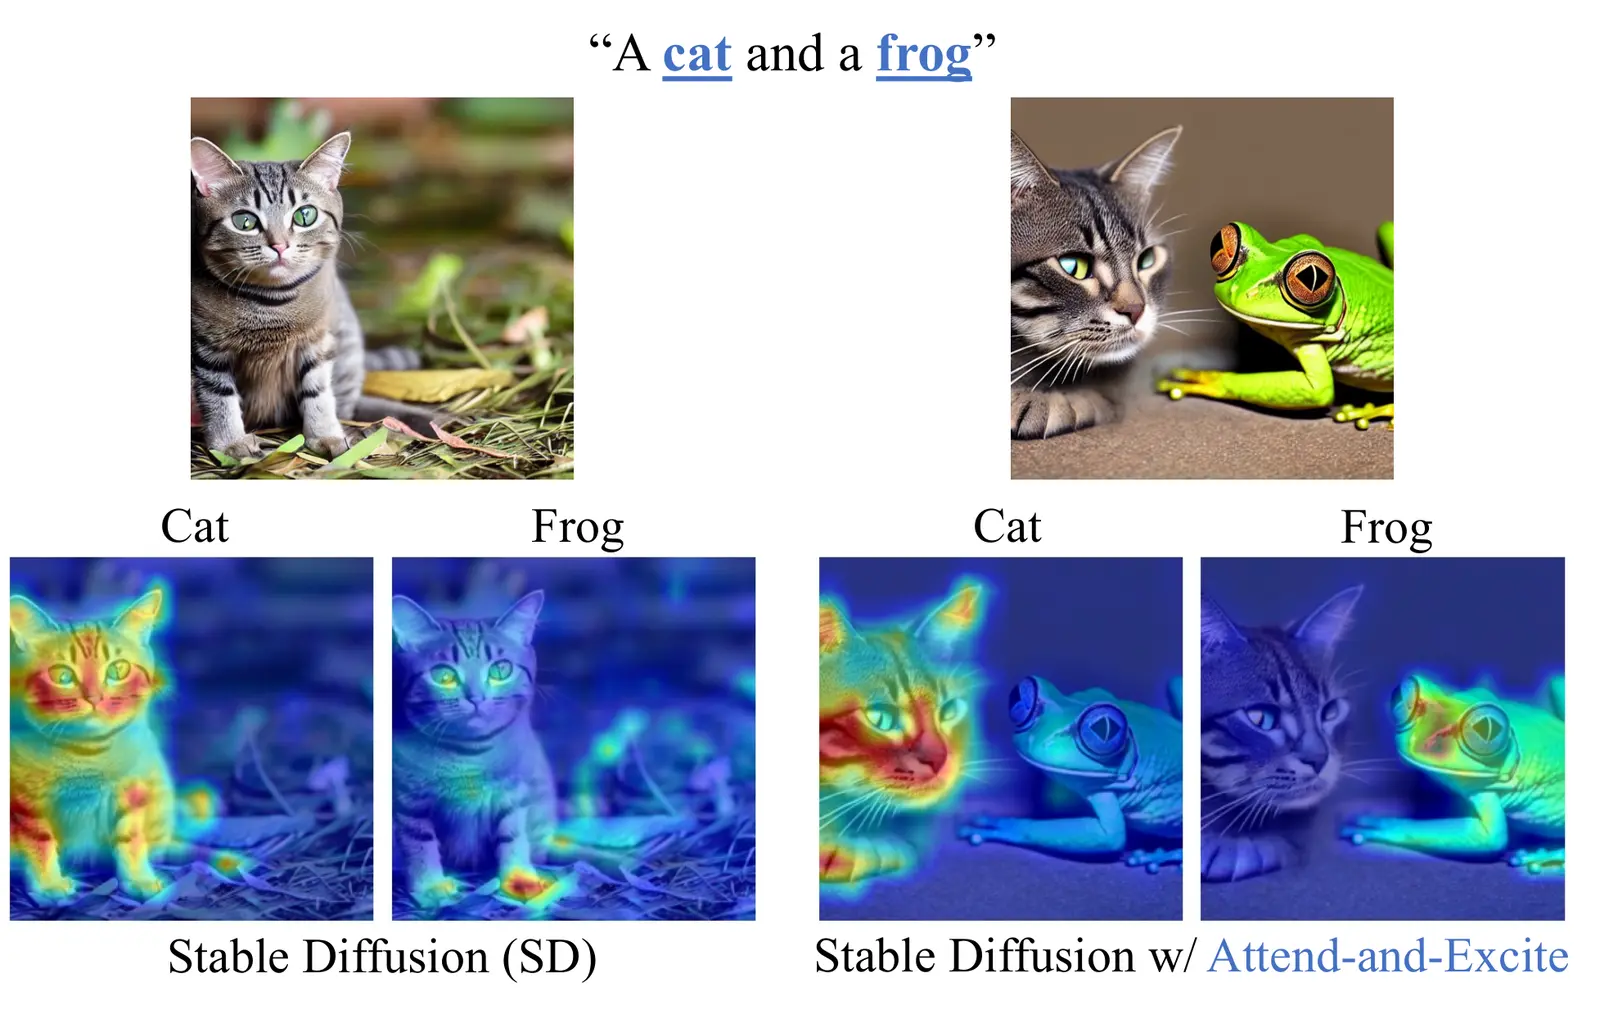
上图取自 Attend-and-Excite 论文(Vinker 等,SIGGRAPH 2023)的 Figure 4。它对同一个提示词 “a cat and a frog” 分别画出 cat 与 frog 两个 subject token 的 cross-attention 图,并把原始 Stable Diffusion 与加入 Attend-and-Excite 之后的结果并排对比。可以观察到两件事:原始 SD 中两个主体 token 的注意力分布高度重叠,或者其中一个几乎拿不到注意力;加入引导后,两个 subject token 分别覆盖画面中不同的、连通的大片区域。
这张图把组合性失败从“生成质量问题”变成了“注意力分配问题”:同样的提示词、同样的文本编码器,仅仅是去修改 latent 让注意力重新分布,就能让被忽略的主体出现。
这个现象是理解组合性问题的钥匙:问题不在词表,也不在编码器的语义能力,而在主干把某个 token 的注意力分配到了哪里。下面把常见的失败模式拆成三类。
面孔一:灾难性忽略
典型的提示词是“一个黄色的碗和一只蓝色的猫”。生成出来的图像有时只有碗,猫根本不存在;或者只有猫,碗不存在。注意上图中央区域:两个 token 都争夺同一块 patch,模型在两者里挑了得分更高的一方,另一个被 softmax 压到接近零。
数学上,这对应 cross-attention 矩阵 中某个 subject token 列的最大值过低。Attend-and-Excite 直接把这个问题写成优化目标:对每个 subject token ,强制存在至少一个 patch 对它“充分注意”:
论文的实现细节值得记下来:每一步只优化当步最大被忽略的那个 subject token(),注意力图先用 、 的高斯核平滑;只在预先选定的若干步做迭代精修,最多 20 次 latent 更新,或者直到阈值满足即停止。注意这不是训练,而是推理时的在线优化——论文报告的 A100 运行时间是:原始 SD 单图约 5.6 秒,不触发精修时约 9.7 秒,触发精修时约 15.4 秒;换 fp16 后约为 6.6 秒与 11.8 秒。也就是说,修正成功才付钱,失败越多的提示词延迟越高。
面孔二:属性泄漏
“一只红色的猫和一只蓝色的狗”,生成结果却可能变成红色的狗、蓝色的猫。这种失败不是忽略,而是绑定错误:颜色 token 与主体 token 各自都出现了,但没有绑定到同一个对象上。回到前面 InfoNCE 的分析:整段文本与整张图的对比目标,允许“红色”和“狗”落在同一侧而损失仍然很小,文本表示自然不区分“谁的颜色”。
Attend-and-Excite 论文还报告了一点:它虽然只针对忽略,但因为促使每个 subject token 在局部具备足够激活,属性绑定的错误也间接减少了。这说明绑定错误与忽略共享一部分机制。
面孔三:数量与空间关系失效
“三只猫”“左边的椅子”“倒影在右下角”。这三类要求对文本编码器最难:three 这个 token 不携带“三”这个数量在空间上如何分布的几何信息,而主干也没有计数器。因此数量常常变成“一到两只”,空间关系常常退化成“大致有这个元素”。
一种直观的解释是:空间关系问题很大程度上来自文本表征本身没有编码位置。在 CLIP 的 77 个位置里,left 是一个 token,它与 chair 在序列上的相对先后有意义,但这部分信息进入 cross-attention 后只作为 key 参与点积,主干并没有被监督去把它映射成图像中的水平坐标。再加上 CLIP 的因果注意力让每个位置的向量只看到前缀,关系词本身的表示在不同句式中还会漂移。
这里也能看到 CLIP 的位置表为什么是 77 而非更长:位置表承载的是 token 的相对顺序,而关系词的多寡不决定表的长度。
第七层:前端侧的可行对策
组合性失败的根本解法大多在训练侧(例如带绑定监督的条件训练),但那超出本文范围。前端和推理侧有三类可立即使用的对策。
分块编码:突破 77 但又保持每个块内的位置关系
对于超长提示词,可以把文本切成若干不超过 75 token 的块,分别编码后把结果拼成 长度的条件序列。关键点是:每个块重新从 SOT 开始,各自拥有完整的 77 位置表,因此块内的词序信息不会丢失,但块间的位置关系丢失。
compel 对此提供了多种模式,其中一种是把各块编码后做加权融合(对池化向量做带权求和并归一化),另一种是拼接完整序列。拼接完整序列更适合进入 cross-attention,而融合池化向量更适合 adaLN 类主干。两种都不能恢复跨块的关系词,这就是分块编码的天花板。
下面是一段与具体库无关的伪代码,把“分词、分块、加权、编码、拼接”的完整顺序写清楚。换成 diffusers 或 compel 时函数名不同,但流程一致:
def encode_prompt(prompt, tokenizer, text_encoder, weights=None, chunk_len=75, max_len=77): # 1. 分词。显式关闭截断,保留全部 token 才能发现超长 ids = tokenizer(prompt, truncation=False, add_special_tokens=False).input_ids
chunks = [ids[i:i + chunk_len] for i in range(0, len(ids), chunk_len)] or [[]]
embeds = [] for chunk in chunks: # 2. 每块重新补 SOT/EOT,并补齐到 max_len ids_chunk = [tokenizer.bos_token_id] + chunk + [tokenizer.eos_token_id] pad = max_len - len(ids_chunk) attn = [1] * len(ids_chunk) + [0] * pad ids_chunk = ids_chunk + [tokenizer.pad_token_id] * pad
# 3. 可选:在嵌入层按 token 缩放(多数实现放在编码之前) token_emb = text_encoder.get_input_embeddings()( torch.tensor([ids_chunk])) if weights is not None: w = torch.tensor(weights, dtype=token_emb.dtype)[None, :, None] token_emb = token_emb * w
# 4. 编码。CLIP 内部是因果掩码,T5 是双向注意力 out = text_encoder(inputs_embeds=token_emb, attention_mask=torch.tensor([attn])) embeds.append(out.last_hidden_state)
# 5. 沿序列维拼接;块数为 k 时条件长度变为 77k return torch.cat(embeds, dim=1)这段伪代码暴露了两个容易踩的细节:truncation=False 必须显式设置,否则很多 tokenizer 会静默截断,让你在“提示词丢了一半”时找不到原因;分块后每块都要重新补 SOT/EOT,否则编码器看到的是一段没有起点标记的句子,输出会偏移。加权向量与 token 序列等长,一旦分块,权重也要跟着按块切分,不能只按原句长度准备。
注意力引导
Attend-and-Excite 之外,还有一类方法直接对 attention 操作:
- 对 subject token 的注意力做高斯平滑,保证它在空间上是连通的区域,而不是零散的高分 patch;
- 在解码到一定步数后,冻结布局、只让细节继续去噪,防止后期注意力漂移。
这些方法的共同点是不改文本编码器,只在主干的注意力上做纠正,因此可以不额外训练直接套用。代价是增加了对注意力的读写:每步要么多一次前向,要么多一段梯度计算。
用结构化提示词替代自由描述
既然块间关系与长句依赖都难以被 77 token 的编码器稳定表达,前端就可以改变提示词的形状:用“主体 + 属性 + 场景 + 风格”的分组短句,配上加权语法分别放大关键 token。它的信息密度不一定低,但每个 token 都能落在位置表的有效范围里,每个关键概念也都有明确的注意力权重。这是当前提示词工程最常用的实用对策。
第八层:文本前端在推理服务中的成本定位
三笔固定开销
文本前端对一次请求的贡献可以被拆成三笔:
- :在 CPU 上执行,几百微秒到几毫秒量级,与提示词长度近似线性;
- :查表与位置相加,几乎可忽略;
- :编码器若干层注意力。SD1.5 的 CLIP-L 文本塔有 12 层、宽 768;T5-XXL 有 24 层、宽 4096,参数量约 47 亿。单条 512 token 的 T5 前向在 H100 上是毫秒量级,具体取决于 batch 与序列长度。
对一次 20–30 步的生成请求,文本编码的耗时占比并不高,但它有两个特殊性质:它必须在第一步去噪前完成(串行依赖),而且它常常在 CPU/GPU 之间来回(tokenize 与张量搬运)。在低延迟场景里,这两点会让它成为首字延迟的固定成分。
缓存:相同提示词不必重复编码
文本编码的输出只依赖提示词,与采样步数、种子、分辨率都无关。因此最直接的优化是把 的编码结果缓存起来。生产系统里常见的做法:
- 进程内缓存:按提示词哈希存最近若干条,命中率高时文本编码几乎消失;
- 跨请求复用:同一个风格的批量生成共用一个模板提示词,把变化部分单独编码;
- 模板化编码:把固定的系统提示词(风格、质量词)预先编码,与变化的主体词拼接。
注意缓存的是编码后的张量,不是 token。不同编码器之间不存在通用的表示,缓存也必须按编码器分别存放:SDXL 的两路输出宽度不同,不能只缓存其中一路再在推理时补齐。
批次内长度不齐时的填充策略
多条提示词一起编码时,都会 pad 到 77,因此 batch 的文本侧算力是 ,与每条提示词的真实长度无关。两端的优化:
- 短提示词走短路径:CLIP 文本塔是因果注意力,pad 位置排在末尾,它们的输出会被后续位置读取(因果掩码下第 个 pad 能看到前面的真实 token),所以不能简单跳过。真正要砍的是图像侧 cross-attention 的列:键值里与 pad 对应的列可以被 mask,但多数实现为了 kernel 形状固定仍然全量计算,收益取决于实现。
- 把文本编码挪到独立进程或独立 GPU:把它与去噪主干解耦,让主干不因文本编码等待而空转。这一点在 T5-XXL 这类大编码器上尤其明显。
文本编码与 VAE 共享显存时的峰值
SDXL 的两个文本编码器权重(bigG 约 6.9 亿、CLIP-L 约 1.2 亿)在 bf16 下合计约 1.6 GB,T5-XXL 的 bf16 权重约 9.5 GB。它们通常需要常驻显存,否则每次请求都要从 CPU 搬入一次,延迟不可接受。因此在显存预算有限时,文本编码器与 VAE 的驻留策略需要一起规划。
文本编码器也能被量化
文本编码器在推理服务里常驻显存,对它的量化往往被忽略,但它和主干一样面临低比特的取舍。文本编码器的权重很小、激活集中在少数通道,INT8 量化通常是安全的;更低比特(INT4 或 FP4)在编码器上的误差会被放大到条件向量层面,再经过几十步去噪被逐步放大。所以服务侧的常见做法是:主干积极量化,文本编码器保守量化,或者把它放在独立进程里用更高精度跑。
第九层:从编码器到条件通路——三条注入通路如何消费文本
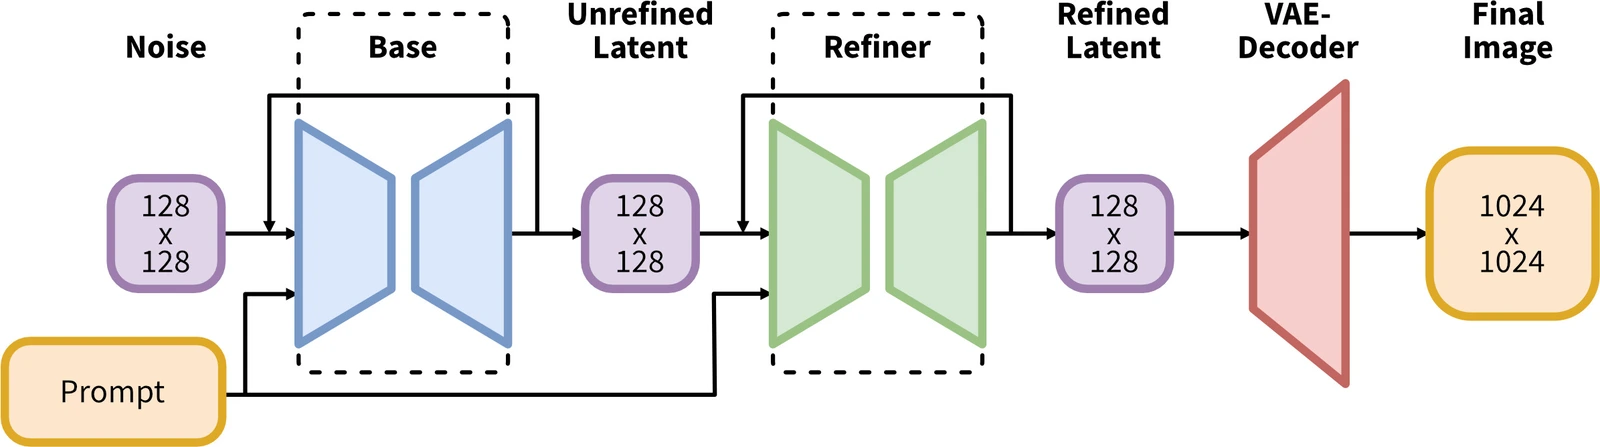
上图是 SDXL 论文 Figure 1 右半部分的精修流程:噪声进入 Base 模型,产出 128×128 的未精修 latent;Refiner 以这个 latent 为输入再做一轮去噪,得到精修后的 latent,最后统一经 VAE 解码器得到 1024×1024 的图像。也就是说,VAE 解码只发生在末端一次,而条件通路在两阶段里各走一遍。
这张图对文本前端有两点含义。第一,Base 与 Refiner 各自消费一份文本条件,两个模型的权重不同,对条件表示的使用方式也不同;在公开实现里,Base 使用两路拼接后的条件,Refiner 只使用 bigG 这一路(序列加池化向量),所以“两路编码器”并不等于“两阶段各用一路”,缓存也要按模型区分:Base 需要两路拼接,Refiner 只需要第二路。第二,文本编码本身只做一次(每个编码器一次),但条件通路的前向在每一步去噪里都要重算,真正贵的是后者,而不是前端那一次编码。
前面第四篇讲过三条注入通路的区别,这里回到文本表示本身给出对照:
| 注入通路 | 消费什么 | 对文本表示的要求 |
|---|---|---|
| cross-attention | 完整 token 序列 | 每个 token 自带位置顺序,需可被局部查询 |
| adaLN 调制 | 池化向量 | 只需全局摘要,不关心顺序 |
| MMDiT 联合注意力 | 序列进入共享注意力 | 需要与图像 token 同构的表示 |
从这张表能看出,文本编码器的输出形状直接决定了它能不能接某条通路。把 CLIP 的池化向量接到 cross-attention 上会丢掉空间绑定能力;反过来,把 T5 的完整序列接到只接受池化向量的主干上则会被丢弃。SD3 和 Flux 都选择了“CLIP 池化 + T5 序列”的组合,正是因为它同时满足 adaLN 与联合注意力两种消费方式。
第十层:从 77 到 512,提示词长度的演进说明了什么
三个里程碑
- 77(2021–2022):CLIP 位置表的产物,稳定扩散 1.x/2.x/XL 沿用;
- 512(2024):Flux 与 SD3 的 T5-XXL 分支,相对位置偏置与长序列训练,让长描述可行;
- 更长的提示词(2025 之后):视频与音频扩散把文本条件拉长到几百甚至上千 token,以便描述时序动作与场景结构。
每一次长度提升都伴随一个结构变化:从可学习绝对位置表换成相对位置偏置,从单编码器换成多编码器,从固定形状条件换成可变形状条件。代价则是主干的 cross-attention 形状不再固定、CUDA Graph 捕获更难、批内打包更复杂。这条权衡线在第九篇和第八篇里都出现过,只是站在文本前端这一侧看,它的入口是 tokenizer 与位置表。
长条件对推理成本的影响
把 77 拉到 512,对主干不是小改动。cross-attention 每层要做两件乘法: 算出 的注意力矩阵,再与 相乘得到输出。两件事合计的乘加量约为 ,其中 从 77 涨到 512,这一项增加约 6.6 倍();对 的 1024 图像,Key 与 Value 的存储同步增加,显存占用随之上去。所以“支持长提示词”不是免费的,它在注意力上按 线性地加了成本,而且这部分成本每一步去噪都要付一次。
工程排查清单:文本条件出问题时先看这几处
- 提示词是否被截断:用与模型一致的 tokenizer 数一遍 token,确认关键要素是否落在前 75 个之内;
- 是否出现填充参与注意力:检查 cross-attention mask 是否真的屏蔽了 pad 位置,尤其是批量推理时;
- 两路编码器是否都正确加载:SDXL 少一路编码器时不会报错,但条件退化为一半;
- 加权语法生效在哪一步:确认权重是在嵌入空间混合还是靠重复文本实现,两者在长提示词上行为不同;
- 负向提示词是否超出上限:长负向提示词同样会截断,被压制的元素可能根本不在负向文本里;
- 调度器与编码器是否匹配:蒸馏模型、换绑定的编码器都会要求对应的调度器与引导参数一起调整,这在第七篇提过,文本侧同样适用。
与站内其他扩散工作如何衔接
- 文本条件注入后如何影响采样:第四篇的 cross-attention 与 MMDiT 是它的下游;
- 引导强度的作用:第十三篇的 CFG 与本文的加权语法属于同一个“放大条件信号”的空间,但作用位置不同;
- 条件控制网:第十五篇的 ControlNet 与 T2I-Adapter 是在文本条件之外再加一路空间条件,两者可以叠加,但会在主干里争夺注意力预算;
- 扩散模型的基础入门:第一篇从 DDPM 的加噪与去噪讲起,本文的文本前端是它条件化的入口。
小结
- 扩散模型的文本条件来自文本编码器,CLIP 文本塔的 77 个位置是训练分布与可学习位置表的产物,不是架构硬约束;
- 77 带来固定长度的条件形状,好处是形状恒定、易于批处理与 CUDA Graph,代价是填充税与截断损失;
(word:1.3)这类加权在数学上等价于把对应 token 的注意力 logit 乘以系数,在 softmax 竞争下是重新分配而不是单向增加;- 组合性失败(忽略、属性泄漏、空间关系失效)的根源一部分在 CLIP 的整图级对比目标,一部分在主干没有绑定监督;推理侧可用分块编码、注意力引导与结构化提示词缓解,但根解在训练侧;
- 文本前端对延迟贡献不大,但对首字延迟与显存预算有固定影响,缓存编码结果是最直接的优化。
到这里,扩散模型的基础部分已经完成:数学机制、主干结构、条件注入、采样与加速、文本前端。后续如果继续展开,可以走向视频与音频里的跨模态条件,或者走向更底层的推理框架实现。
参考资料
- Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Classifier-Free Diffusion Guidance
- Scalable Diffusion Models with Transformers (DiT)
- Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis
- Attend-and-Excite: Attention-Based Semantic Guidance for Text-to-Image Diffusion Models
- Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (SD3)
- High-Resolution Image Synthesis with Latent Diffusion Models
- Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (T5)
- OpenAI CLIP 官方仓库
- compel:提示词加权前端实现
- Applying Guidance in a Limited Interval Improves Sample and Distribution Quality in Diffusion Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



