推理优化 Benchmark
636 字
3 分钟
推理优化 Benchmark
大家好,我是芯缘,是 Datawhale 社区发起的 “llm-algo-leetcode 推理优化方向”组队学习活动的助教。
- 2026年8月运营助教
- 2026年9月专业助教
Benchmark 和 Metrics
Benchmark :测试对象 + 测试场景/负载 + 评价指标
Metrics :评价指标
Metrics
| 指标 | 全称 | 注释 |
|---|---|---|
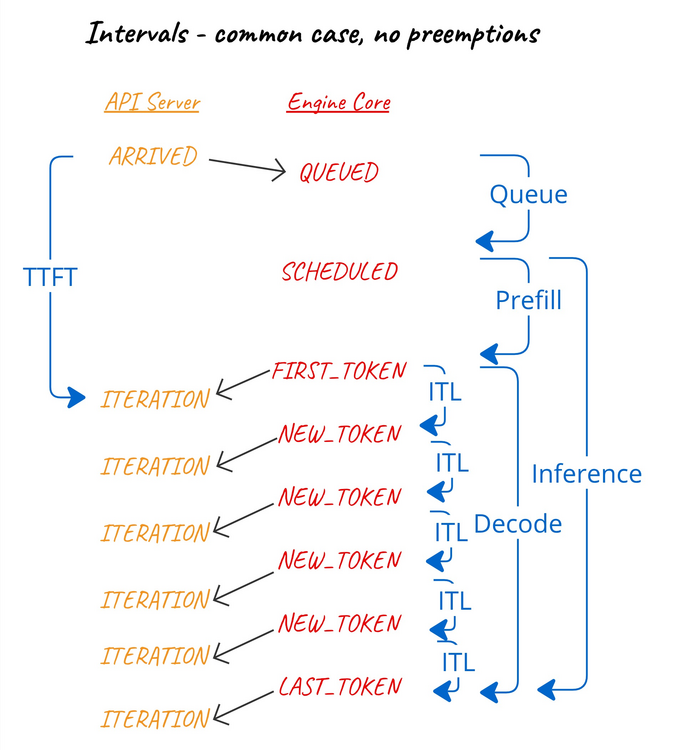
TTFT | Time To First Token | 主要受排队、tokenization、prefill 和 prompt 长度影响。 |
TPOT | Time Per Output Token | 主要看 decode。 |
ITL | Inter-Token Latency | 可观察流式输出抖动。 |
throughput | Throughput | tokens/s、requests/s。 |
peak memory | Peak Memory Usage | 常由权重和 KV Cache 决定。 |
P50 / P95 / P99 | Percentile Latency | 延迟分位数,P50 看典型请求,P95/P99 看尾部慢请求。 |
Preempted
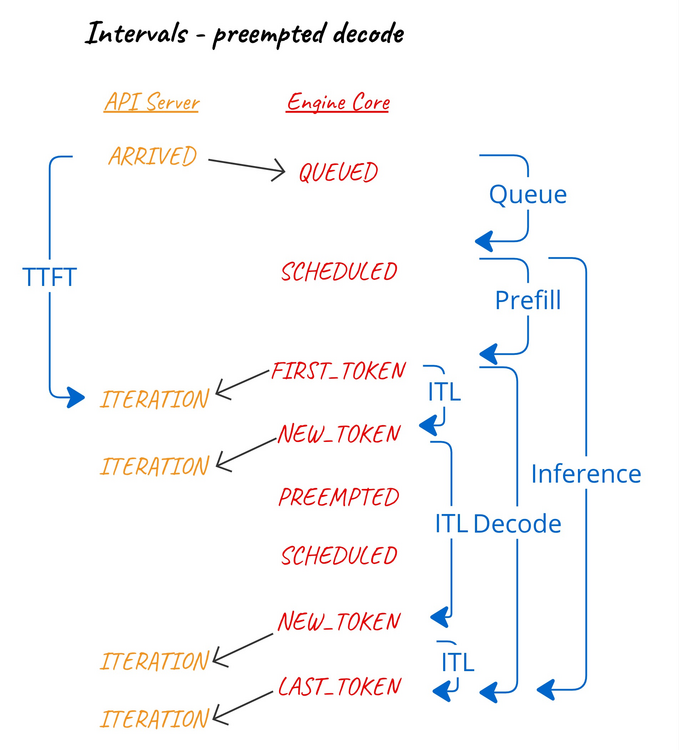
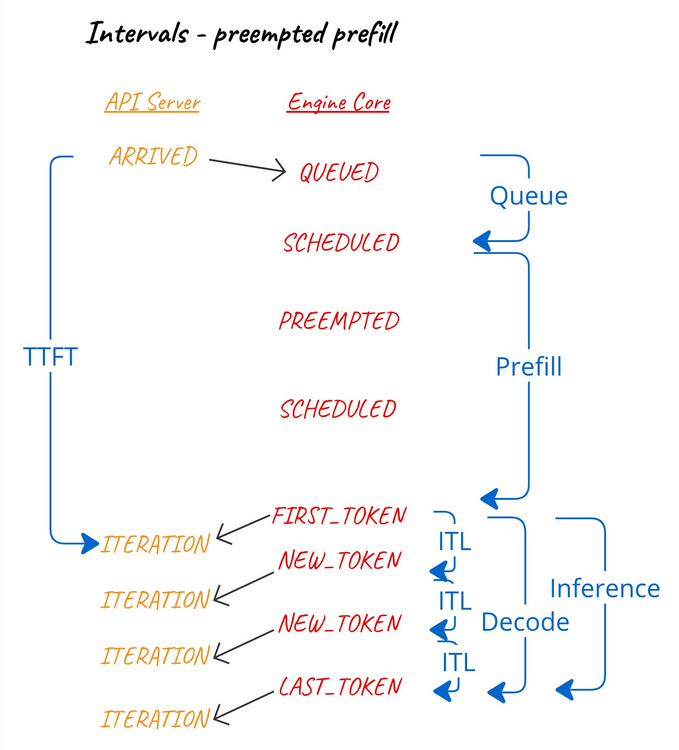
Preempted 指请求执行中被抢占,重新放回等待队列,之后再被调度。常见原因是 KV Cache 不足、并发/batch 过大、长短请求混合导致调度压力上升。
decode 阶段被抢占时,已生成 token 可复用,但会拉长 ITL、decode 和 inference 时间:
prefill 阶段被抢占时,主要影响 TTFT 和 prefill 时间:
分析
| 问题 | 原因分析 | 措施 |
|---|---|---|
长 prompt 使 TTFT 升高 | prefill 计算量随输入长度增加,排队也可能变长。 | 裁剪 prompt;RAG 去重/rerank;启用 prefix caching;启用 chunked prefill;优化 Attention kernel。 |
TPOT 高 | decode 逐 token 生成,容易受 KV Cache 访存和调度影响。 | 调整 batch/并发;使用 continuous batching;优化 KV Cache dtype;缩短输出;尝试 speculative decoding。 |
ITL 抖动大 | 长短请求混批、preemption、CPU 后处理或网络缓冲导致 token 间隔不稳。 | 长短请求分队列;限制超长请求;监控 preemption;减少同步日志和代理缓冲。 |
| throughput 低 | batch 太小、并发不足、CPU tokenization 或调度开销较高。 | 提高并发;增大 batch;异步压测;tokenization 并行化;profiling 区分 CPU/GPU 瓶颈。 |
| throughput 高但延迟变差 | 合批提高产出,但排队和尾部延迟上升。 | 区分在线/离线实例;限制队列等待;按长度分桶;用 P95/P99 做约束。 |
| peak memory 接近上限 | 权重、KV Cache、长上下文和高并发占用显存。 | 量化权重;降低 max model len/max num seqs;使用低精度 KV Cache;限制输出长度;扩容显存。 |
| preemption 频繁 | KV Cache 或调度资源不足。 | 降低并发/batch;缩短上下文;提高 cache 复用;按长度分桶;扩容实例。 |
| P99 明显升高 | 排队、抢占、系统抖动或个别超长请求影响尾部延迟。 | 画 P50/P95/P99 曲线;设置超时;隔离长任务;监控 waiting、KV Cache、preemption。 |
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
相关文章智能推荐
1
llm-algo-leetcode 推理优化笔记
llm-algo-leetcode 推理优化Datawhale llm-algo-leetcode 推理优化课程的笔记导航页,汇总本系列各 Task 的学习笔记(GPU 架构与内存、KV Cache 优化技术等)。
2
KV Cache 与优化技术
llm-algo-leetcode 推理优化KV Cache 内存计算与优化技术:MHA/MQA/GQA/MLA 注意力架构、KV Cache 量化、Sliding-Window Attention、StreamingLLM、PagedAttention、Prefix Caching、CPU Offloading。Datawhale llm-algo-leetcode 推理优化课程 Task 1-2 笔记。
3
推理结构地基
llm-algo-leetcode 推理优化Datawhale llm-algo-leetcode 推理优化课程 Task 0(Attention MHA 与 GQA)学习笔记,正在完善中。
4
KV Cache 与推理服务内存管理
llm-algo-leetcode 推理优化KV Cache 与推理服务内存管理:vLLM PagedAttention、SGLang RadixAttention、Prefix Caching 与 Chunked Prefill。Datawhale llm-algo-leetcode 推理优化课程 Task 3 笔记。
5
Roofline Model
llm-algo-leetcode 推理优化Roofline Model 的基本概念、Arithmetic Intensity、memory-bound / compute-bound 判断,以及 GEMM、FlashAttention、算子融合等常见优化方向。
随机文章随机推荐
评论区
--
总访问量
--
访客数
音乐
暂未播放
0:000:00
文章
190
分类
26
标签
265
总字数
2,145,681
运行时长
0 天
最后活动
0 天前